
UBC · 临床文档的提取与分析 · 模块一第二课 / NLP010
NLP 在 BC 癌症登记处:从病理报告流水线到隐私保护
不列颠哥伦比亚省癌症登记处(BC Cancer Registry,简称 BCCR)每年要收到 100 多万份病理报告。靠人工读完不可能,原来依赖的规则软件又错得太多。在 UBC 课程“临床文档的提取与分析”的这一课里,BCCR 的研究科学家 Lovedeep Gondara 讲了登记处怎样搭起一条 NLP 流水线来读这些报告,以及为什么在用它们训练任何模型之前,必须先把病人的身份信息拿掉。这篇笔记是我对这个案例的整理。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
可报告肿瘤
国家和国际登记规则要求登记处收集的肿瘤,比如乳腺癌、肺癌、结直肠癌。有些癌症不需要报告,比如长在小腿上的基底细胞癌。
集成模型与 LLM 裁决
几个小模型各读报告的一部分并投票。足够多的模型意见一致就采用;意见不一时,由大语言模型读完整份报告和各模型的判断,做最终决定。
差分隐私
训练时加入可控噪声,让数据里有没有某一个人,输出几乎没有差别。它有理论上的保证,代价是准确率会下降一些。
数据匿名化
训练前把身份信息(姓名、健康号、出生日期、电话等)从文本里去掉,模型就没有个人信息可记、可泄露。
全景图:癌症登记处的 NLP 与隐私规则
从左上角开始:病理报告是登记处的主要来源,下面是 NLP 适合做的任务。绿色大括号说明旧的规则系统为什么出错,橙色大括号和小灯泡列出三条新流水线。左下角的紫色一行是我得到的实用思路:简单的方法先上。右半边讲隐私:大模型会记住并泄露训练数据,所以有两道防线,差分隐私和数据匿名化,蓝色的三层就是登记处给报告做匿名化的办法。右下角是我的思考。
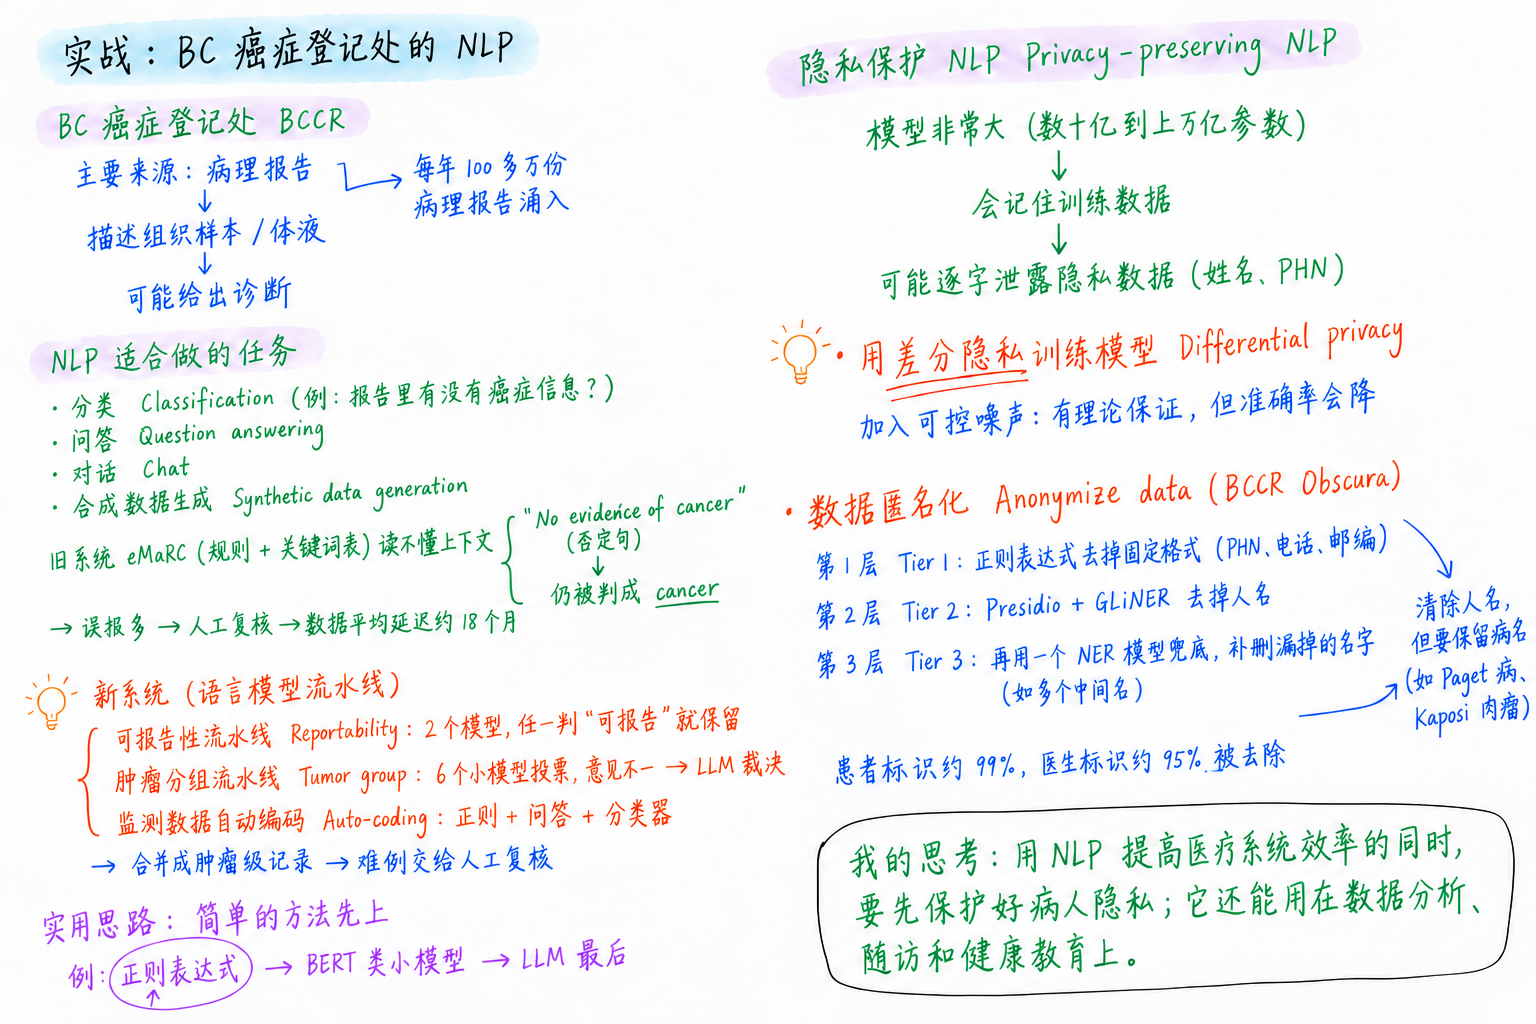
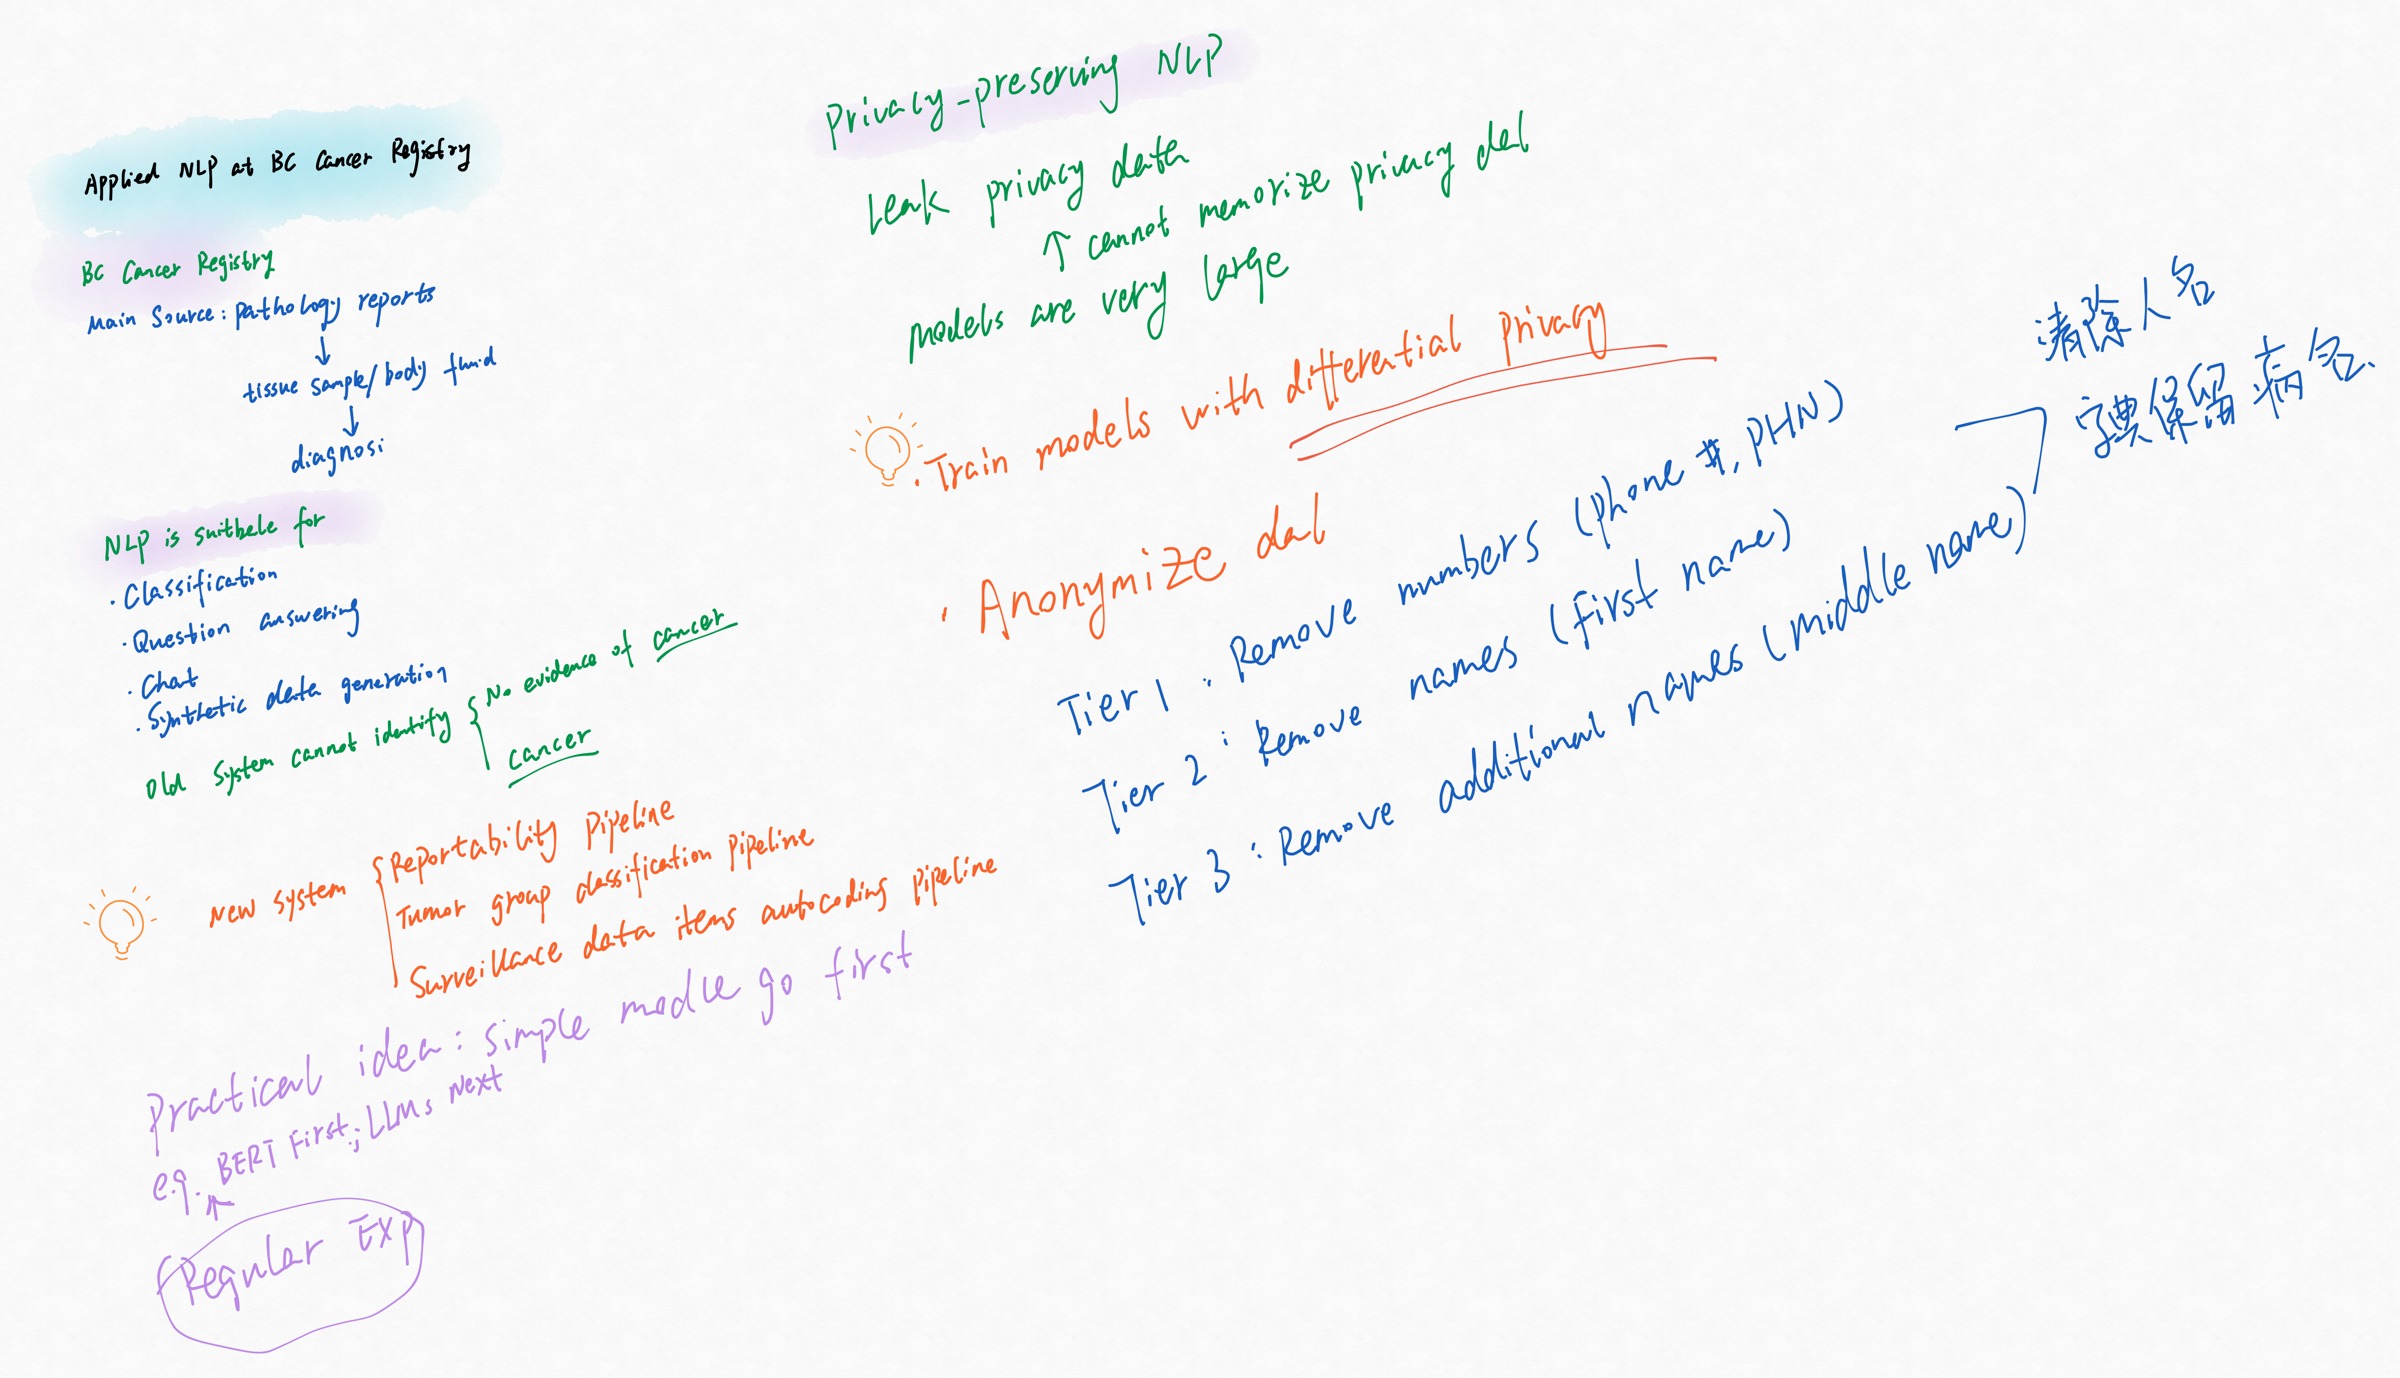
根据我的手写笔记整理,修正了几处术语,并补充了简短的例子。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
登记处和它的病理报告
BCCR 是一个覆盖全省人口的集中式登记处:它的职责是收集 BC 省居民所有“可报告”肿瘤的数据,每年约 3 万个肿瘤,并随人口增长而增加。和世界上大多数癌症登记处一样,它确认病例的主要来源是病理报告:描述组织样本或体液特征的医疗文件,可能给出诊断,也可能不给。
一份病理报告有三种用途:
| 用途 | 谁来读 | 用来做什么 |
|---|---|---|
| 临床 | 开检查或做操作的医生 | 诊断和制定治疗方案 |
| 运营 | 登记处 | 收集数据,支持决策、规划未来需求 |
| 研究 | 研究人员 | 圈定研究人群,比如按雌激素受体(ER)、孕激素受体(PR)和 HER2 状态筛选乳腺癌患者 |
报告里还有大量个人信息:病人的姓名、个人健康号(PHN)、地址和电话,医生的姓名、注册号和联系方式。这一点和笔记的后半部分有关。
Gondara 把 NLP 定位为机器学习的一个分支,而机器学习又是 AI 的一部分。NLP 近几年的大进步主要来自预训练模型:先在海量通用文本上训练(想象一下整个维基百科加 PubMed),再用一小份领域数据为某个任务做微调,比如根据病理报告预测诊断。这种做法提升了很多任务:分类(这份报告有没有癌症信息?)、基于给定上下文的问答、对话,以及数据生成,比如为某种疾病特征生成合成的病理报告。
为什么规则不够用
登记处接收全省的病理报告数据流:每年 100 多万份,癌症和非癌症的都有。从 2020 年起,它使用美国疾病控制与预防中心(CDC)的免费软件 eMaRC Plus。eMaRC 是基于规则的:它维护一张张术语表(腺癌、癌等),报告里出现表中的词,就判为癌症。
在癌症报告里,登记处还要分出可报告肿瘤,也就是国家和国际登记规则要求收集的肿瘤(乳腺癌、肺癌、结直肠癌等大多数主要肿瘤),和不可报告的肿瘤,比如长在小腿上的基底细胞癌。
规则读不懂上下文。病理医生可能写:“我复核了这份样本,未见癌症证据(no evidence of cancer)。”eMaRC 看到“cancer”就判为阳性,它没法把“no evidence”和后面的词连起来理解。后果一环扣一环:
- 复杂文本上错误率很高。
- 每个分类结果都要人工复核,登记处本就不多的专业人员压力很大。
- 数据出得晚:平均延迟 18 个月,2023 年的数据要到 2025 年中后期才能用,对研究来说太慢。
深度学习模型不依赖人工设计的规则,还能利用长得多的上下文。它们能做得更好吗?Gondara 的回答是:能。
一份报告走过的流水线
BCCR 已经开发并部署了多条 NLP 流水线。一份报告依次经过:
- 第一道筛选,eMaRC:判断报告里有没有癌症信息。它在这一步表现还不错,因为它“宁可多报”:假阳性很多,以尽量少漏掉癌症。
- 预处理:去掉报告的页眉,那里主要是病人和医生的身份信息;根据项目需要,只保留有用的段落,比如诊断部分和标本部分。
- 匿名化:用语言模型和正则表达式去掉剩下的身份信息(见本文后半部分)。
- 可报告性判断:把 eMaRC 放过来的不可报告肿瘤和非癌症报告剔除。
- 肿瘤分组:给每份报告分配一个大致的肿瘤类别(肺、乳腺、前列腺、结直肠、黑色素瘤、神经内分泌肿瘤等),这样工作才能分给专攻该类肿瘤的登记编码员。
- 自动编码:从每份报告里抽取监测数据字段。
- 合并:一个人可能有多份报告指向同一个肿瘤,比如几个月内的多次活检和检查。上面每条流水线都是按报告做判断,但登记处收集的是肿瘤级数据,所以要把这些报告合并成一条肿瘤记录。
- 人工复核:模型可能做得不好的病例交给人来看,这是“人在回路”(human-in-the-loop)的设计,之后数据才进入登记库。
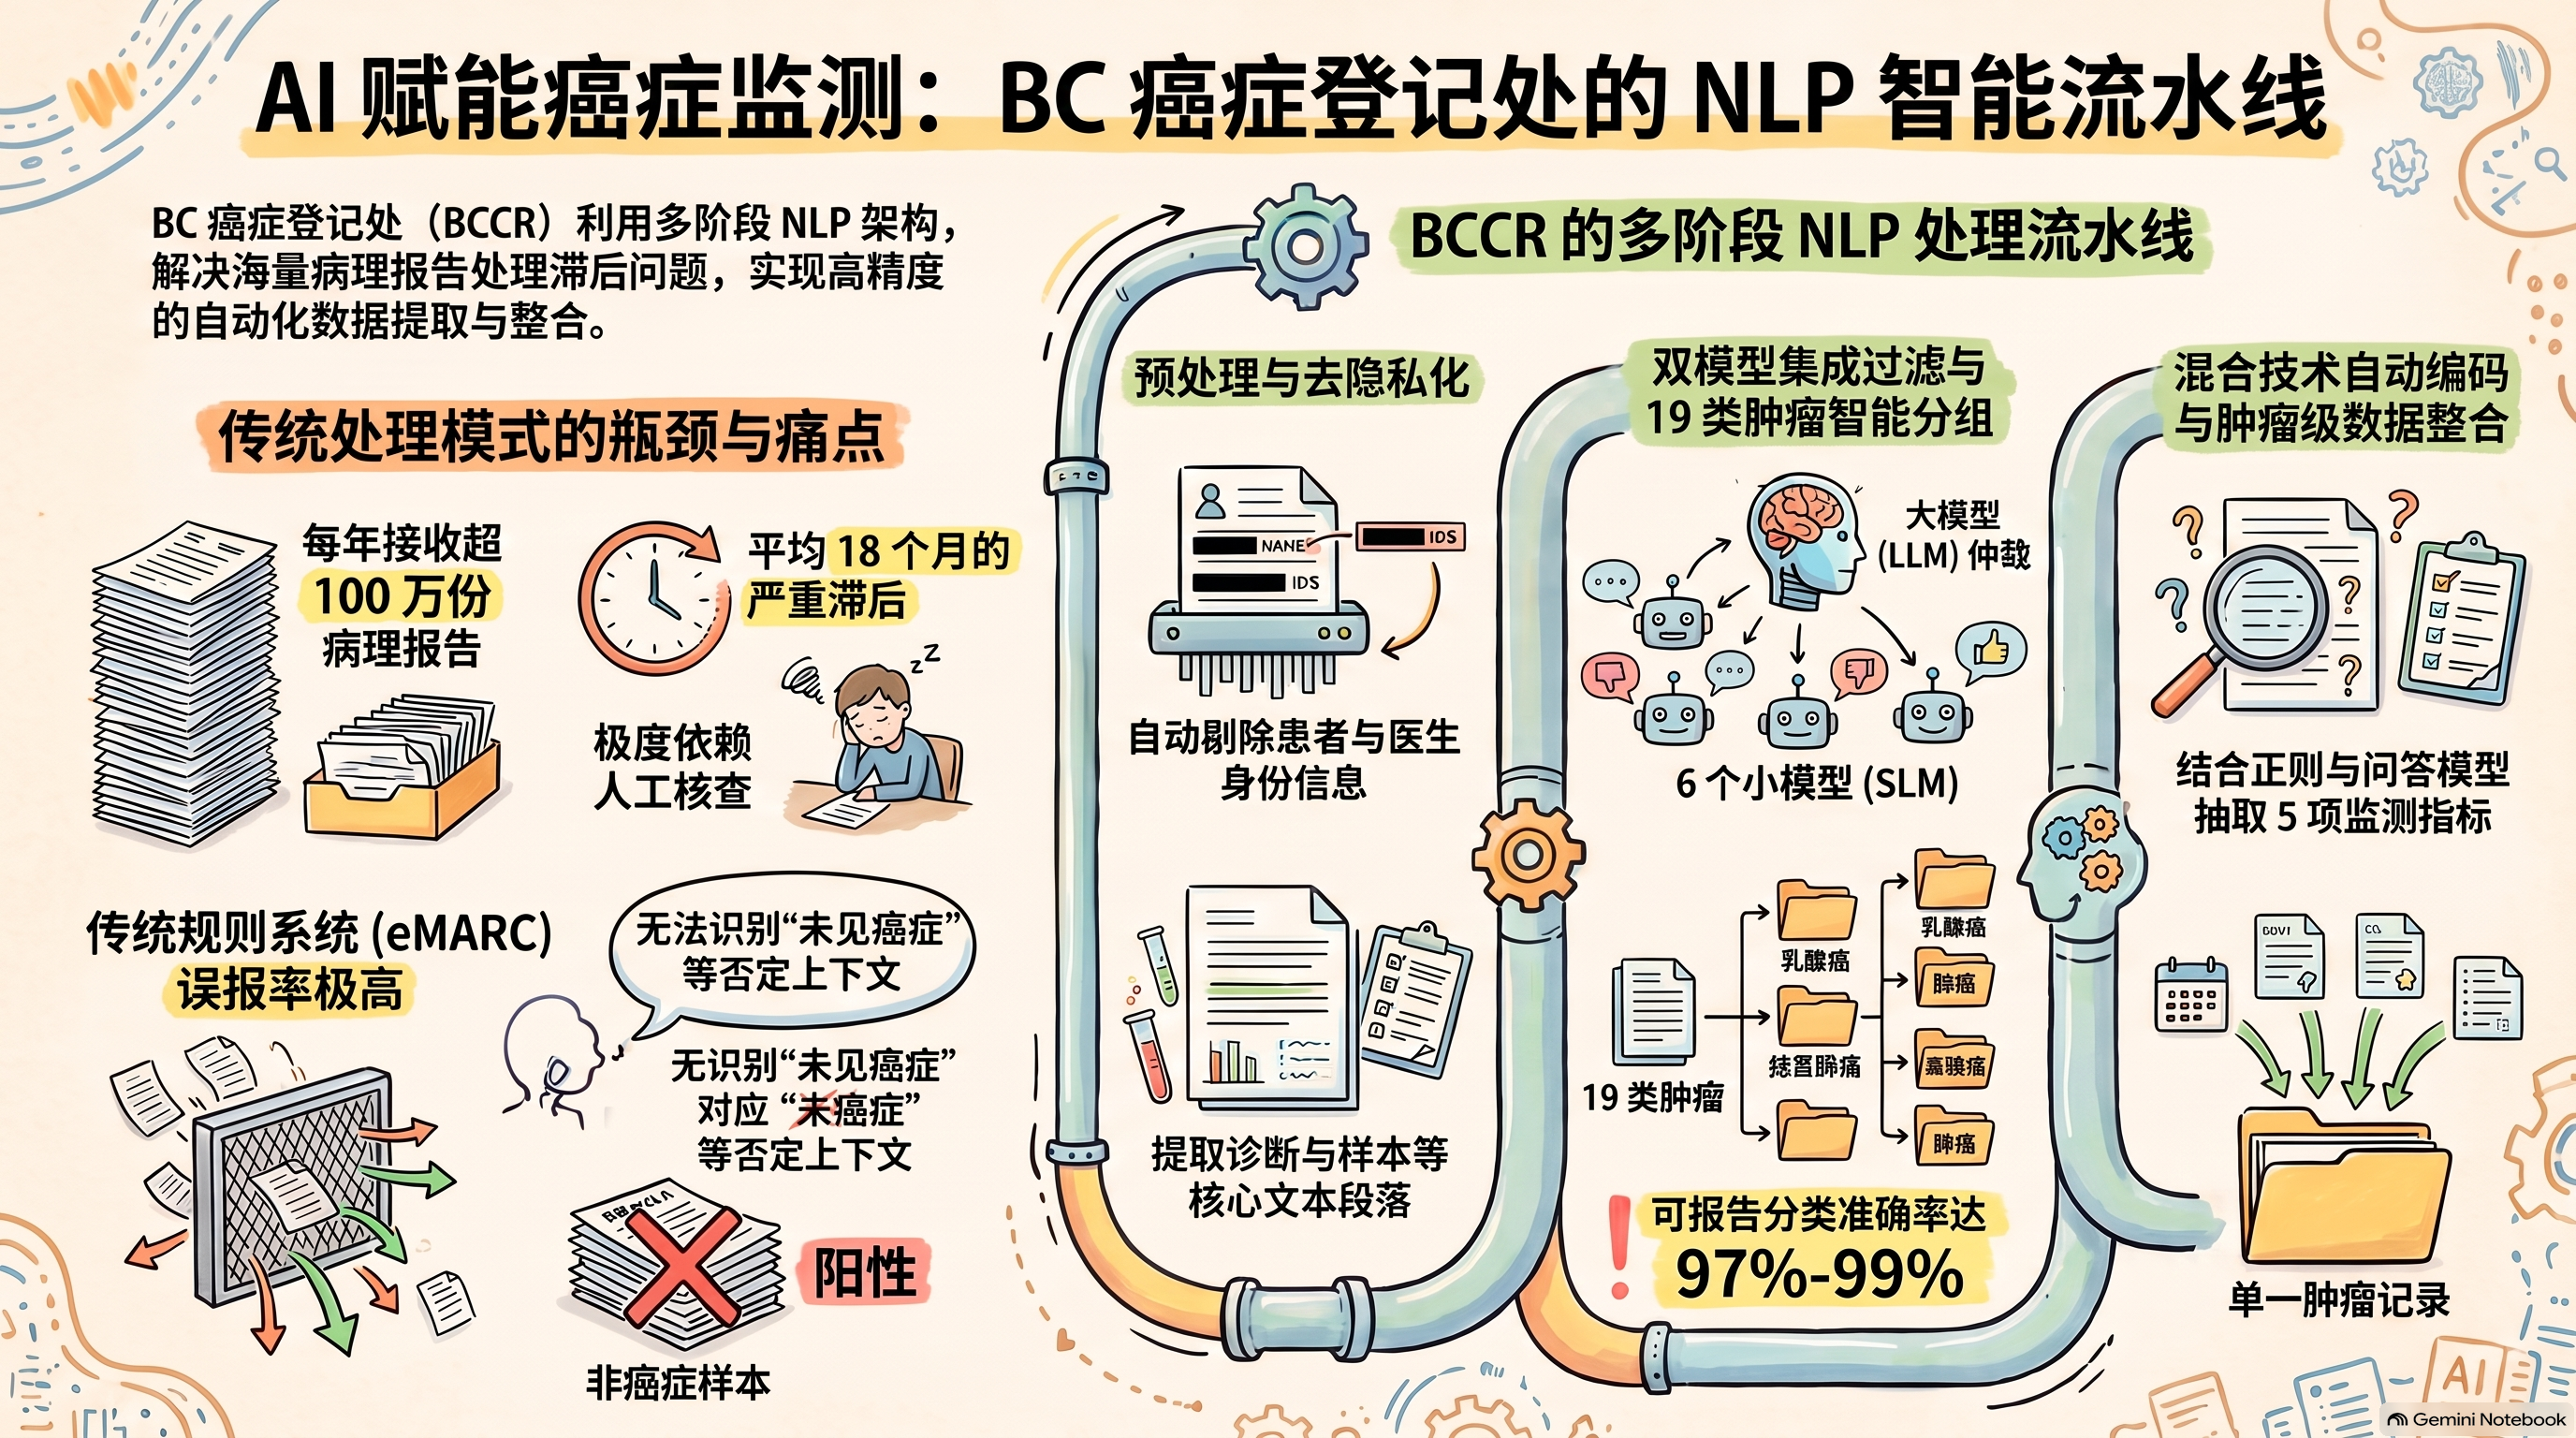
读图提示:左下角对话框下面那句话和右下角几个肿瘤文件夹的名称出现了乱码,可以忽略;“可报告分类准确率达 97%–99%”指的是可报告肿瘤,不可报告肿瘤的准确率在 90% 以上。
每一步选对工具
这一课最打动我的,是每条流水线怎样挑工具。Gondara 用了一句俗语:手里只有锤子,看什么都像钉子。登记处可以用 LLM,但不想在不需要的地方滥用它。
| 流水线 | 任务 | 怎么做 |
|---|---|---|
| 可报告性 | 可报告还是不可报告(二分类) | 两个微调过的语言模型,各读报告的不同部分。只要有一个判为可报告,就算可报告,确保不漏掉可报告肿瘤。准确率:可报告肿瘤约 97%–99%,不可报告肿瘤 90% 以上 |
| 肿瘤分组 | 19 个肿瘤类别之一 | 6 个 BERT 类小模型(每个只能读约 512 个 token):3 个读报告开头,3 个读结尾。它们投票,足够多的模型同意就采用这个类别;不然就请大语言模型读完整份报告和 6 个模型的判断,做最终决定 |
| 自动编码 | 肿瘤行为(良性、原位、浸润)、侧别、部位、组织学等;是否提到新辅助治疗;是否有补充报告(addendum) | 一套组合:简单的模式用正则表达式(“right breast”“left lung”),报告提到了什么用问答模型(报告里有没有写 ER 状态?),更难的标签用语言模型分类器 |
| 合并 | 从报告级数据到肿瘤级数据 | 不用 NLP:用普通代码写的业务逻辑,比如两份报告落在某个时间窗内时,哪一项优先 |
肿瘤分组最能说明为什么要分层设计。报告在哪里写明肿瘤类别并不固定:开头、结尾、中间,或者写得很含糊。标本可能取自乳腺,检查的却是鳞状细胞癌或黑色素瘤,和乳腺癌毫无关系。上下文窗口短的小模型只能看到报告的一部分,所以能读完整份报告的大模型留给它们意见不一的情况。在发表的版本里,6 个模型中不到 5 个意见一致时,大模型才出场。
我从这里得到的实用思路:简单的方法先上。模式能解决的用正则表达式,然后是 BERT 类分类器,LLM 留到最后,处理剩下的难题。每一步都比后一步更便宜、更快,也更容易检查。
模型会泄露训练数据吗?
病理报告里满是个人身份信息。任何一项泄露都可能导致身份被盗用或伪造;未经授权获取这些信息,也违反隐私法,比如 BC 省的《个人信息保护法》(PIPA)和加拿大联邦的 PIPEDA,就像美国有 HIPAA。而诊断或预后模型根本不需要病人或医生的名字,它需要的是报告里描述样本、描述病理医生所见的那部分。
那么,如果我在自己的服务器上用未匿名化的原始报告训练模型,只把训练好的模型分享出去呢?模型不过是一堆矩阵、一堆数字而已。研究表明不是这样:大模型会泄露训练数据,有时是逐字泄露。用客服记录训练的模型可能吐出客户的姓名和电话;用健康档案训练的模型可能原样吐出病人的姓名、PHN 和地址。研究人员已经从 ChatGPT 这样的生产级模型里提取出了数 GB 的训练数据。把这样的模型开源,任何人都可以下载下来,用提问的方式把数据套出来。
为什么会这样?因为太大。生物统计里的一个逻辑回归模型可能只有四五个参数,超过十个就会有人质疑参数太多;而今天最大的模型参数超过一万亿。参数这么多,模型就能记住训练时见过的部分内容,包括敏感信息。
两道防线:差分隐私与数据匿名化
安全地分享模型,主要有两条路:
| 差分隐私(DP) | 数据匿名化 | |
|---|---|---|
| 思路 | 改变训练方式:加入可控的噪声,让任何一条记录都无法被认出 | 改变数据:训练前就去掉要保护的信息。什么都不留,就没有什么可泄露 |
| 优点 | 隐私程度可以调;保证是理论上的,无论攻击者算力多强都成立 | 现在就实用;对大多数任务来说,身份信息本来就帮不上诊断 |
| 代价 | 隐私与效用的权衡:隐私越强,噪声越多,模型越不准 | 必须找全每一个身份信息;没有理论保证 |
正式定义比较两个相邻数据集 D 和 D′,它们只差一条记录,也就是一个人。如果对任意一组输出 S,都有 P[M(D) ∈ S] ≤ eε · P[M(D′) ∈ S] + δ,就说机制 M 满足差分隐私。ε 和 δ 越小,两边的输出越相似,攻击者就越无法判断某一个人在不在数据里。差分隐私已经用在日常生活中:手机发回给苹果或谷歌的部分数据就是这样保护的。课上重点讲匿名化,因为它在今天更实用。
BCCR Obscura:三层匿名化
要去掉的有:病人和医生的姓名、PHN、出生日期,以及任何单独或与其他信息组合后能认出一个人的数据,比如病例号、病历号。登记处自己开发的工具 BCCR Obscura 分三层来做:
| 层 | 方法 | 去掉什么 |
|---|---|---|
| 第 1 层 | 先做预处理(去掉特殊字符、转成小写),然后只用正则表达式 | 一切有固定格式的信息:PHN、医生编号、电话、邮编 |
| 第 2 层 | 微软的开源框架 Presidio(专门用来识别和移除敏感信息),配合 GLiNER 命名实体识别(NER)模型 | 大部分病人和医生的姓名 |
| 第 3 层 | 再用 spaCy(另一个基于深度学习的 NER 工具)兜底 | 第 2 层漏掉或只删了一部分的名字,比如很长的名字,或有两三个中间名的名字 |
有两个细节让它适合病理报告。Obscura 保留了一份以人名命名的疾病词典,比如 Paget 病、Kaposi 肉瘤,这样删人名时不会把诊断也删掉。它还保持报告的结构不变,因为下游的流水线要依赖这个结构。它能处理任何文本文件,包括登记处主要接收的 HL7(Health Level Seven)格式。
效果:病人标识信息去除率接近 99%,医生标识信息约 95%。这是由人工逐份检查几百份匿名化后的报告、记下残留了什么信息得出的。用一台带 RTX 4090 这类显卡的台式机,每小时能处理 1 万到 1.5 万份报告。
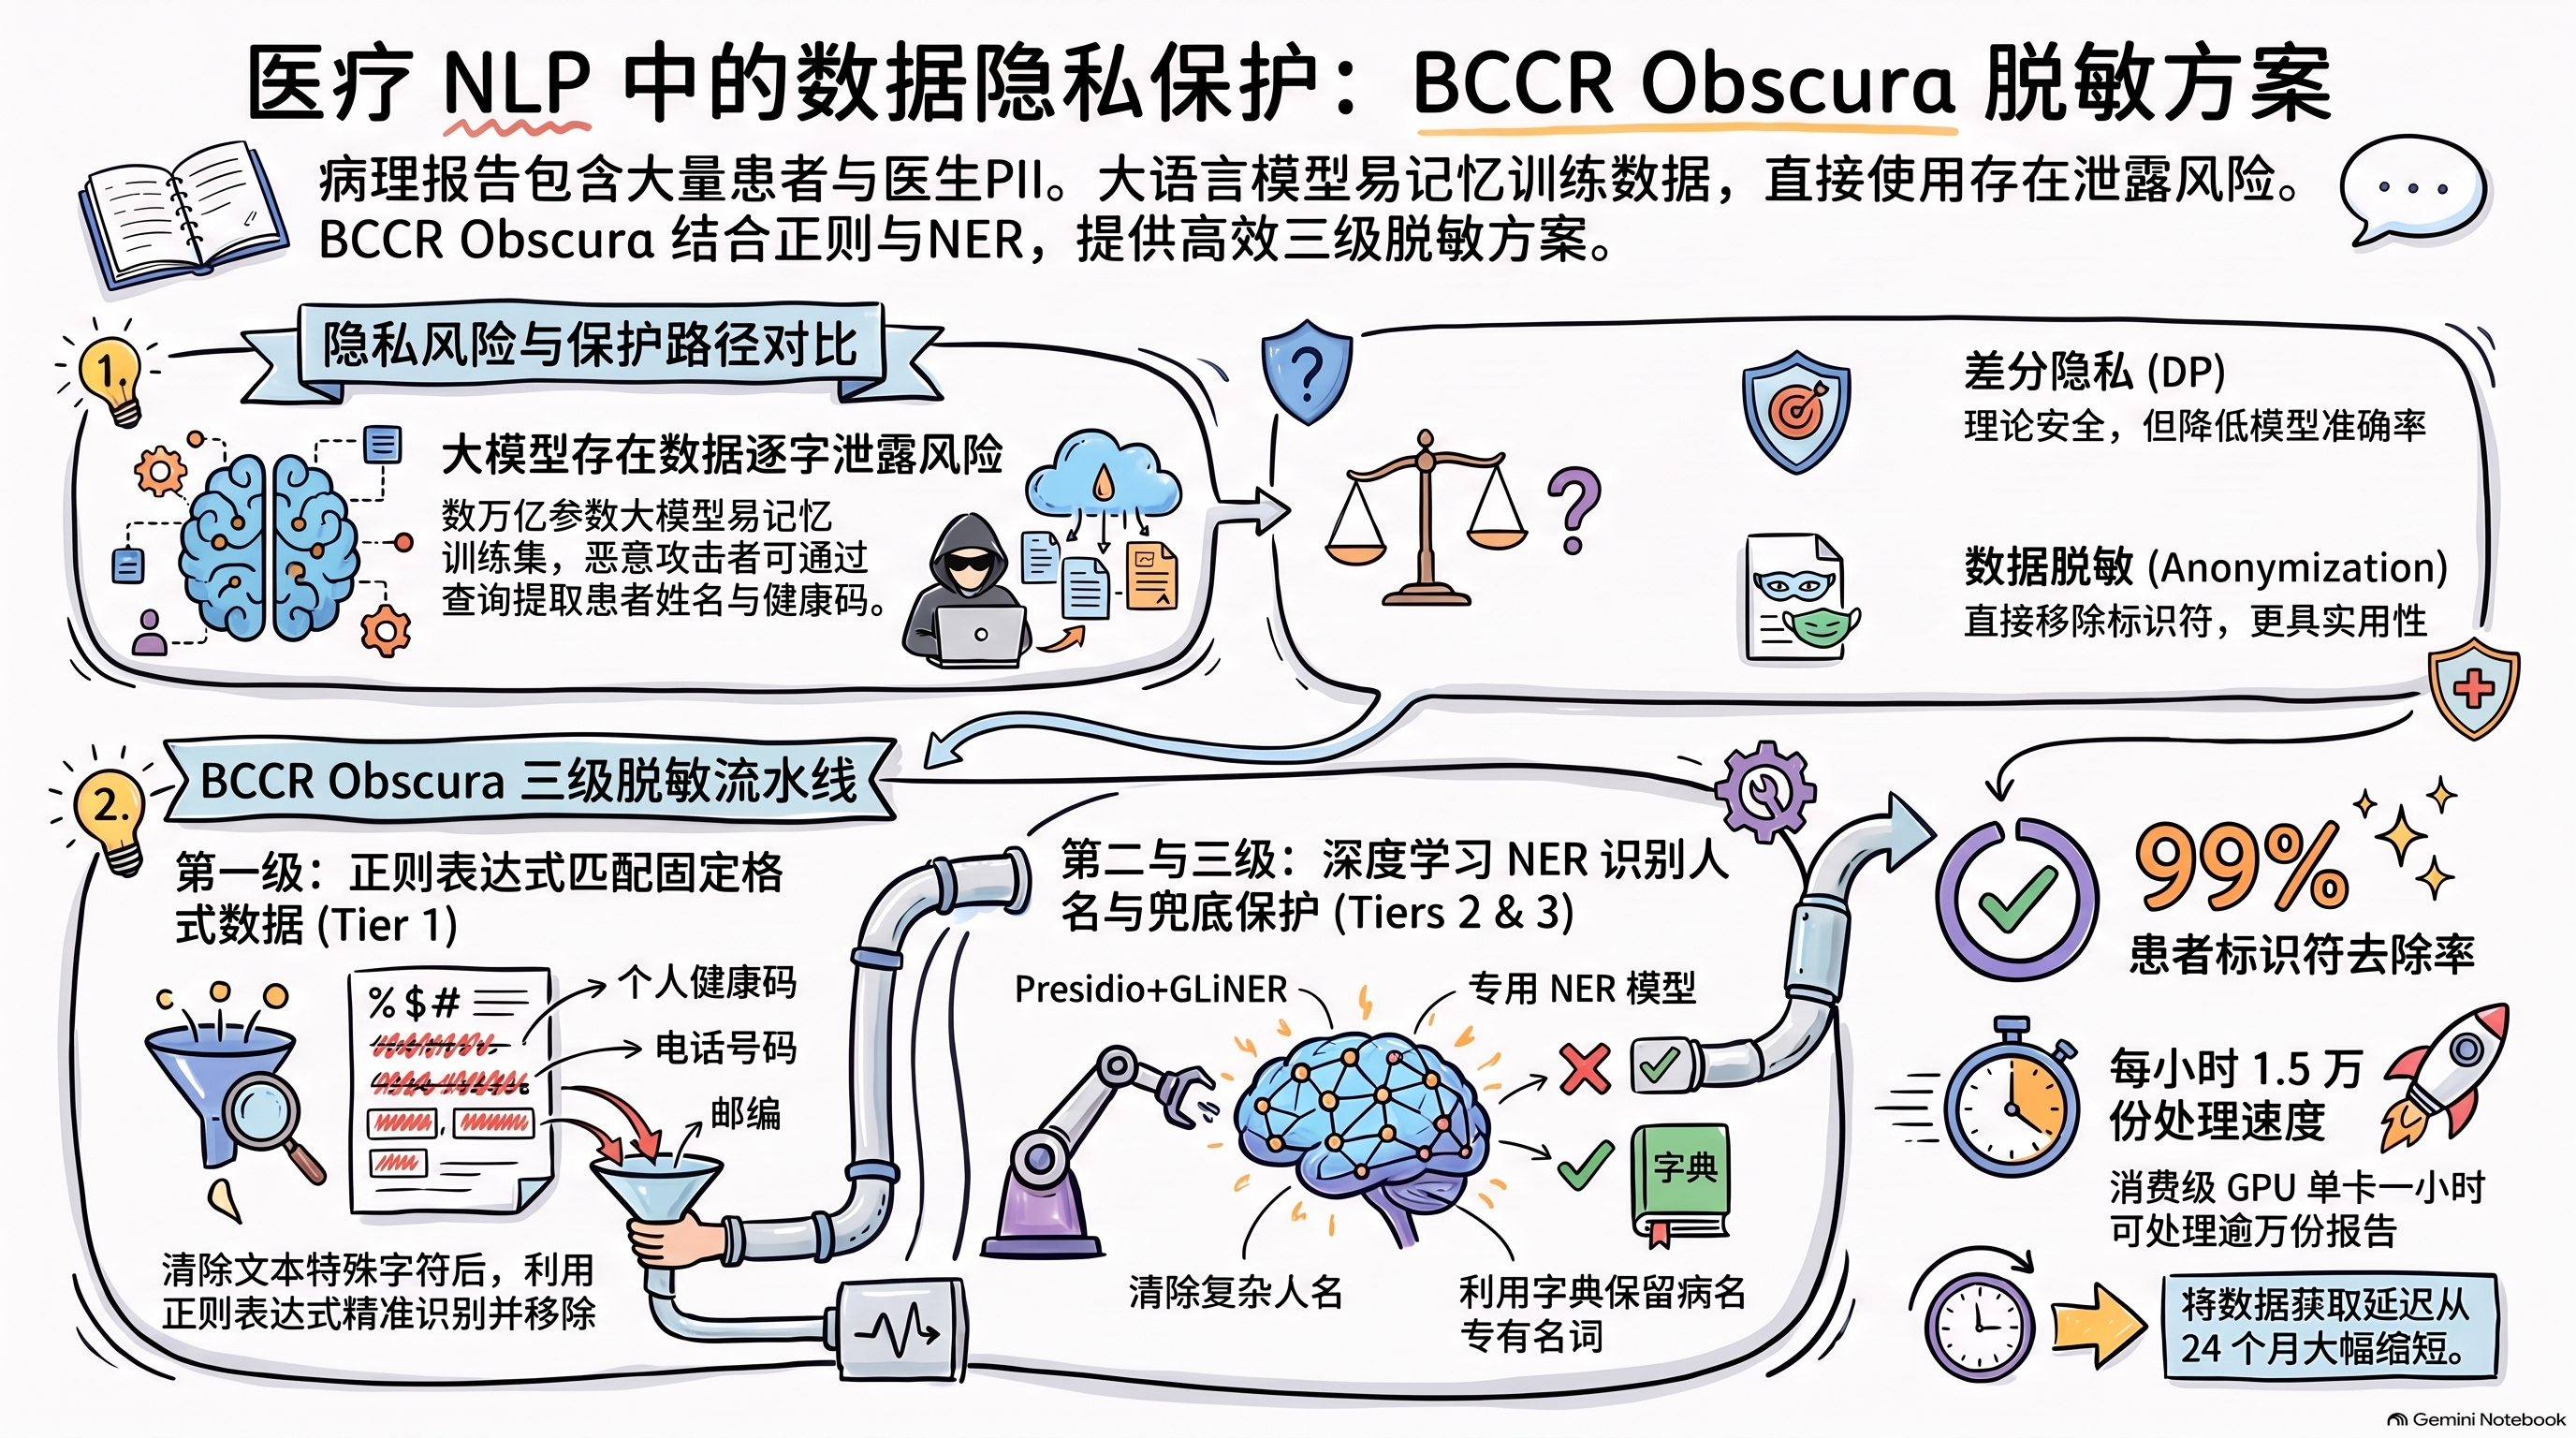
读图提示:99% 是病人标识信息的去除率,医生标识信息约为 95%;数据延迟的缩短来自所有 NLP 流水线的共同作用,不只是匿名化这一步,课上给的原有延迟是平均 18 个月(总结时说 18 到 24 个月)。
这些流水线加在一起,正在提升登记处的数据质量、缩短数据采集的时间:原来 18 到 24 个月的延迟已经降到约 14 个月,目标是在未来一年到一年半内做到实时提供数据。
我的思考
这个案例让我更贴近实际地感受到,NLP 能怎样提高医疗系统的效率。它也让我时刻记着一条规则:要考虑病人的隐私,在保护好隐私的同时提高效率。
但我认为 NLP 能做的不只是提高筛选疾病的效率,它在数据分析、随访和健康教育上也都能有所应用。
学习来源与资源
这篇笔记基于我在不列颠哥伦比亚大学(UBC)微证书项目“用自然语言处理改善患者照护”(Natural Language Processing to Improve Patient Care)中的学习笔记,课程为临床文档的提取与分析(模块一第 1.2 课“BC 癌症登记处的 NLP 实战”,主讲 Lovedeep Gondara)。技术细节核对了以下资料:
- Lovedeep Gondara 等(2024),Classifying tumor reportability status from unstructured electronic pathology reports using language models in a population-based cancer registry setting,JCO Clinical Cancer Informatics(双模型集成,“任一模型判可报告即可报告”)。
- Lovedeep Gondara 等(2025),ELM: a hybrid ensemble of language models for automated tumor group classification in population-based cancer registries,arXiv(6 个小模型,不到 5 个一致时请 LLM 裁决)。
- Lovedeep Gondara 等(2025),Bridging AI innovation and healthcare needs: lessons learned from incorporating modern NLP at the BC Cancer Registry,arXiv(混合方法:够用时用正则表达式,含糊的报告交给 LLM)。
- 美国 CDC,Advancing electronic reporting(eMaRC Plus,处理病理报告的免费规则工具)。
- Milad Nasr 等(2023),Scalable extraction of training data from (production) language models,arXiv(从 ChatGPT 中提取训练数据)。
- Cynthia Dwork 与 Aaron Roth(2014),The algorithmic foundations of differential privacy,Foundations and Trends in Theoretical Computer Science(ε、δ 的定义)。
动手试试
- Microsoft Presidio:第 2 层用的开源框架。在它的在线演示里粘贴一段自己编的报告,看看它能识别出哪些姓名、电话和日期,又是怎样遮盖的。只用虚构的文本,不要用真实报告。
- regex101:在自己编的文字上试一个第 1 层风格的模式,比如 10 位健康号或加拿大邮编。记得选择和你代码一致的正则风格(例如 Python)。