
NLP 学习笔记 / NLP003
文本处理进阶:分词、句子切分与贴标签
上一篇讨论了词的结构和规则匹配。这一篇继续往下走:文字先被切成 token 和句子,再被贴上标签——每个词是什么词性,哪些片段是人名、药物或疾病。这些步骤让文本变得可以计算,也决定了后续分析能看见什么。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
词型与词例
词型是不重复的词,词例是每一次出现。“the cat sat on the mat” 有 6 个词例、5 个词型。
子词词元与 BPE
模型的词元可以是整个词、词的一部分或单个字符。BPE 反复合并最常相邻的符号,从而学到词元。
词性标注与命名实体识别
词性标注给每个词一个语法标签;命名实体识别找出指称特定对象的片段,并判断类型,例如人名或药物。
BIO 标签
B 表示实体开始,I 表示实体内部,O 表示不属于实体。community-acquired pneumonia 标为 B-DISEASE I-DISEASE。
全景图:给序列贴标签
先看左侧的词性标注,再看右侧的命名实体识别。红色部分是最需要分清的两点:模型里的 token 不等于一个字或一个词;实体可以是一个词组。底部是这一篇对我最重要的结论。
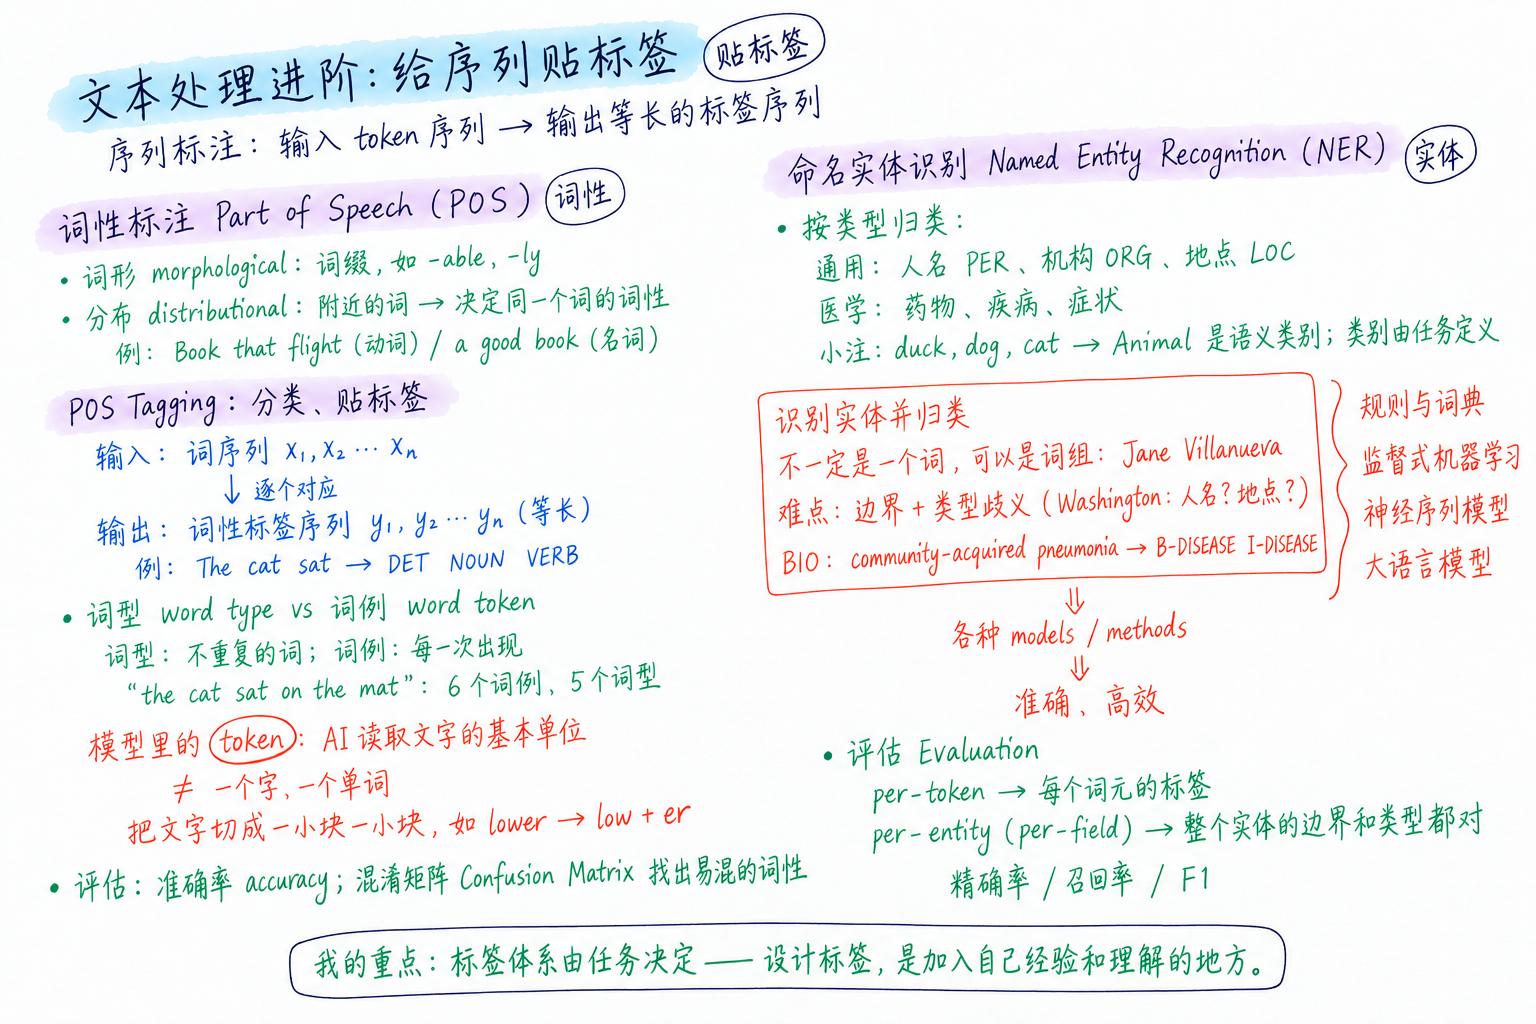
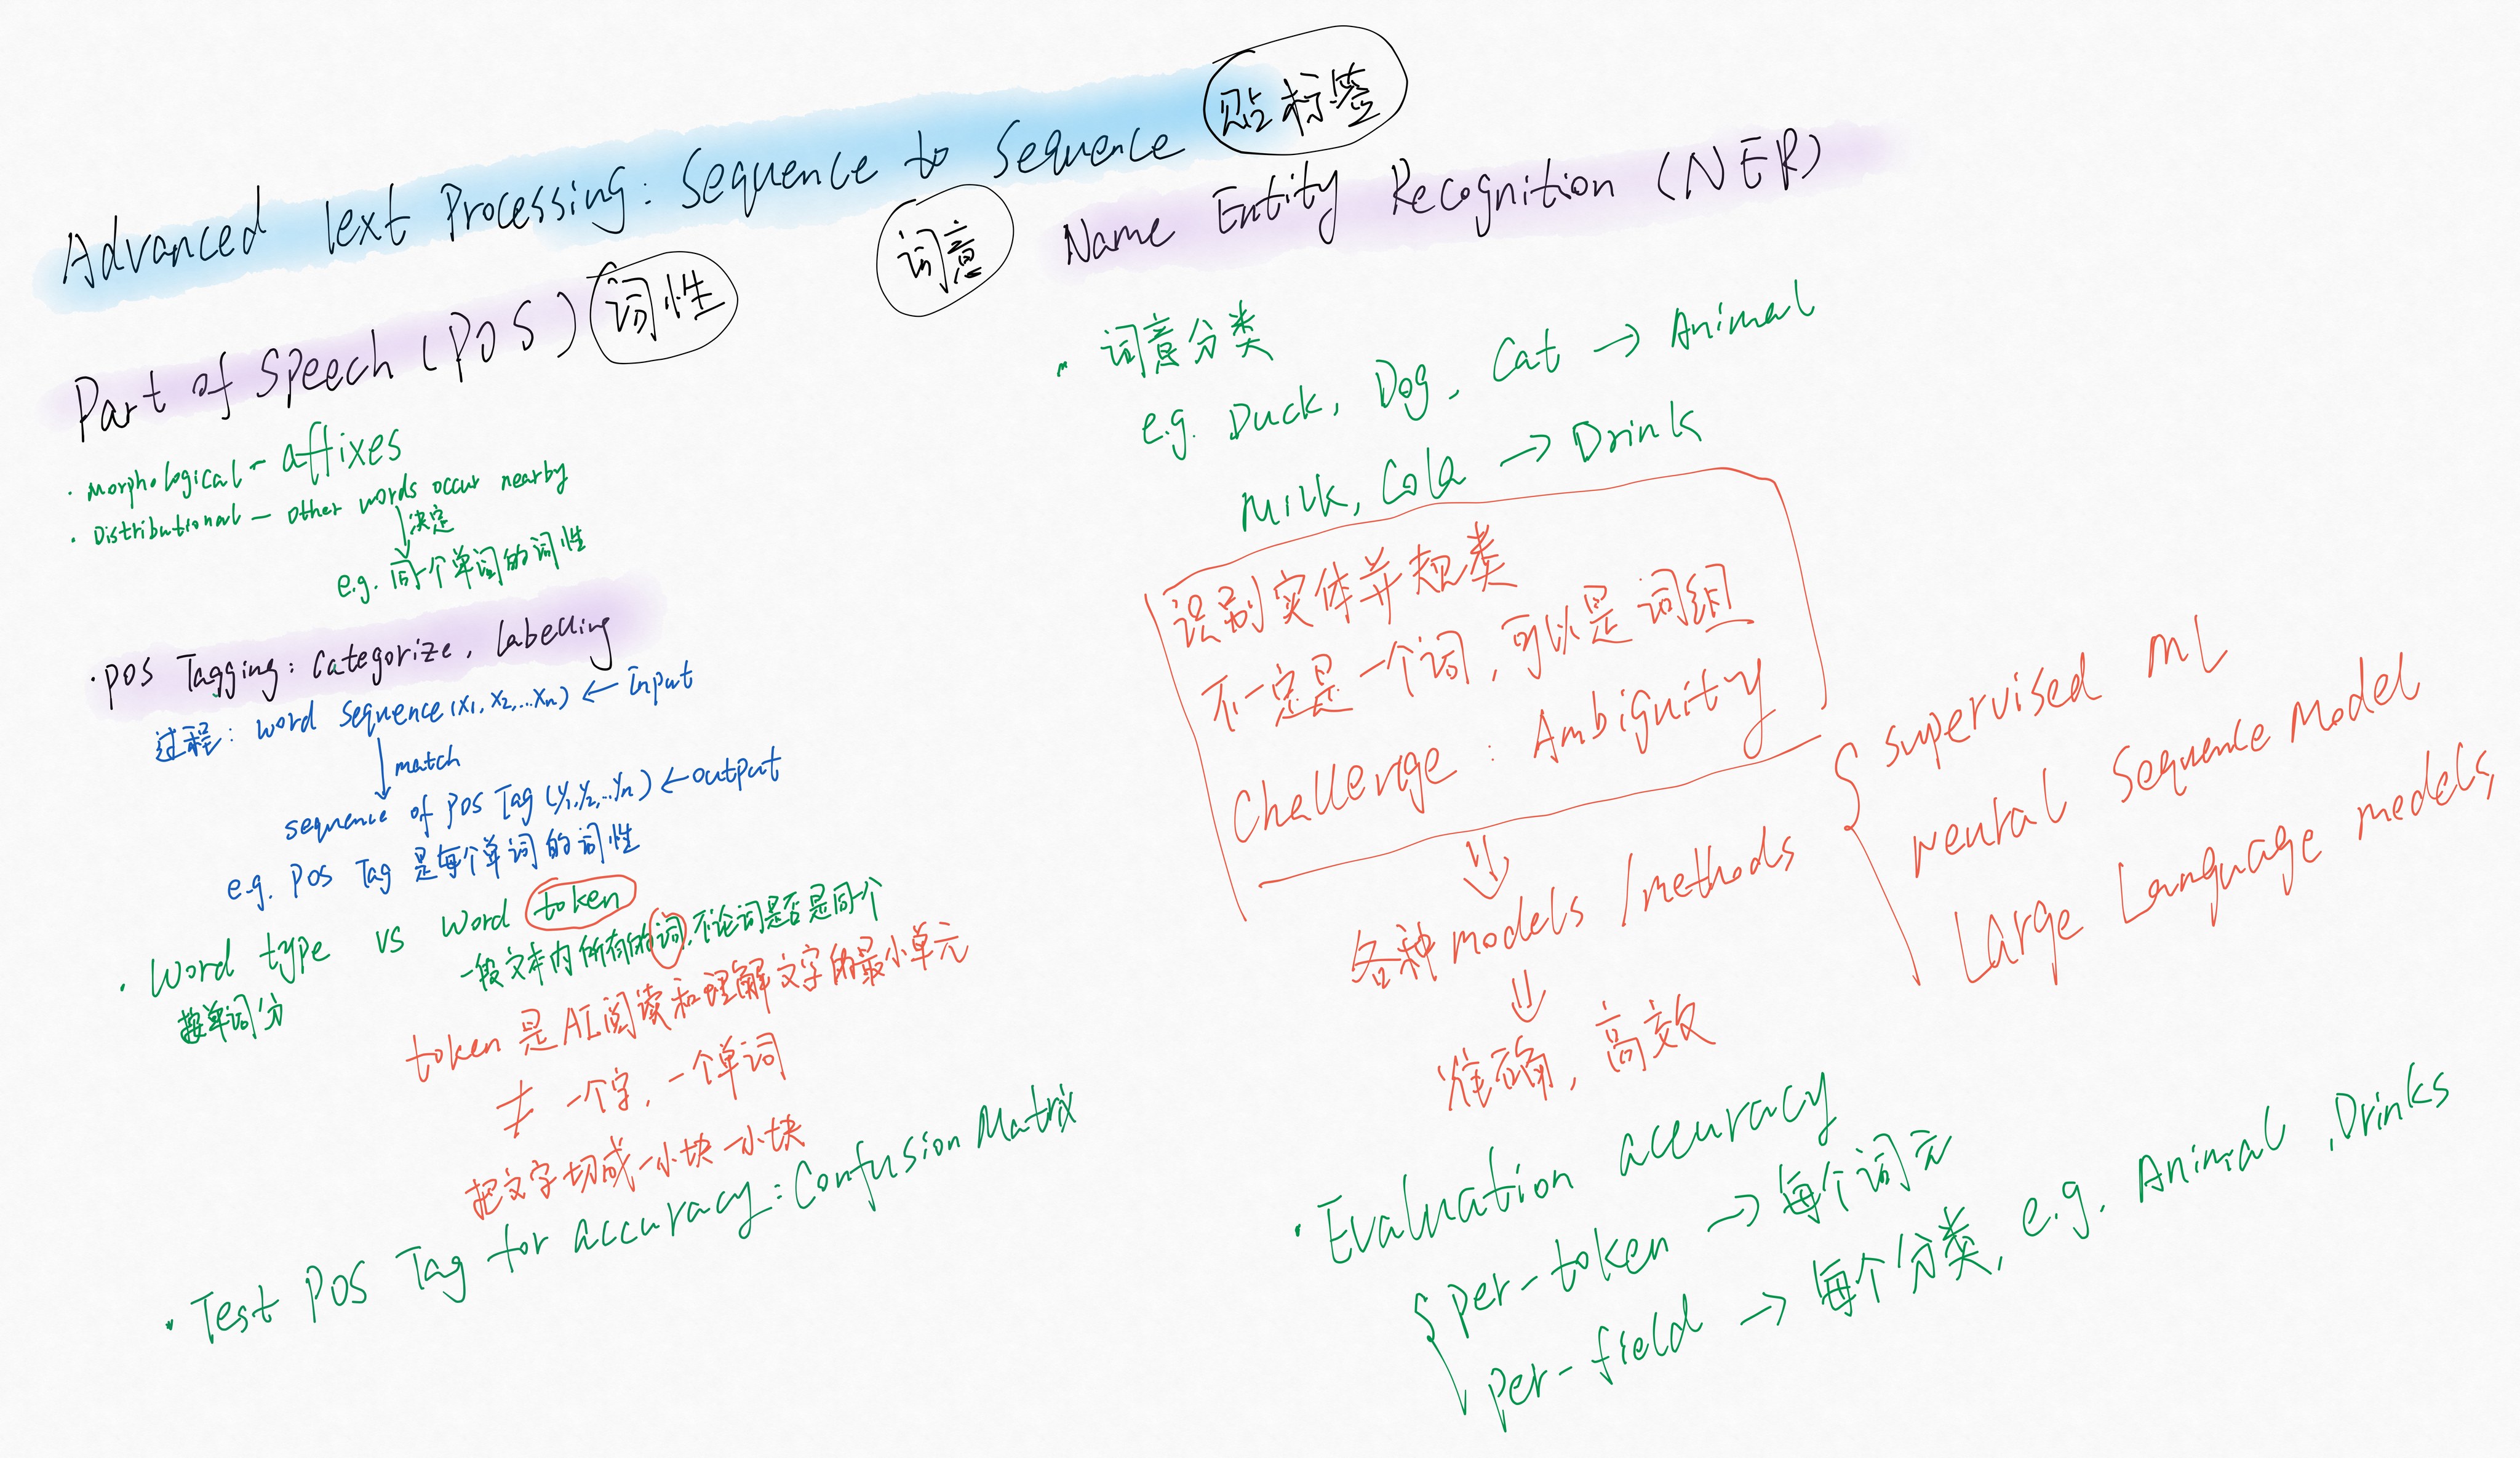
根据我的手写笔记整理,做了几处修正和补充。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
从文字到标签:三步总览
可以把这一篇的内容理解为三步。它们是常见的处理环节,但不是每个系统都必须按同样顺序单独执行。
| 步骤 | 输入 | 输出 | 主要难点 |
|---|---|---|---|
| 分词 Tokenization | 一段连续文字 | 一串 token | 单位切多大:词、子词还是字符 |
| 句子切分 Sentence segmentation | 一段文字 | 一个个句子 | 句号也可能属于缩写或数字 |
| 贴标签 Labeling | token 序列 | 每个 token 或片段的标签 | 同一个词在不同语境中可能对应不同标签 |
这一篇介绍两类基础标签任务:词性标注(part-of-speech tagging,POS tagging)和命名实体识别(named entity recognition,NER)。两者都属于序列标注(sequence labeling):输入一串 token,为每个 token 输出一个标签,输出与输入等长。Sequence Labeling for Parts of Speech and Named Entities
说明:课程和配图把这一过程称为“序列到序列”(sequence to sequence)。在 NLP 中,sequence-to-sequence 更常指机器翻译这类输入、输出长度可以不同的编码器–解码器任务;词性标注和 NER 更准确的名称是序列标注。
什么是 token:分词与子词
token 在 NLP 中有两种常见用法,容易混在一起。
| 用法 | 含义 | 例子 |
|---|---|---|
| 统计文本时:词型 vs 词例 | 词型(word type)是不重复的词;词例(word token / instance)是每一次出现 | “the cat sat on the mat” 有 6 个词例、5 个词型(the 出现两次) |
| 模型处理时:词元 | 分词器(tokenizer)切出的处理单位,模型读入的是一串词元编号 | lower 可能被切成 low + er |
第二种用法里,token 是模型读取文字的基本单位,不等于一个字或一个单词:它可以是完整的词、词的一部分,也可以是单个字符或标点。只按完整单词切分,会遇到训练中没见过的新词;只按字符切分,序列又会很长。子词(subword)分词是两者之间的折中。Words and Tokens
字节对编码(BPE)如何学到词元
字节对编码(byte-pair encoding,BPE)分两个阶段:
- 学习阶段:从单个字符开始,反复统计语料中最常相邻出现的一对符号,把它们合并成新的词元,例如先合并 e + r → er,再合并 l + o → lo、lo + w → low。重复成千上万次,就得到一张词表。
- 切分阶段:遇到新文本时,先拆成字符,再按学到的合并规则依次合并。即使训练中没见过 lower,也可以表示为 low + er。
实际的大模型词表通常有几万到二十万个词元。结果是常见词多为一个词元,罕见词和新词被拆成几个子词。不同语言的切分效率也不同:如果训练语料以英语为主,其他语言的同等内容可能需要更多词元。Words and Tokens
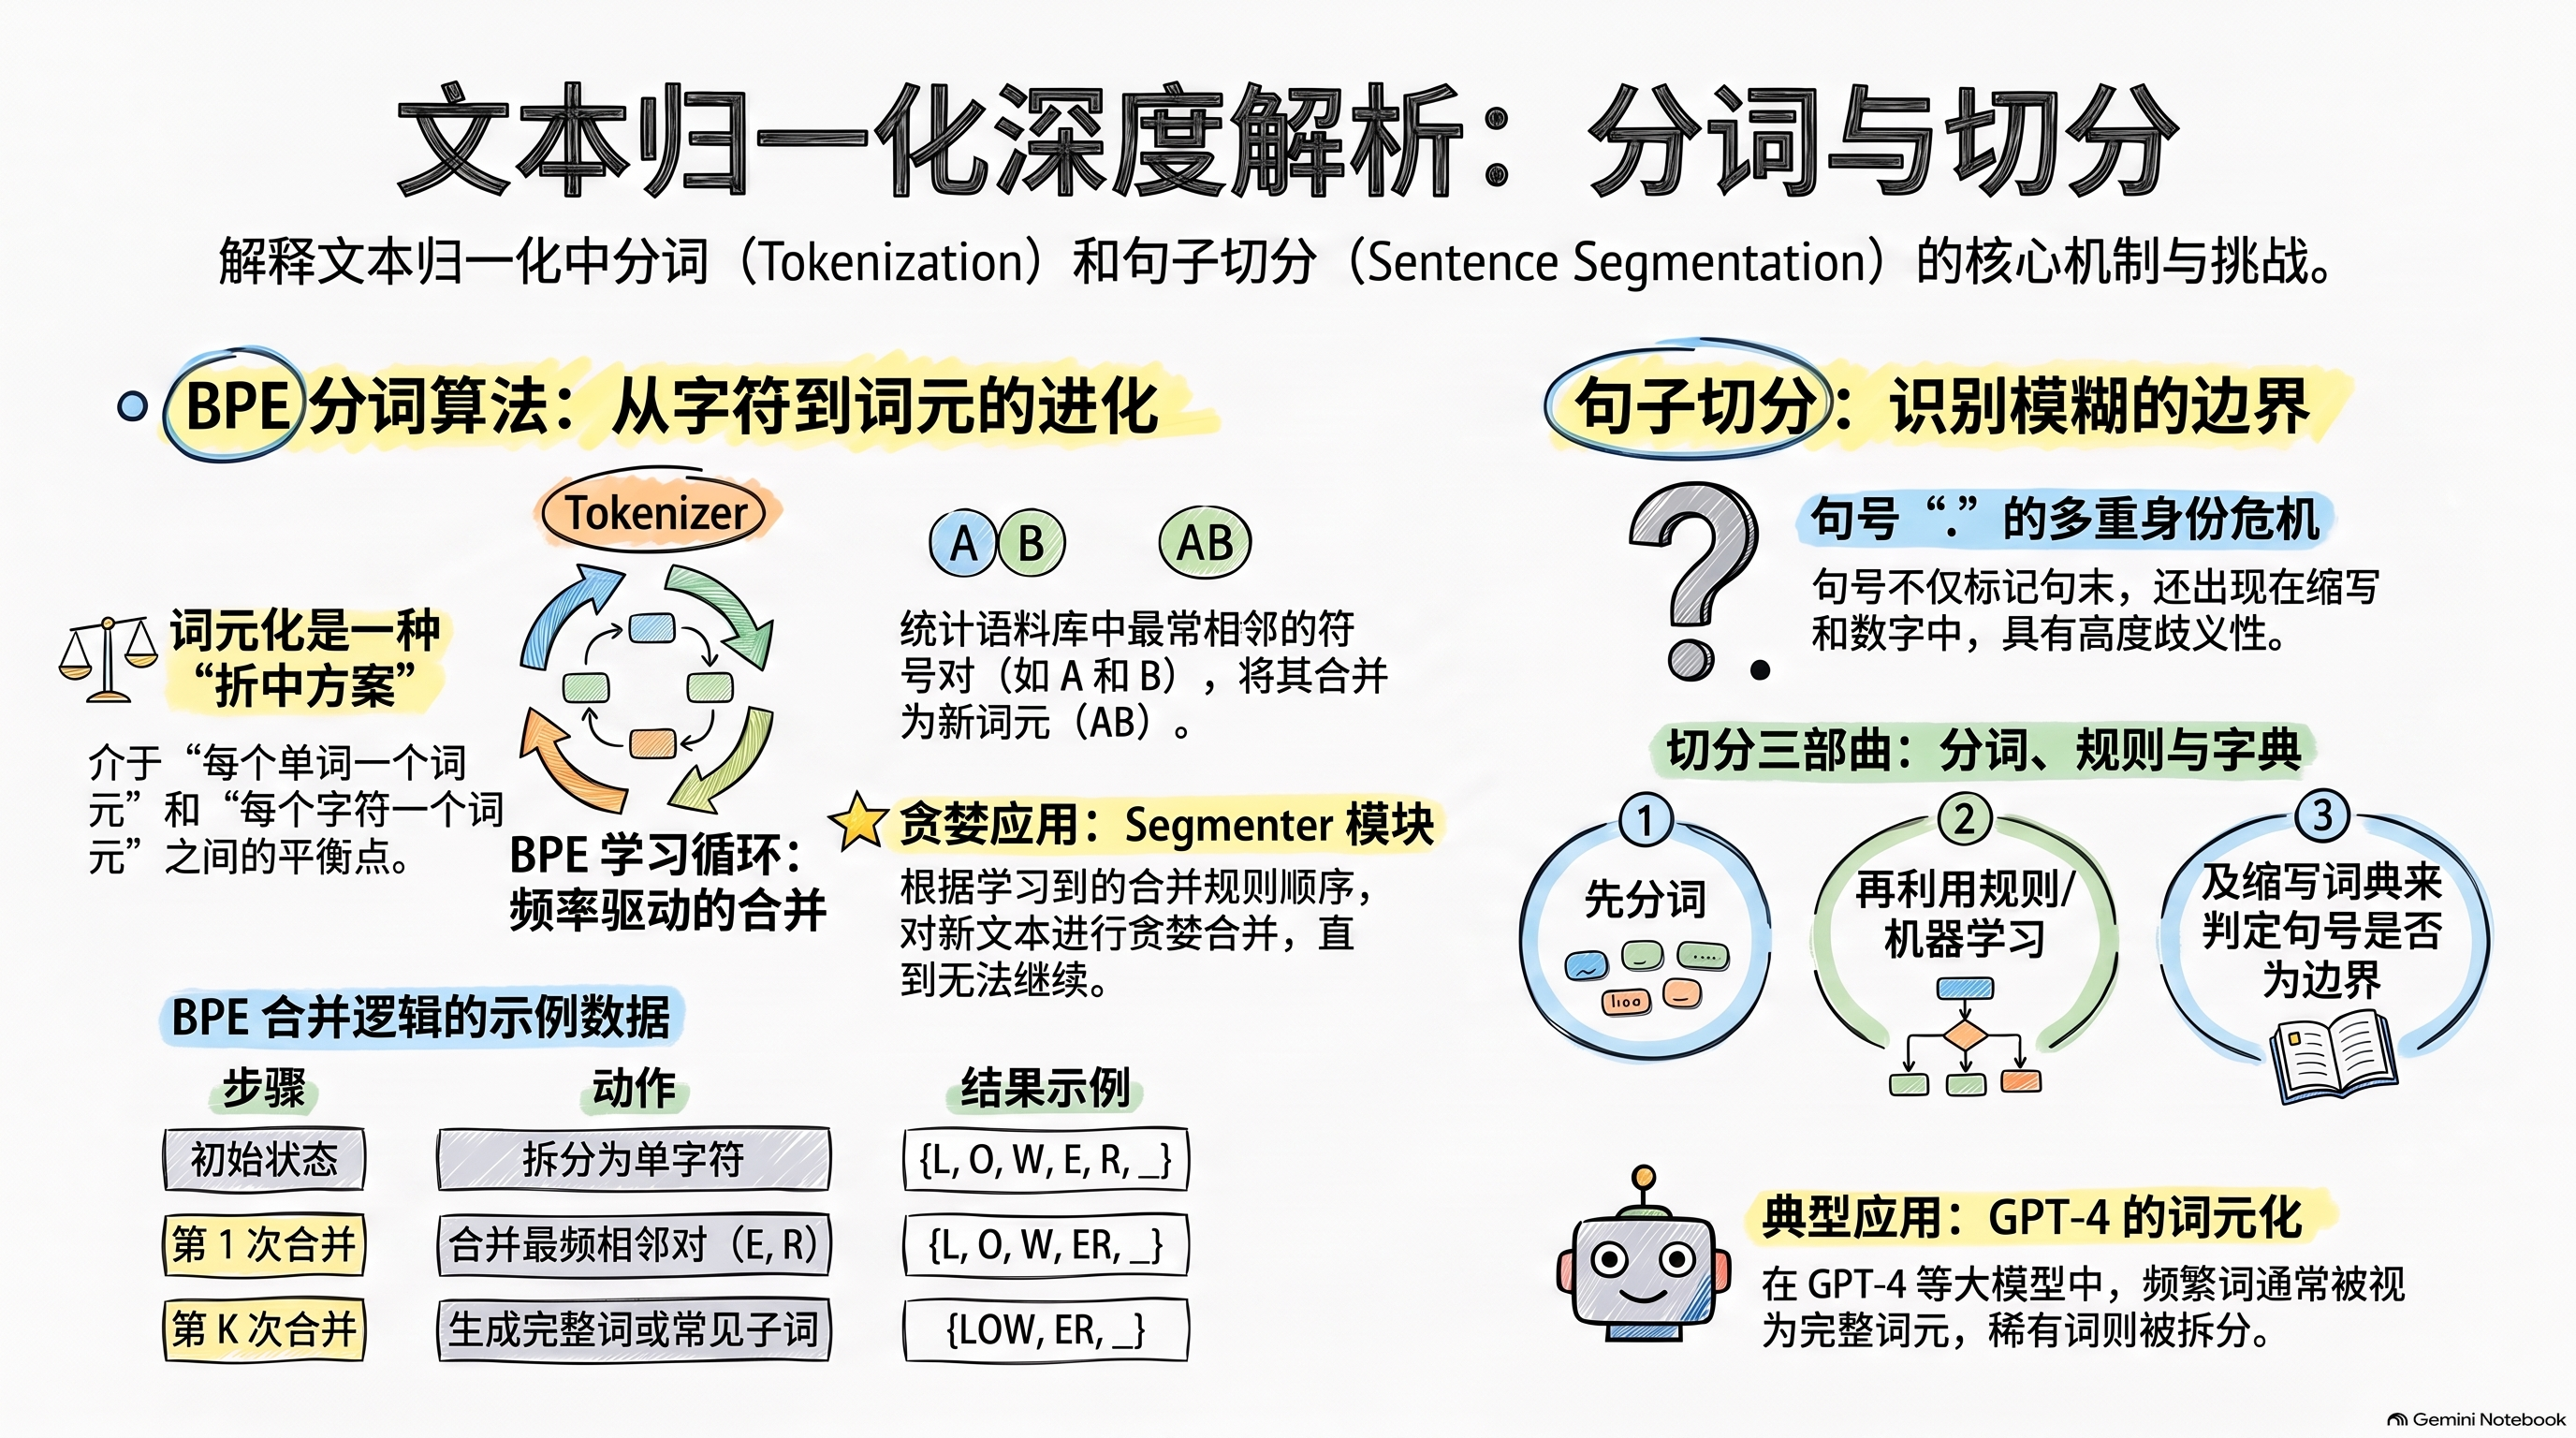
读图说明:图题把分词和句子切分归在“文本归一化”下,这是教材中的一种组织方式。BPE 合并的依据是训练语料中的频率,切分新文本时按学到的顺序合并,不再重新统计新文本的频率。“GPT-4 的词元化”是示例,不同模型的分词器各不相同。
句子切分:句号不一定是句末
句子切分(sentence segmentation)判断一段文字在哪里断句。问号和感叹号通常比较明确,句号则有歧义:它可以结束句子,也可以出现在 Dr.、Prof. 这类缩写或 19.99 这样的数字里。
常见做法是先分词,再判断每个句号属于词的一部分,还是句子边界。判断可以依靠规则(例如后面是否跟大写字母)、缩写词典,或者由机器学习模型根据上下文分类。Words and Tokens
例如 “Dr. Smith prescribed 2.5 mg at 8 a.m. The patient improved.” 中,Dr. 和 2.5 里的句点都不是句末;a.m. 的第二个句点既属于缩写,又标记了第一句的结束。临床记录中缩写很多,这类问题会更常见;切错句子会影响之后按句子进行的标注和抽取。
词性标注:给每个词一个语法标签
词性标注(POS tagging)的输入是一串已切分的词 x₁, x₂, …, xₙ,输出是等长的标签序列 y₁, y₂, …, yₙ,每个标签对应一个词。例如 “The cat sat on the mat” 对应 限定词–名词–动词–介词–限定词–名词(DET NOUN VERB ADP DET NOUN)。
词性可以分为两类:
- 开放类:名词、动词、形容词、副词等实词,新词不断加入。
- 封闭类:冠词、介词、代词、连词等功能词,数量相对固定、出现频繁。
判断词性的线索
判断词性主要依靠三类线索:
- 词形:词缀提供提示,例如 -able 常出现在形容词中,-ly 常出现在副词中。
- 分布:周围出现什么词。冠词后面通常是名词或形容词。
- 先验概率:这个词在训练语料中最常被标成什么词性。
难点在于歧义。book 在 “Book that flight” 中是动词,在 “a good book” 中是名词。在英语语料中,有歧义的词只占不同词型的约 14–15%,但它们很常用,因此在实际文本里,约 55–67% 的词例存在词性歧义。SLP3 第 18 章
如何评估
词性标注用准确率(accuracy)评估:标对的词占全部词的比例。一个简单基线是总给每个词标它最常见的词性,准确率约 92%;现代模型在英语上约 97%,与人工标注的上限相近。混淆矩阵(confusion matrix)可以显示哪些词性最容易被互相混淆,帮助定位错误。SLP3 第 18 章
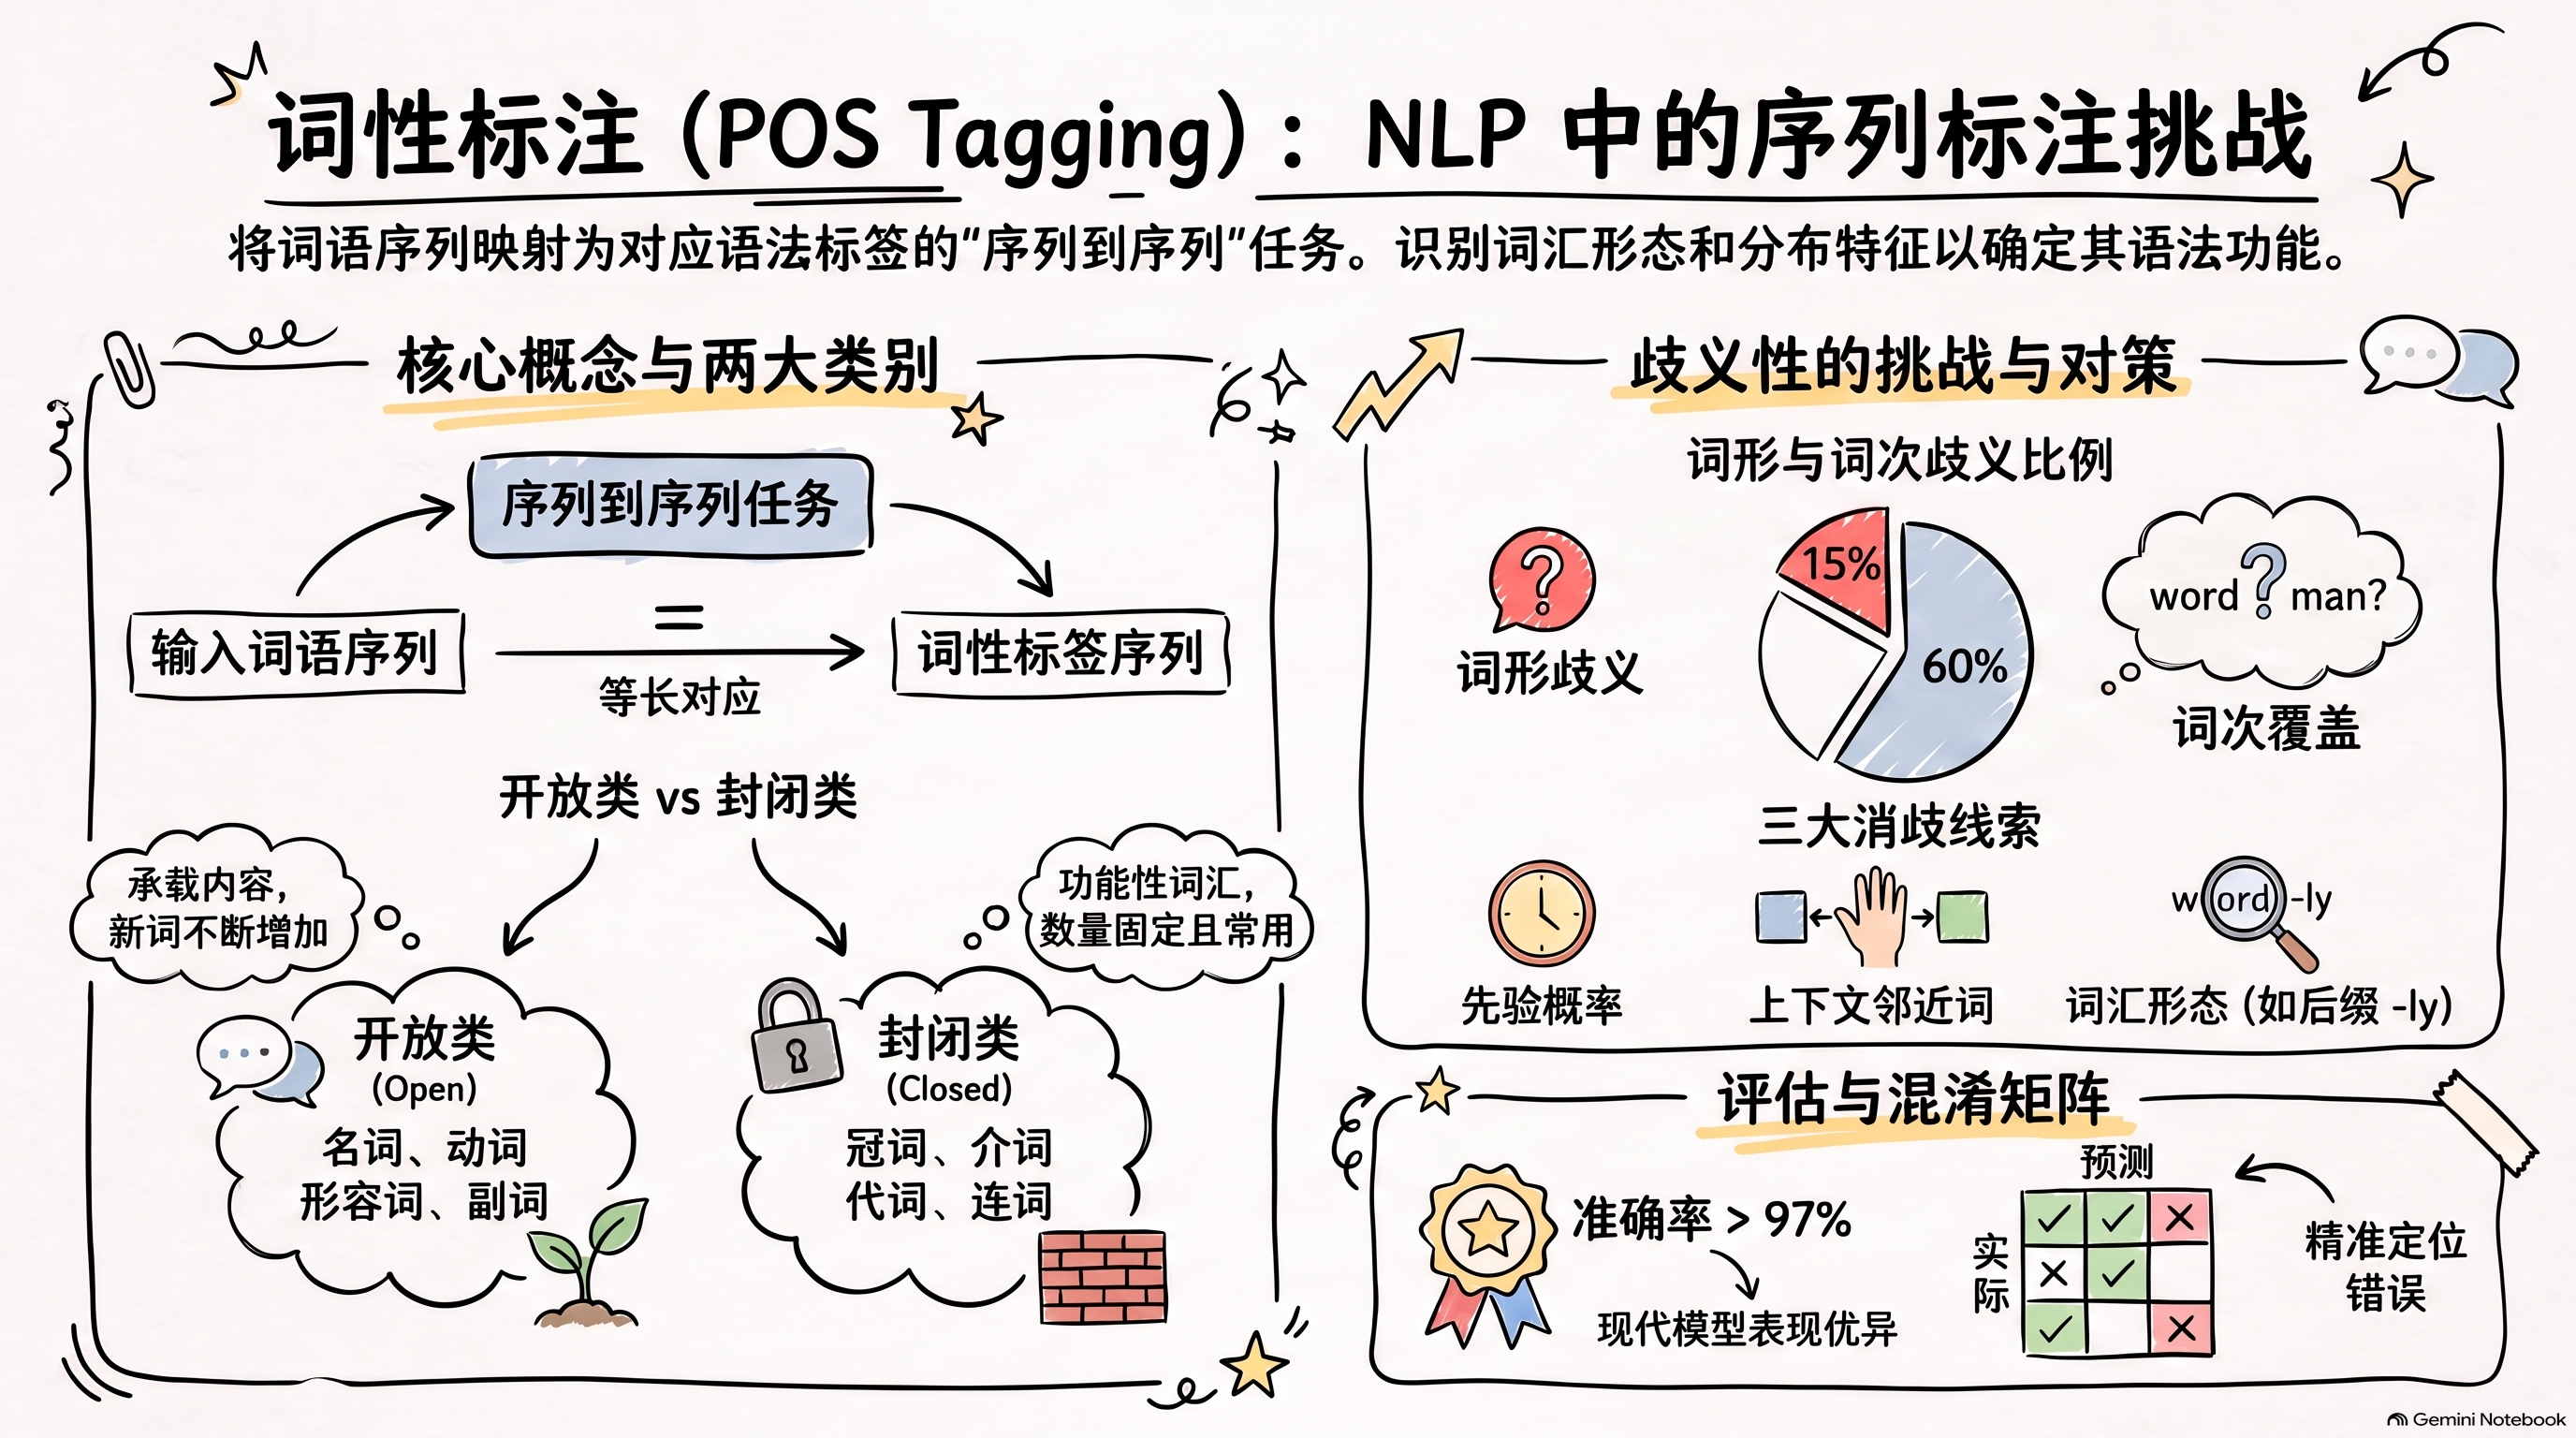
读图说明:“序列到序列任务”更准确地说是序列标注。饼图中的 15% 和 60% 来自不同的计算基础——前者按不重复的词型计算,后者按文本中每次出现的词例计算——不是同一张饼图的两个部分。图中的“词形歧义”“词次覆盖”可以理解为词型歧义和词例歧义;“word? man?” 没有对应含义,可以忽略。
命名实体识别:找出片段并判断类型
命名实体识别(NER)要在文本中找出指称特定对象的片段,并判断它的类型。通用领域常见的类型包括人名(PER)、机构(ORG)、地点(LOC)和地缘政治实体(GPE),也常扩展到日期、金额等。医学文本中,任务通常会自定义药物、疾病、症状等类型。
与词性标注相比,NER 多了两个难点:
- 边界:实体不一定是一个词,可以是词组,例如 Jane Villanueva、community-acquired pneumonia。要判断从哪里开始、到哪里结束,而且文本中大多数词都不是实体。
- 类型歧义:Washington 可以是人名、球队(机构)、地点或政府(地缘政治实体)。
BIO 标注:把找片段变成逐词贴标签
BIO 标注让 NER 也可以按序列标注来做:B 表示实体开始,I 表示实体内部,O 表示不属于任何实体。下面是一个虚构的临床句子:
| token | 标签 |
|---|---|
| Patient | O |
| started | O |
| amoxicillin | B-DRUG |
| for | O |
| community-acquired | B-DISEASE |
| pneumonia | I-DISEASE |
这样,两个词组成的疾病名称被完整地标为一个实体。SLP3 第 18 章
标签体系由任务决定
在我的手写笔记里,duck、dog、cat 被归为 Animal,milk、cola 被归为 Drink。这是按语义类别贴标签。通用 NER 主要识别专有名称,一般不会把普通名词 dog 标成实体;但只要任务定义了相应类型,标签体系也可以覆盖普通名词——医学 NER 中的 pneumonia、high fever 就不是专有名称。因此,先定义“要识别什么、分成哪几类”,是做 NER 的第一步。
方法与评估
实现 NER 的方法包括规则与词典、监督式机器学习、神经序列模型,以及大语言模型(large language models,LLM)。选择时需要在准确性、效率和可获得的标注数据之间权衡。
评估有两种粒度:
| 粒度 | 计算单位 | 特点 |
|---|---|---|
| 逐 token(per-token) | 每个词的标签是否正确 | 大多数词标 O,数值容易显得很高 |
| 按实体(课程称 per-field) | 整个实体的边界和类型是否都正确 | 常用精确率、召回率和 F1 |
如果系统只把 Jane 标为人名,漏掉 Villanueva,按实体评估就不算识别正确。NER 通常以整个实体为单位,计算精确率(precision)、召回率(recall)和 F1。SLP3 第 18 章
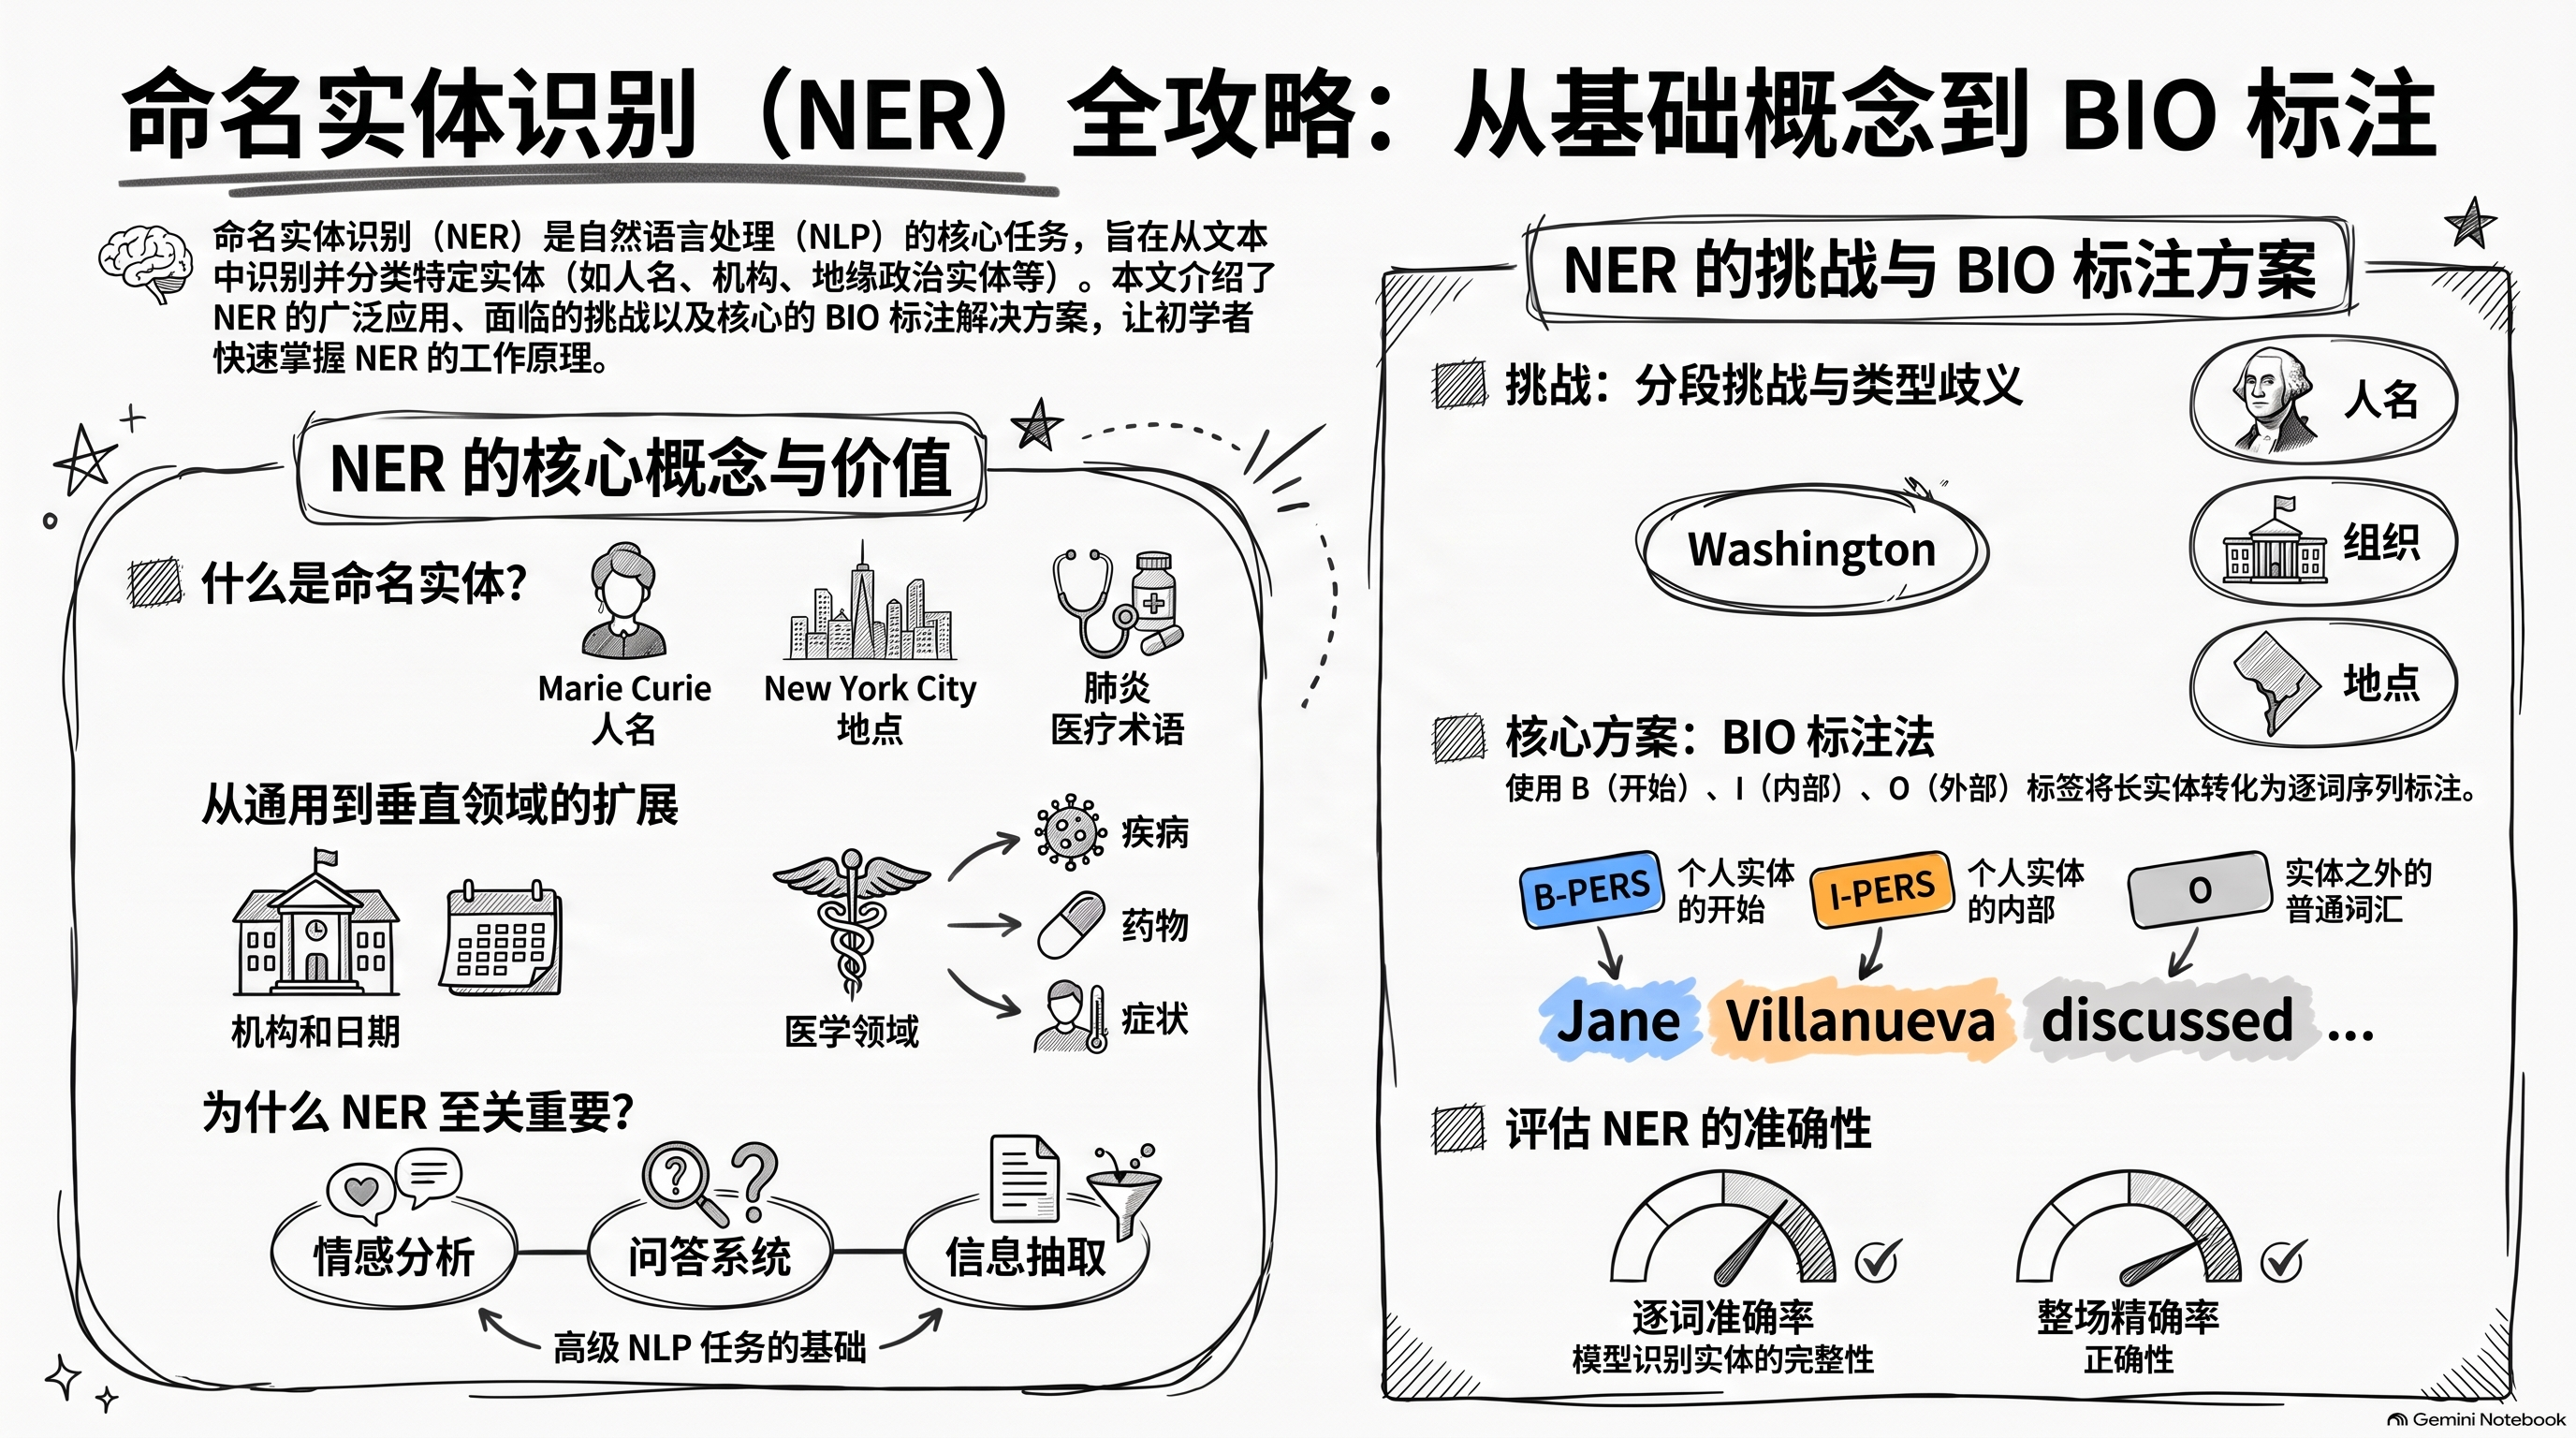
读图说明:右下角两个评估指标的说明不准确。“逐词准确率”衡量每个词的标签是否正确,不等于实体识别的完整性;“整场精确率”应理解为按实体计算的精确率,即系统标出的实体中,边界和类型都正确的比例。图中 Washington 的“组织”可以是球队,政府含义通常归为地缘政治实体。
我的思考
这一期最需要掌握的概念是 token。token 是 AI 阅读和理解文字的基本单位,它不等于一个字或一个单词,而是把文字切成一小块一小块、AI 能处理的单位:可以是一个词组、一个片段,也可以是一个词的一部分。分词(tokenization)就是完成一段文字词元划分的过程。
我的理解是,词元划分越有效,模型学习时的效率就越高,也越节省算力,所以有很多研究专门探索如何进行更有效的词元划分。
有了 token 之后,对文本的处理可以简单地概括为“贴标签”。标签可以有很多种:比如词性,动词、名词、形容词;再比如按词义划分,狗、猫、鸡、鸭都是动物,或者狗和猫是哺乳动物,鸡和鸭是禽类。贴标签是学习的第一步,方便之后进行知识分类和知识体系的构建。
在实际应用中,我需要特别注意“标签”。既然最基础的一步是对内容分类,而分类可以有不同的类别和方法,那么设计标签体系,就是我想构建自己的模型时,可以加入自己经验和对内容理解的部分。
下一步我想研究的问题是:如何从词义走向知识网络?
学习来源
本篇由 UBC “Natural Language Processing to Improve Patient Care” 微证书课程学习笔记整理而成,母稿记录的课程为 “Overview of NLP and Large Language Models”。技术核对使用 Jurafsky 与 Martin 的 《Speech and Language Processing》(第 3 版草稿,2026 年 8 月)第 2 章 Words and Tokens 和第 18 章 Sequence Labeling for Parts of Speech and Named Entities。
动手探索
想看看一句话会被切成哪些词元,可以使用 Tiktokenizer:输入一段中文或英文,查看词元划分和数量。可以比较同一句话的中英文版本各需要多少词元,或者试试医学术语会被怎样拆分。