
NLP 学习笔记 / NLP002
基础文本处理:从词的结构到规则匹配
自然语言处理(NLP)首先要面对一个实际问题:如何把连续、形式多样的文字变成可以分析的材料?理解词的结构、识别文字模式、选择合适的规范化方法,是进入这个问题的起点。它们帮助计算机处理文本,但不等于已经理解了文本的全部含义。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
词素与 token
词素承载意义或语法功能:cats 包含 cat 和 -s。token 是分词工具划分的处理单位,不一定等于词素。
词干提取与词形还原
词干提取按规则删改词形,结果可能不是词典词。词形还原结合词典与形态信息,寻找基本词形。
正则匹配与含义
正则寻找文字模式。仅匹配 pain,无法区分 I have pain 与 I have no pain。
语料库与词汇表
语料库是文本集合;词汇表记录按照既定分词与规范化规则得到的不同词项。
基础文本处理全景图
先看左侧的文字规则与右侧的词结构,再比较中间两种词形处理,最后沿底部理解语料库怎样在选定规则下形成词汇表。
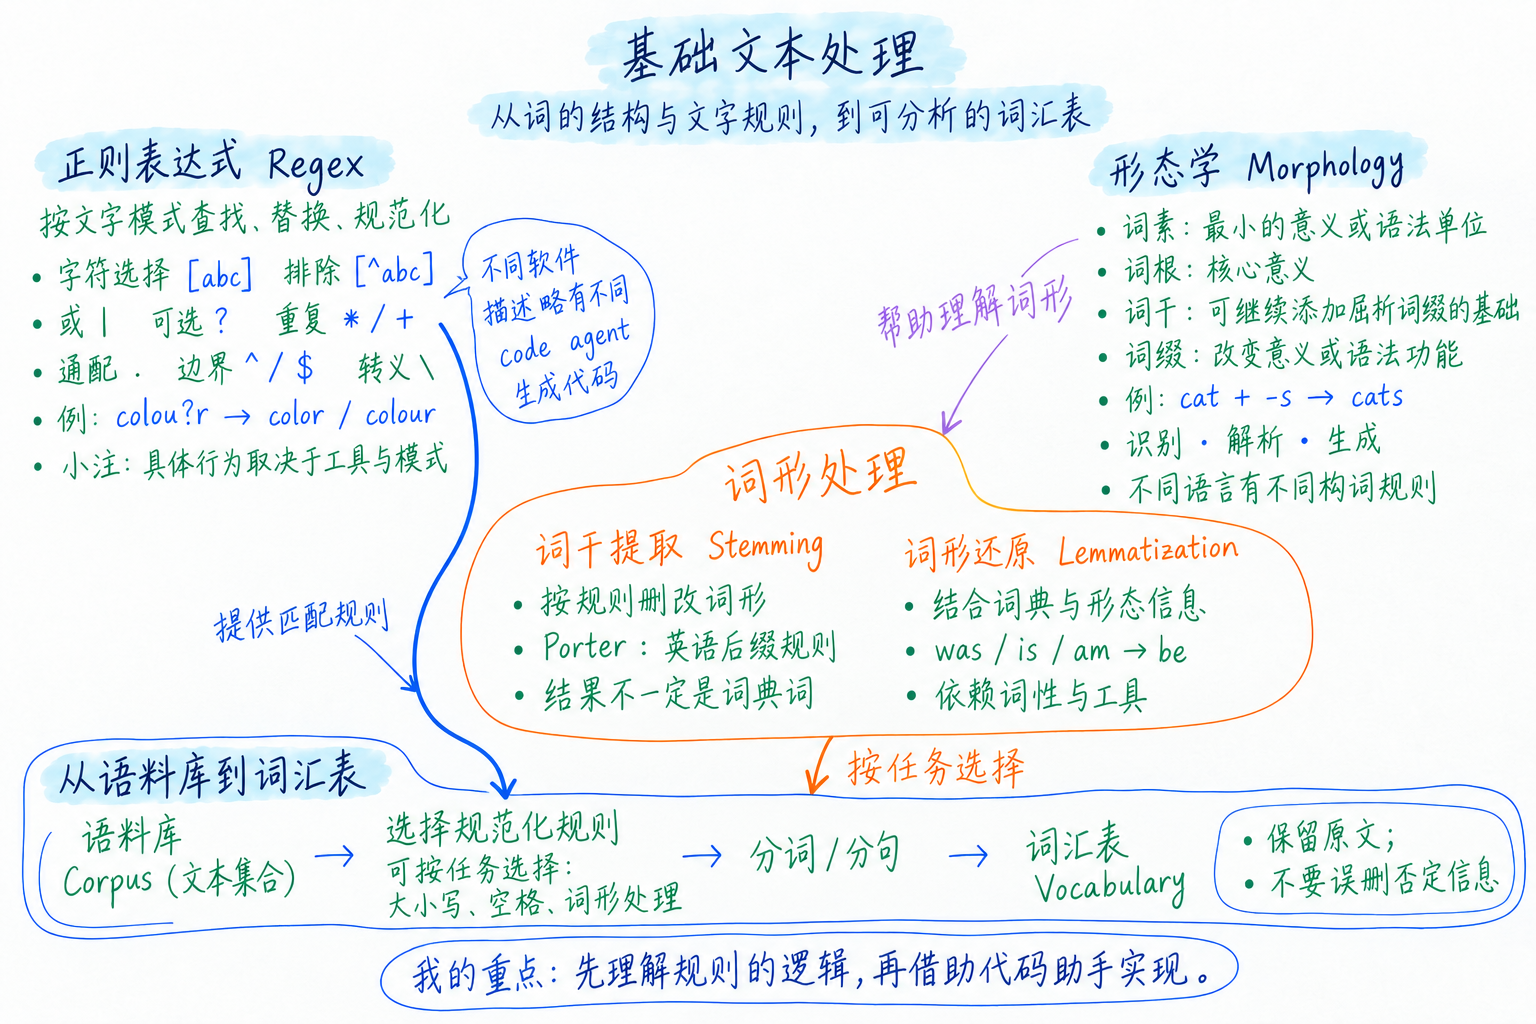
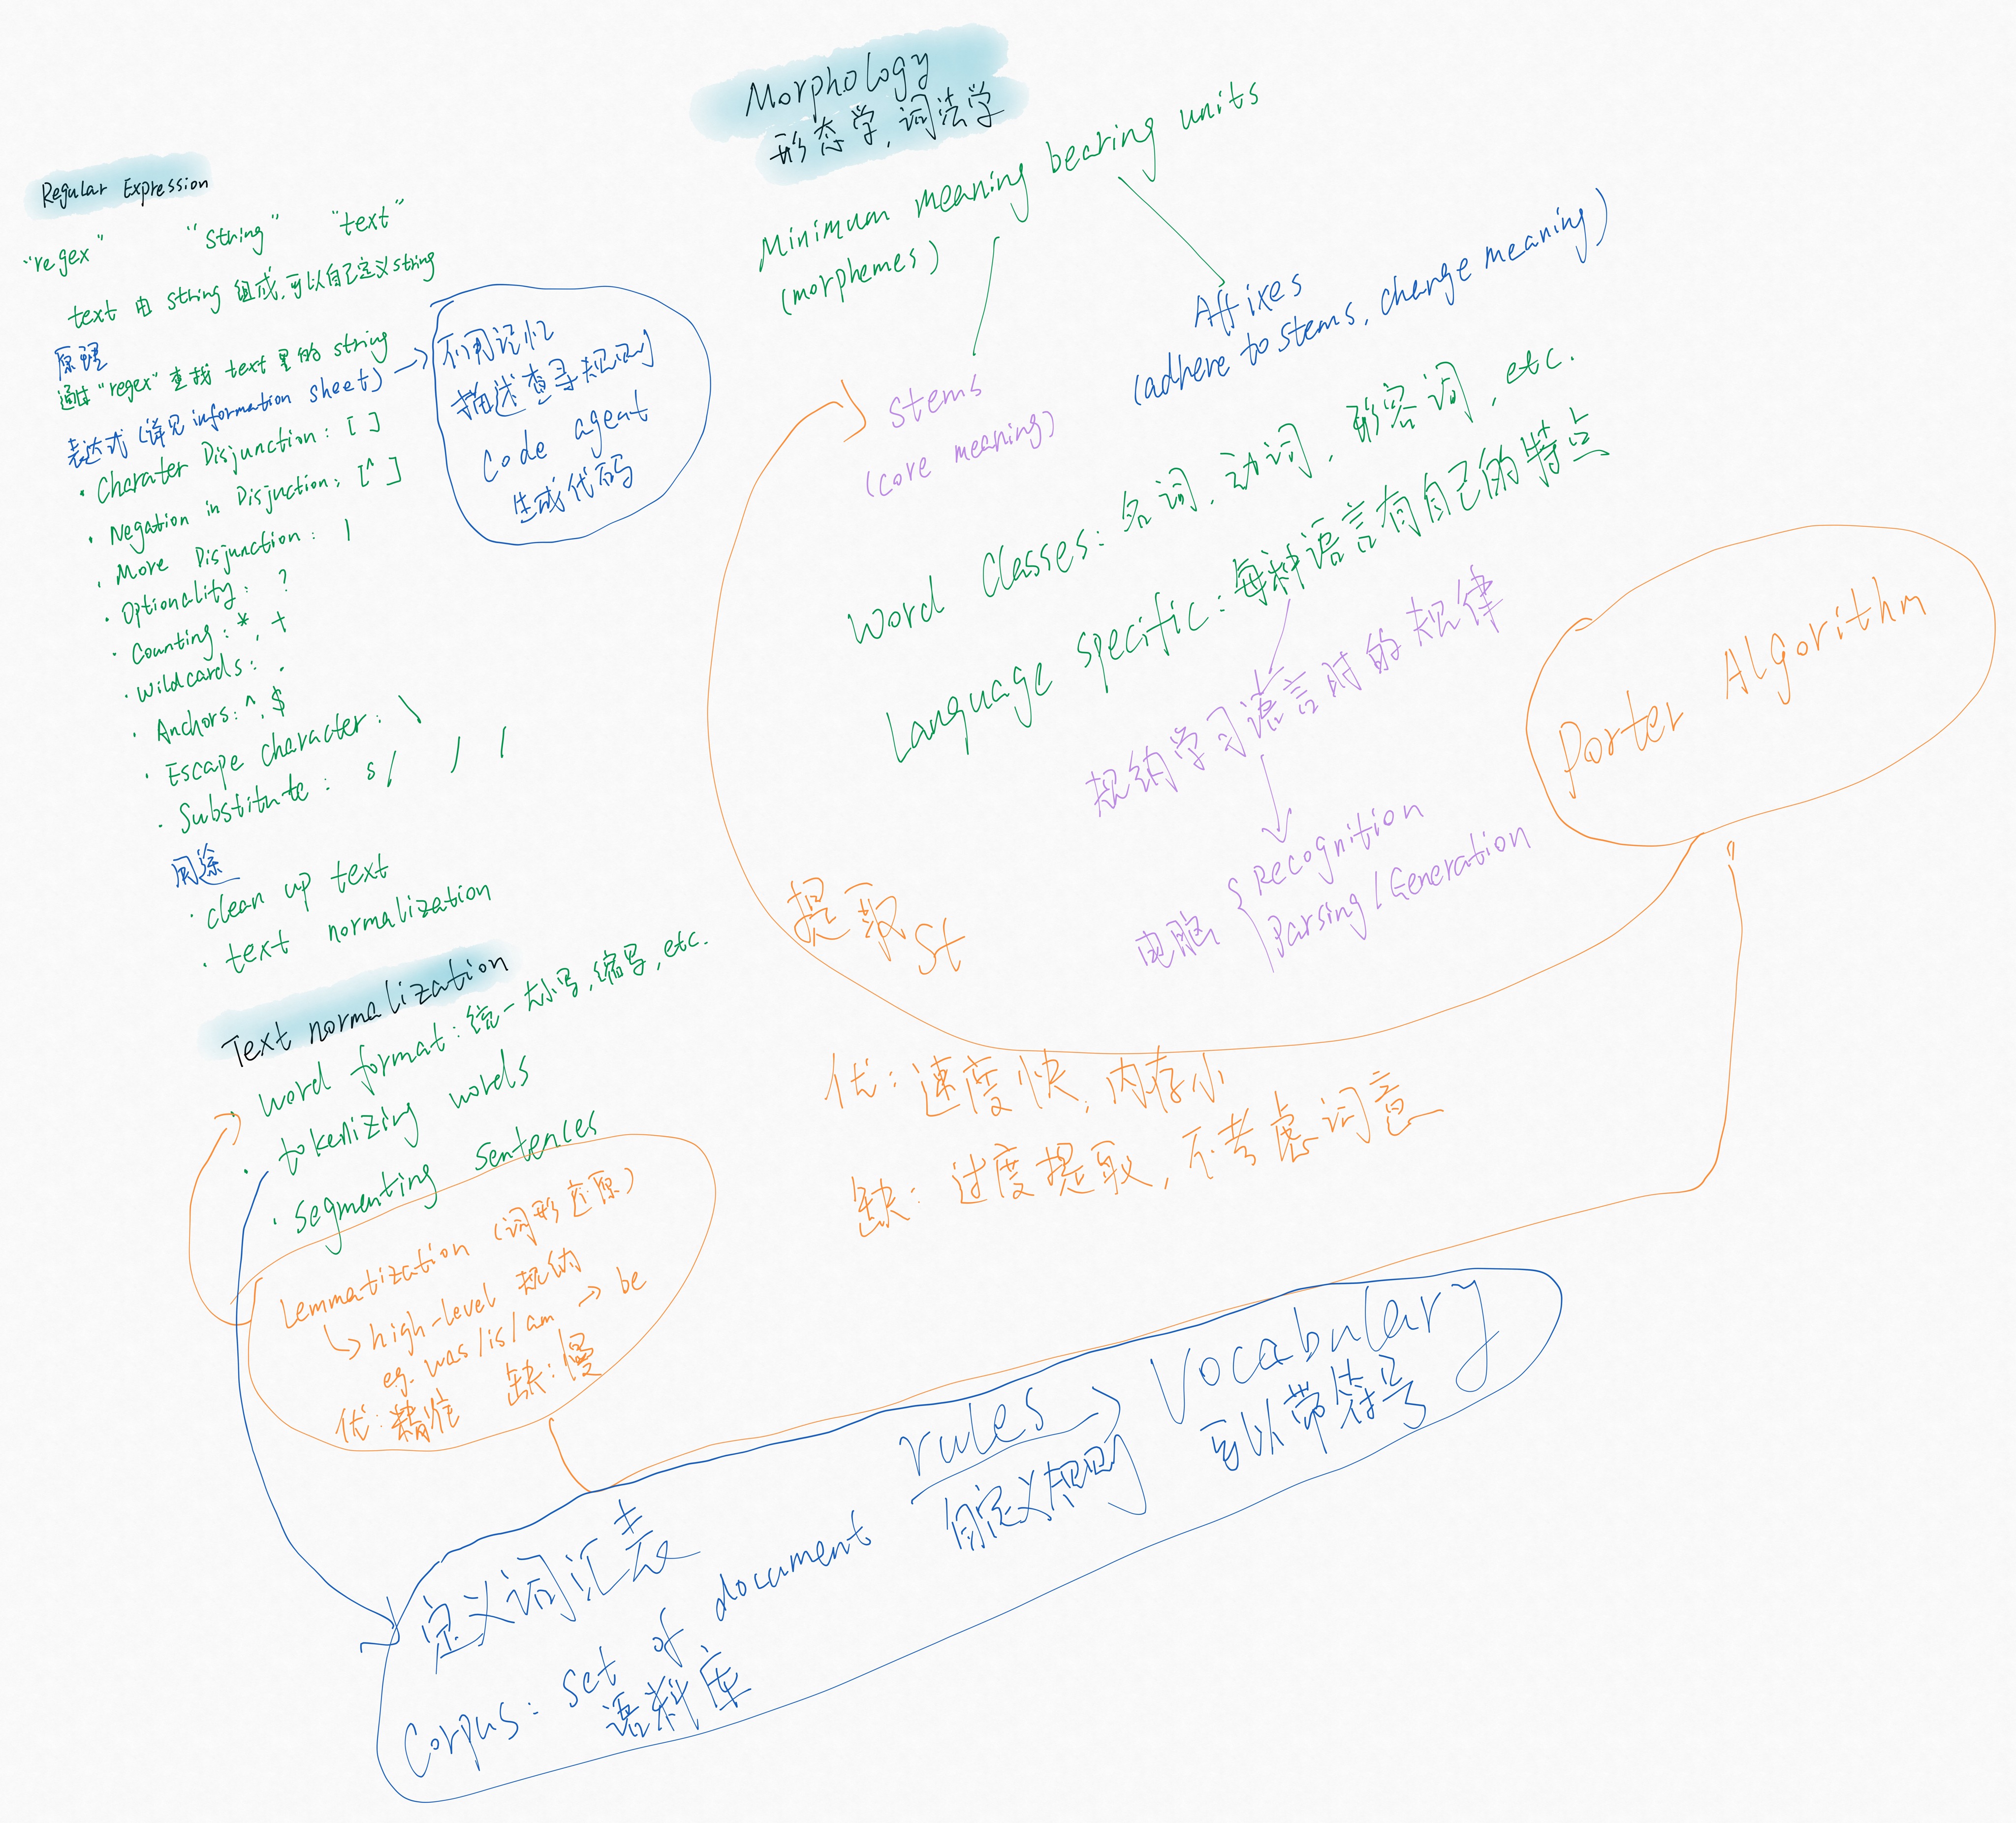
根据我的手写笔记整理;箭头表示概念之间的联系,不是必须依次执行的步骤。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
从词的结构到语境
学习语言时,我们会关注词如何构成、句子如何组织,以及说话者到底想表达什么。用这些问题理解 NLP,可以建立一张清晰的概念地图。
| 层面 | 关注的问题 | 例子 |
|---|---|---|
| 形态学 Morphology | 词内部如何构成? | walk 加上 -ed 成为 walked |
| 句法 Syntax | 词如何组成短语和句子? | The cat sat on the mat. 的主语和谓语 |
| 语义 Semantics | 词和句子表达什么意义? | 谁做了什么,动作涉及什么对象 |
| 语用 Pragmatics | 在此情境下,说话者想做什么? | “能把盐递给我吗?”通常是在请求 |
| 篇章 Discourse | 多个句子如何连接? | 后一句的“她”指向前文哪一个人 |
自然语言理解(NLU)与自然语言生成(NLG)分别关注解释语言和产生语言。“从词到意义,再从意图到表达”有助于入门,但不是所有系统都遵循的固定流水线,也不能证明计算机以与人相同的方式学习语言。
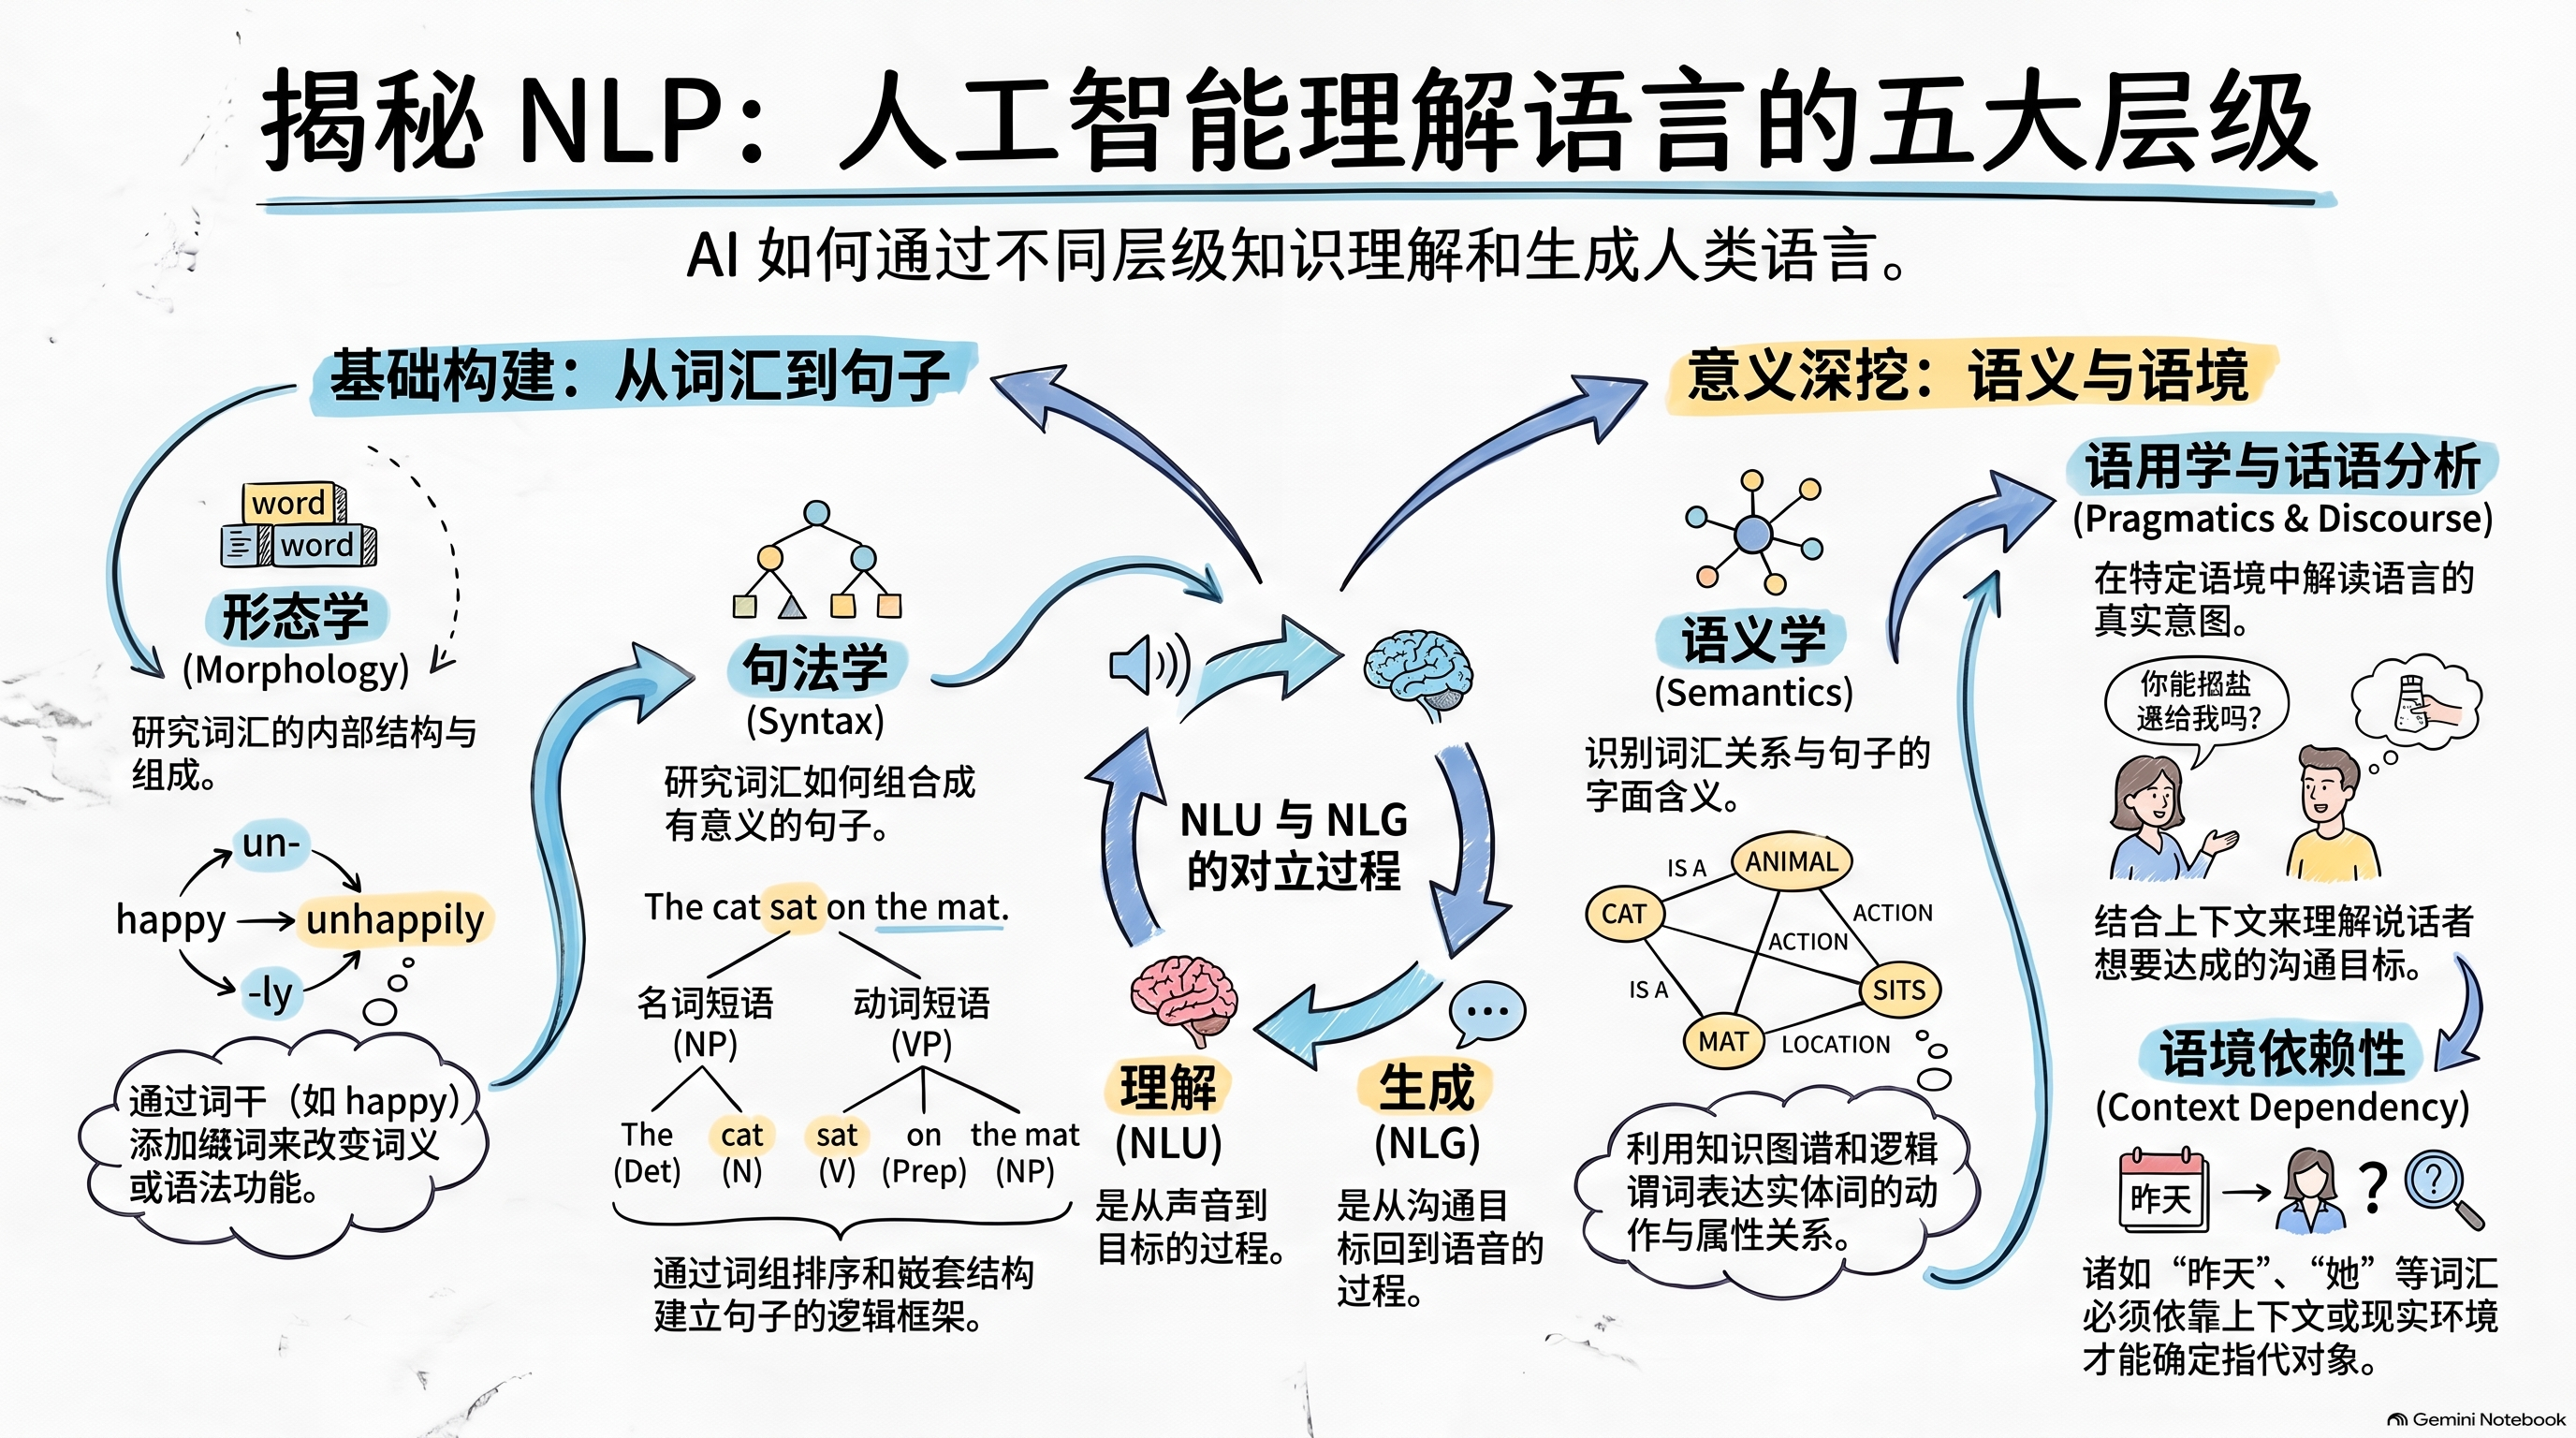
读图说明:图中的箭头是概念关系。语用与篇章可以分别讨论;理解与生成也不是严格互逆的计算过程。
词素、词根与词缀
词素(morpheme)是承载意义或语法功能的最小语言单位。词根承载词的核心意义;词缀附着在其他成分上,改变意义或语法功能。例如 cats 包含 cat 和复数词缀 -s。词干(stem)是进一步添加屈折词缀的基础,不一定等于词根。Words and Tokens
屈折变化表达数、时态等语法信息,例如 cat → cats;派生构成新词,例如 happy → unhappy。派生可以改变词性,也可以保持词性。中文学习中,偏旁部首帮助我们认识字形,但它们不等于词素,不能把英文的词根词缀分析直接套到汉字结构上。
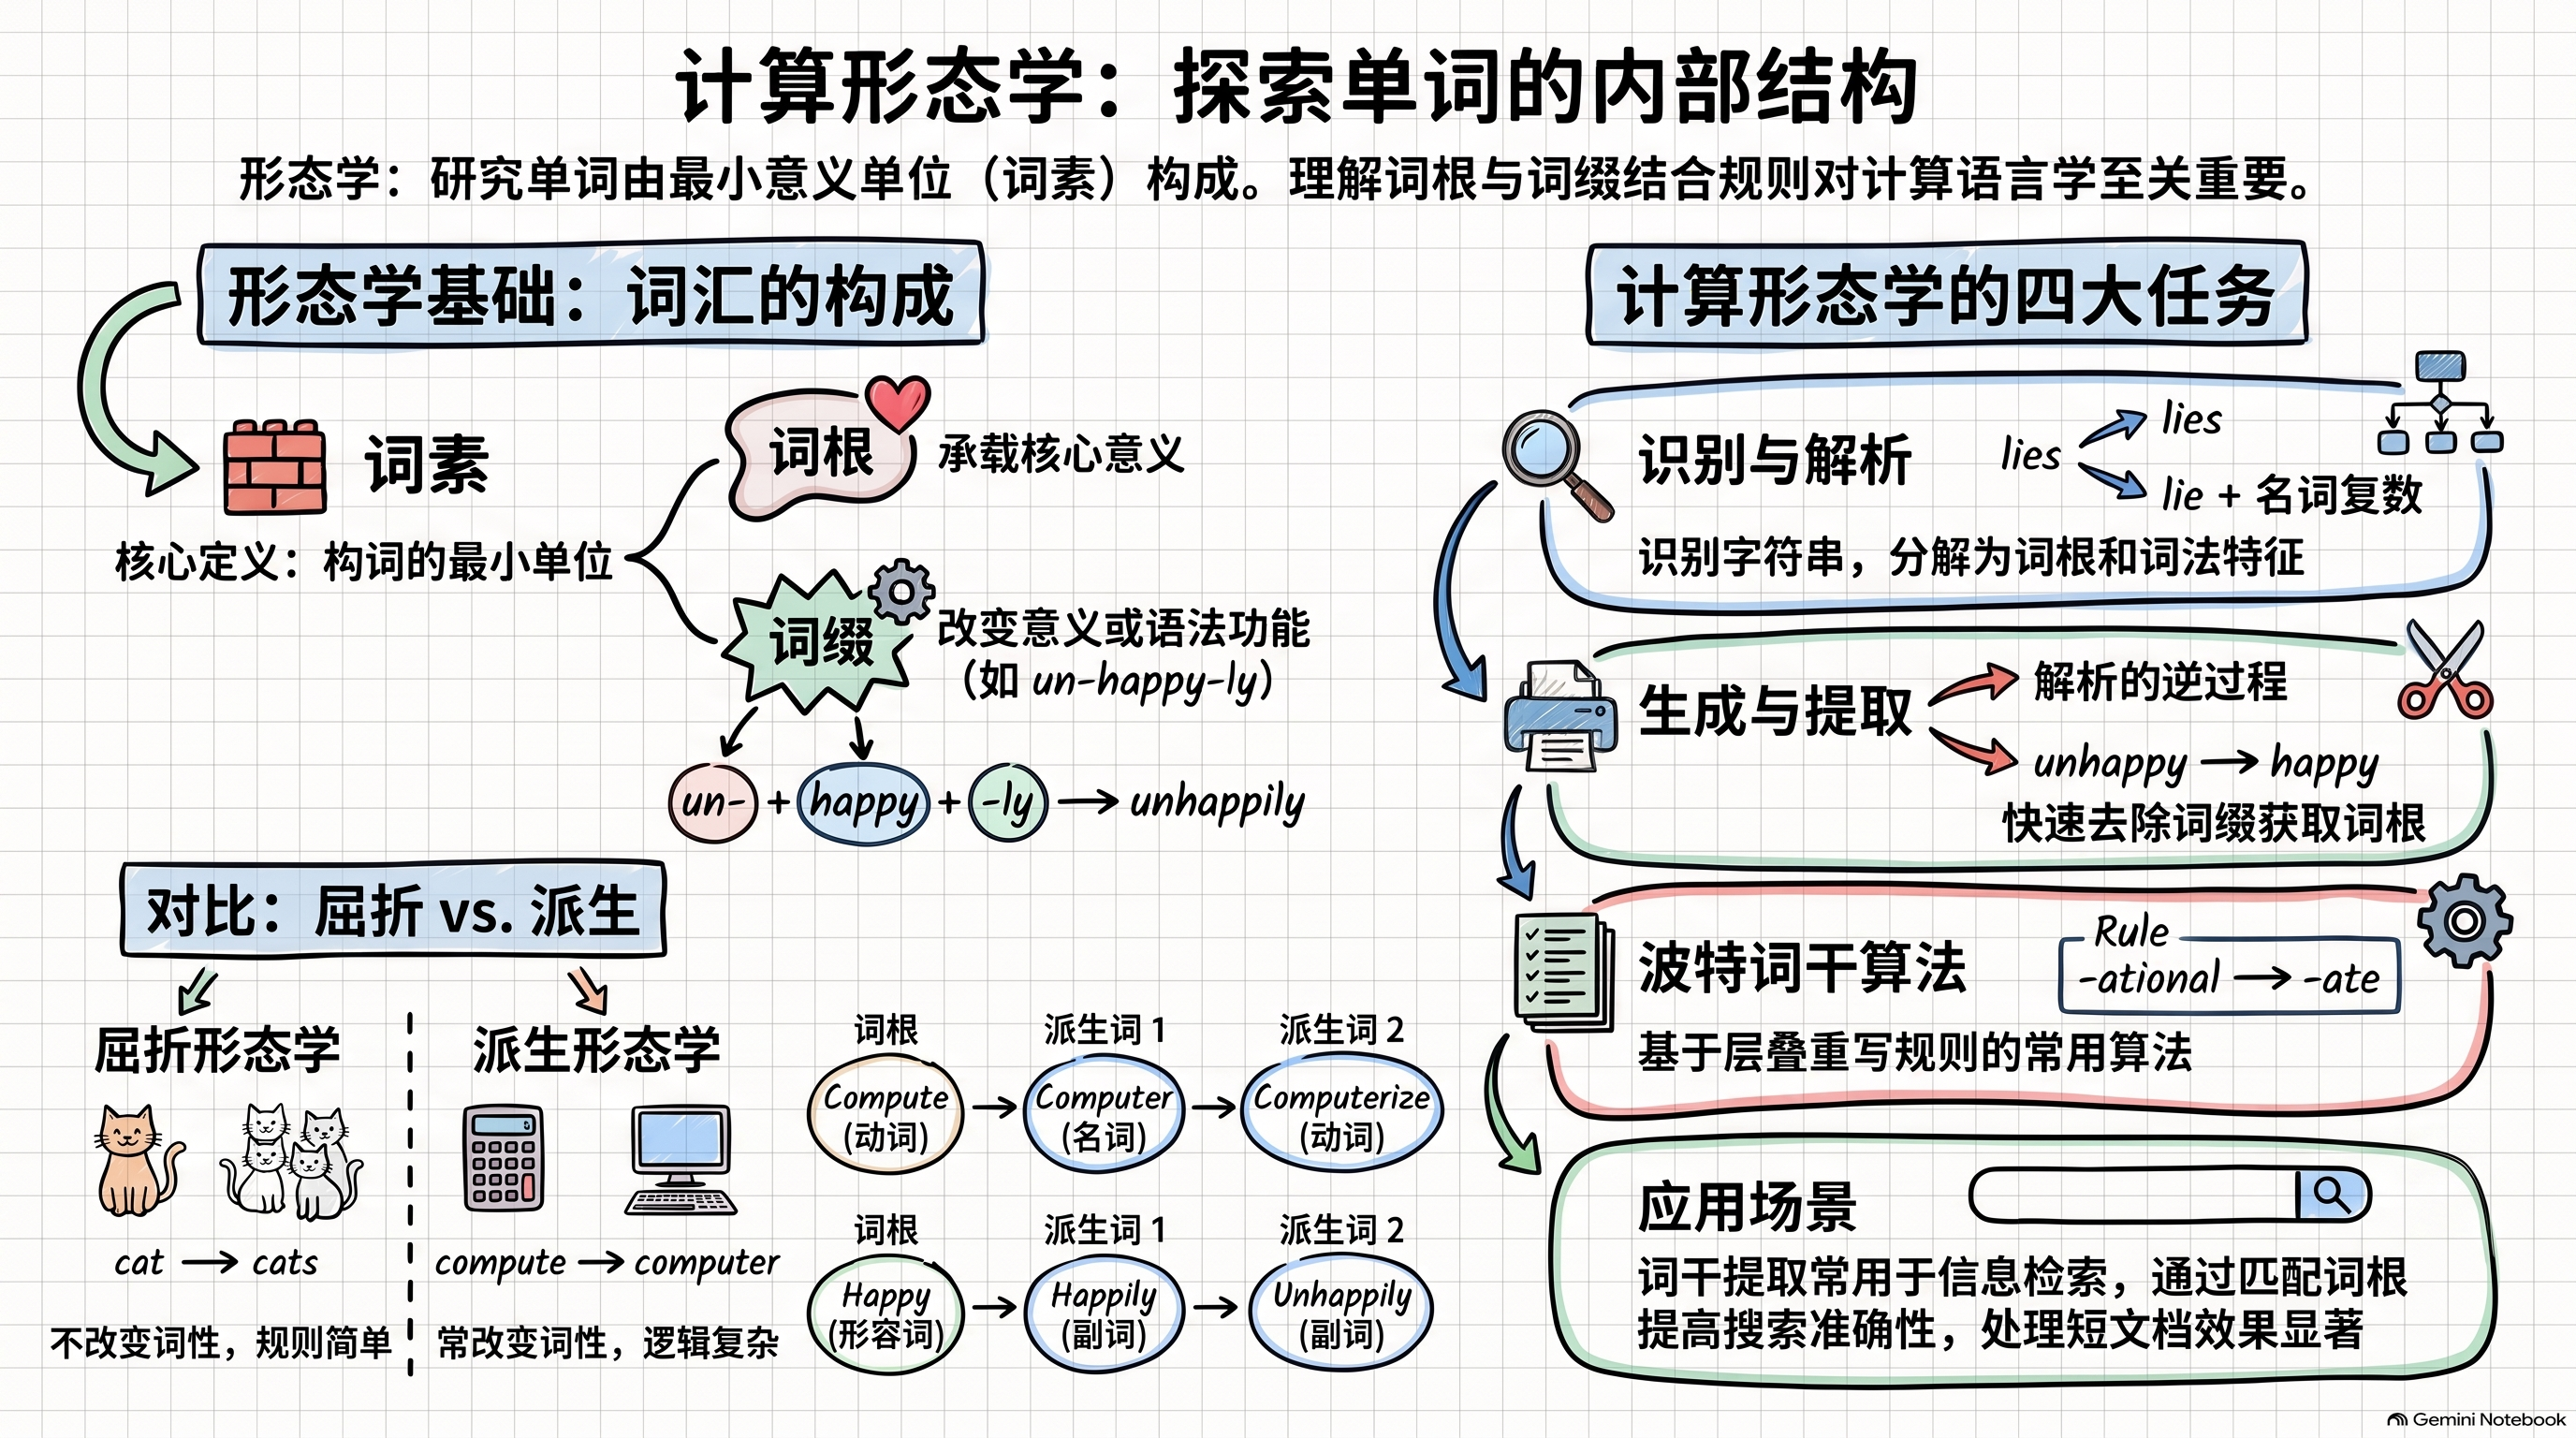
读图说明:lies 既可能是名词复数,也可能是动词形式,需结合上下文。图中的“提取词根”和“提高搜索准确性”是简化说法:词干提取不保证得到真正词根,也不保证提高检索效果。图示 unhappy → happy 不能当作 Porter 算法的通用规则。
把连续文本变成分析单位
分词(tokenization)把文本切分成处理单位。单位可以是词、子词或字符;token 不一定等于语言学上的词素。句子切分确定句界,而文本规范化统一选定的形式,例如多余空格或大小写。Words and Tokens
这些操作需要服务于研究问题。“清理得越彻底越好”并不是通用原则。以访谈分析为例,删除否定词可能改变受访者的意思;统一词形也可能丢失研究所需的时态差异。应保留原文,并明确每一步改变了什么。
语料库(corpus)是为分析而收集的文本集合;词汇表(vocabulary)则记录按既定规则得到的不同词项。采用不同的切分和规范化规则,同一份材料可能产生不同的词汇表。
词干提取与词形还原
| 方法 | 核心做法 | 如何理解结果 |
|---|---|---|
| 词干提取 Stemming | 按规则删改词的形式 | 结果可能不是一个词典词 |
| 词形还原 Lemmatization | 利用词典和形态信息寻找基本词形 | 结果取决于词性信息和所用工具 |
Porter 是面向英语的经典词干提取算法,按顺序和条件应用后缀规则。它不是简单地删除所有词缀,也不适用于所有语言。词形还原则可将动词 was 对应到 be;但不同工具在缺少词性信息时可能给出不同结果。Porter 算法;NLTK 词形处理示例
两种方法都可能帮助归并词形,但不能仅凭方法名称判断谁更准确或更快。应检查它们是否把研究中需要区分的表达错误地合并。
正则表达式:把文字模式写成规则
正则表达式(regular expression,简称 regex)用模式描述要寻找的字符串,适合搜索、替换和格式检查。它匹配的是文字形式;匹配到一个关键词,不等于理解了整句话。
下面用 Python 的正则语法演示。[wW] 选择单个字符,s? 允许一个可选的 s;\b 表示词边界。Python re 文档
import re

text = "Woodchuck woodchucks woodchuckish"
matches = re.findall(r"\b[wW]oodchucks?\b", text)
print(matches)  # ['Woodchuck', 'woodchucks']

print(re.sub(r" +", " ", "follow   up"))  # follow up
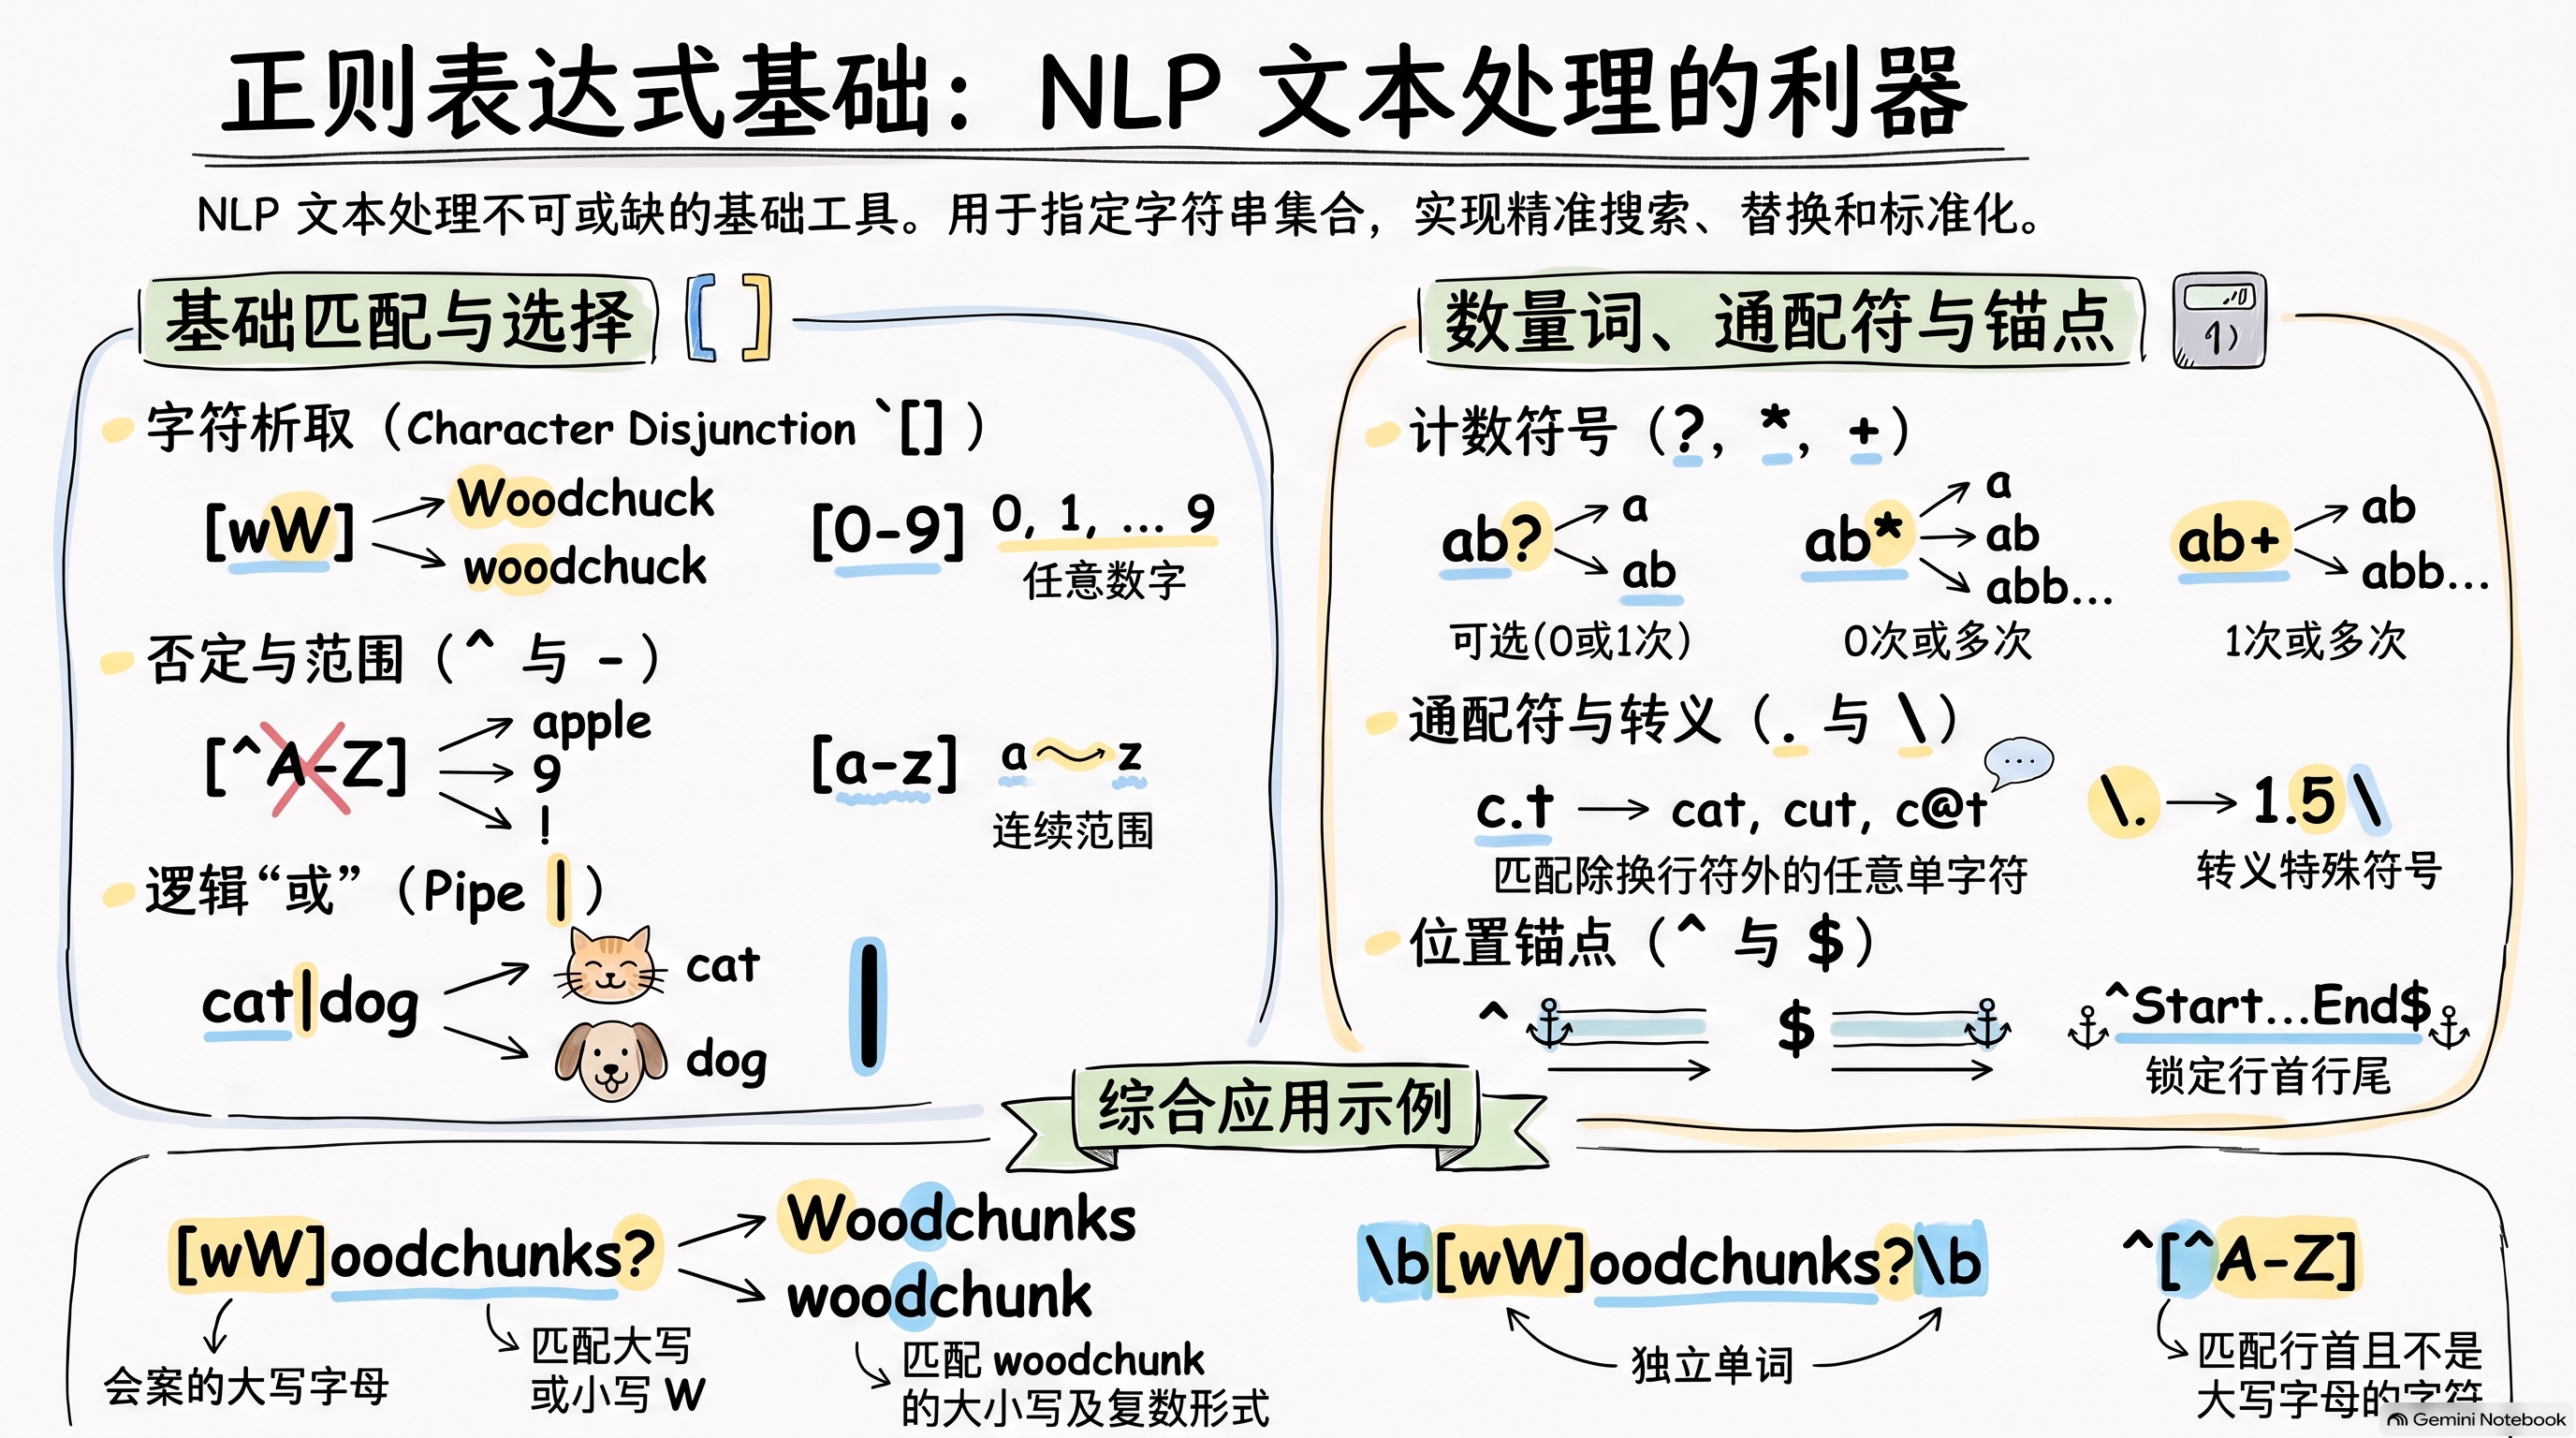
读图说明:[wW] 本身只匹配 w 或 W;应写 [wW]oodchucks?,图中的 woodchunks 拼写有误。[^A-Z] 只匹配一个非 ASCII 大写字母字符。\. 匹配句点,不匹配整个 1.5。^、$ 的行为与多行模式有关;. 默认不匹配换行。英文配图中的 color/colour 示例应写 colou?r;[^aeiou] 也会匹配数字等非元音字符。
例如,在英文访谈中搜索 pain,会同时找到 “I have pain” 和 “I have no pain”。规则能定位待阅读的片段,是否存在某种经历或观点仍需结合上下文判断。
我的思考
我开始学习这些内容,是想理解 NLP 到底如何工作。过去我觉得它的方法很复杂;现在,词的结构、句子的组织和意义之间的联系,让这个领域更容易进入。把它类比为学习语言,是对我有帮助的起点,但这个类比不足以解释现代模型的全部机制。
对我来说,这一期不必以记住每一种方法为目标。代码助手可以协助实现简单规则,而我更想理解规则为什么这样设计,以及哪些判断仍需要由人来做。
了解文本处理的基础逻辑后,我可以把研究问题拆解成明确的处理步骤,让计算机按照我设定的规则处理健康相关文本或笔记。我需要决定寻找什么、保留什么,以及如何检查结果。
例如:从患者访谈中整理预约等待的经历
假设我想了解患者预约看诊时的等待经历。下面是三个虚构的访谈片段,以及人工阅读时需要保留的区别:
| 访谈片段 | 需要保留的信息 |
|---|---|
| “我等了三周才约到医生。” | 提到预约等待,时长为三周;是否归为“等待过长”,还需先明确研究中的判断标准。 |
| “这次没有等很久,很快就约上了。” | 明确否定等待很久,不能只因为出现“等”就标记为等待困难。 |
| “以前要等很久,现在好多了。” | 过去等待较久,目前有所改善,需要保留时间上的区别。 |
我可以把处理过程设计成几个步骤:
- 明确目标:寻找预约等待的经历,先定义哪些表达属于研究范围。
- 统一形式并保留原文:例如把“三周”和“3 周”记录为相同的时长,同时保留原句供回查。
- 定位候选片段:用关键词或正则表达式寻找预约、等待和时长相关的表达。
- 检查否定和时间:结合上下文区分“没有等很久”和“等很久”,以及“以前”和“现在”。
- 整理并核对:输出原句、等待时长、否定表达和时间信息,再与一小批人工阅读结果比较,检查漏选和误选。
这个例子让我更清楚地理解自己在其中的作用:定义处理目标、制定规则,并检查结果。正则表达式能帮助定位文字模式,但“现在好多了”具体指什么,仍可能需要更复杂的方法或人工判断。这是我想尝试的应用思路,还没有经过实际验证。
我仍想弄清:为了更有效地使用 NLP,我需要掌握哪些基础知识?下一步可以继续学习分词和上下文处理,观察简单规则在哪些地方不再够用。
学习来源
本篇由 UBC “Natural Language Processing to Improve Patient Care” 微证书课程学习笔记整理而成,母稿记录的课程为 “Overview of NLP and Large Language Models”。技术核对使用正文链接的 Stanford 教材、Python 官方文档、Porter 算法说明和 NLTK 示例。
动手探索
想亲手探索正则表达式,可以使用 regex101 在线练习工具:输入表达式和示例文本,查看匹配结果与逐项解释。尝试本文示例时,先将 Flavor 选择为 Python,以便与代码语法保持一致。