
NLP 学习笔记 / NLP004
从词义到知识图谱:词位、WordNet、FrameNet 与知识图谱
上一期讲了怎样把文本切成 token、给词贴上词性和实体标签。这一期往前走一步:当算法开始理解词义和句意,就可以理清词与词、句子与句子之间的关系,再把这些关系连起来,形成知识图谱。这条路可以分成四站:词位 → WordNet → FrameNet → 知识图谱。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
同形异义与一词多义
同形异义:形式相同、意思无关,例如河岸和银行。一词多义:同一个词的几个义项彼此相关,例如银行和血库。
同义词集 synset
一组表达同一概念的近义词。WordNet 连接的是同义词集而不是单个词,所以 car、auto、automobile 指向同一个概念。
语义框架
描述一类情境及其参与者的结构。I ate a sandwich 中,ate 唤起 Ingestion(进食)框架:I 是进食者,sandwich 是被吃的东西。
知识图谱
把事实存成“实体—关系—实体”的连接,例如 阿莫西林 —可治疗→ 肺炎,从而可以查询和互相连接。
全景图:从词义到知识图谱
沿紫色箭头读:左上的词位是起点,WordNet 把词义整理成概念网络,紫色大弧线走到右侧的 FrameNet,从单个词走向事件结构,最后落到底部的知识图谱和医学知识资源。右下角是我的主要收获。
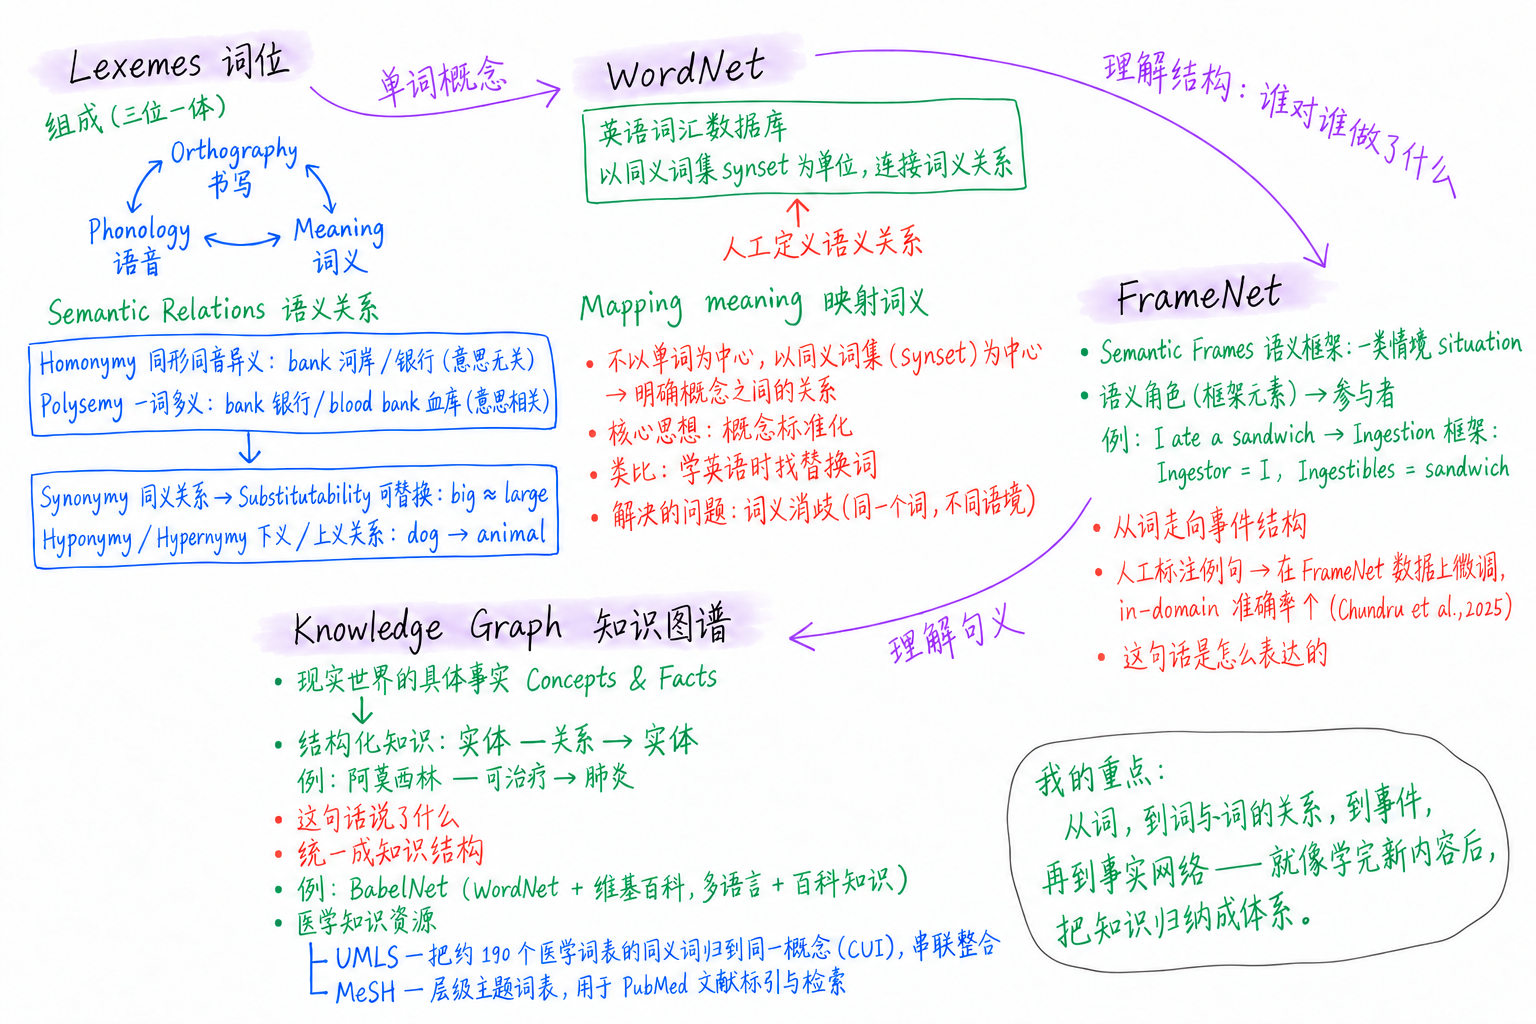
根据我的手写笔记整理,做了几处修正和补充。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
第一站:词位——词的形式与意义
词位(lexeme)是词汇的基本单位:一个特定的形式(书写和读音)与它的意义配成一对。这三个面向分别是:
| 面向 | 英文 | 例子 |
|---|---|---|
| 书写 | Orthography | content 的拼写 c-o-n-t-e-n-t |
| 语音 | Phonology | 名词读 /ˈkɒntent/,形容词读 /kənˈtent/ |
| 词义 | Meaning | 名词“内容”;形容词“满足的” |
同一个拼写不一定是同一个词位:content 作名词和形容词时,读音和意义都不同,是两个词位。反过来,run、runs、ran 形式不同,却属于同一个词位,词典里用 run 作代表(这个代表形式叫 lemma)。SLP3 附录 I
词与词之间的语义关系
理解词义之后,下一步是描述词与词的关系。四种最常见的关系:
| 关系 | 含义 | 例子 |
|---|---|---|
| 同形异义 Homonymy | 形式相同,意思毫无关联 | bank:河岸 / 银行 |
| 一词多义 Polysemy | 一个词有多个彼此相关的义项 | bank:银行 / blood bank 血库(都是“储存之处”) |
| 同义 Synonymy | 不同的词,意思相同或相近;判断标准是能否互相替换而不改变句意 | big ≈ large |
| 上下义 Hyponymy / Hypernymy | 具体类别与上位类别的层级关系 | dog 是 animal 的下义词,animal 是 dog 的上义词 |
同义关系往往只在某些语境下成立:How big is that plane? 可以换成 large;但 big sister(姐姐)不能换成 large sister。所以“可替换性”需要放在语境里判断。SLP3 附录 I
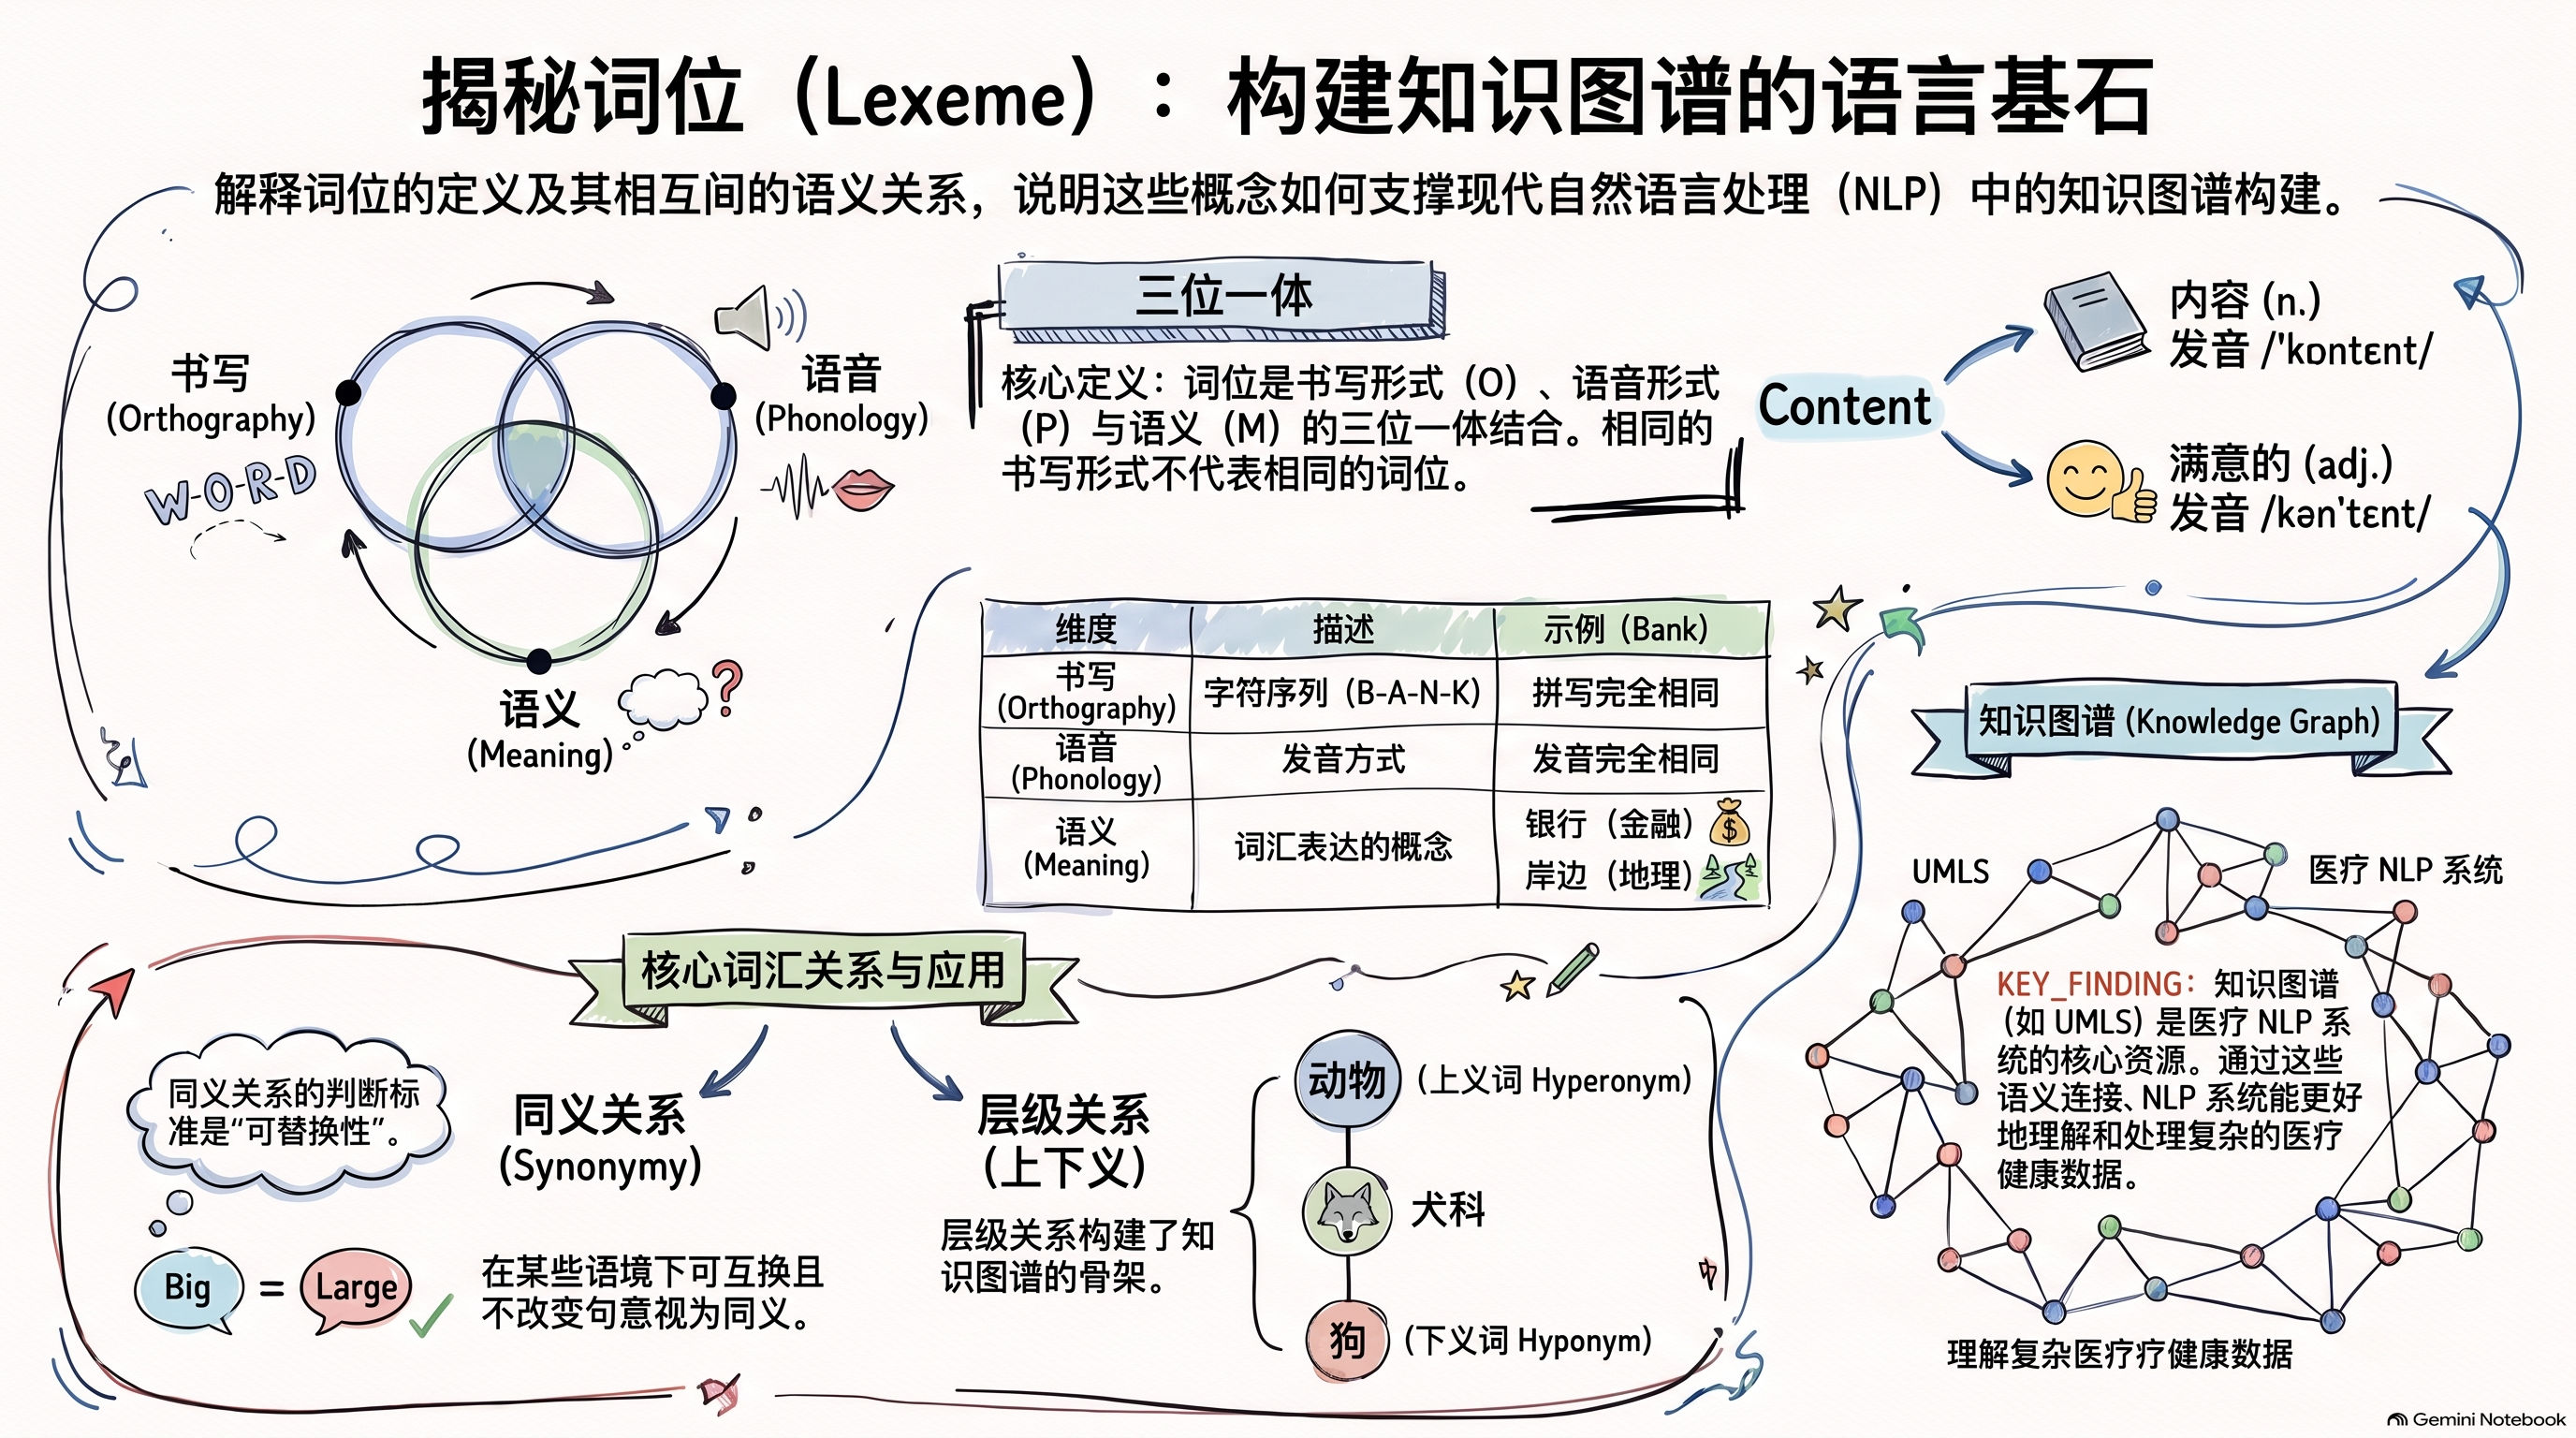
阅读提示:右下角的“KEY_FINDING”是生成图时留下的标签,可以理解为“要点”。图中把“动物 → 犬科 → 狗”画成一条上下义链,这是对的;同义关系的“可替换”要加上“在某些语境下”。
第二站:WordNet——把词义整理成概念网络
WordNet 是普林斯顿大学建立的英语词汇数据库。它最关键的设计是:不以单词为中心,而以同义词集(synset)为中心。一个 synset 是一组表达同一概念的近义词,并附有释义(gloss)。例如 car、auto、automobile、machine、motorcar 同属一个 synset,代表“汽车”这个概念。
这样做的好处是把概念标准化:同一个概念不管用哪个词说,都对应同一个节点;一个多义词则分属多个 synset。WordNet 再由人工定义 synset 之间的关系,形成网络:
- 上下义:dog → canine → animal,层层往上可以到最抽象的 entity。
- 整体—部分(meronymy):engine 是 car 的一部分。
- 反义:hot ↔ cold(主要用于形容词)。
WordNet 3.0 收录约 11.8 万个名词、1.15 万个动词。名词平均有 1.23 个义项,动词平均有 2.16 个,动词的多义性更高。SLP3 附录 I
它解决的问题:词义消歧
词义消歧(word sense disambiguation, WSD)是判断一个词在当前语境里用的是哪个义项。例如 “I deposited cash at the bank” 和 “We sat on the river bank” 中的 bank 属于不同 synset。WordNet 提供了“候选义项清单”和义项之间的关系,所以长期是 WSD 研究的标准词义库。
这和我学英语时的方法很像:遇到一个多义词,在不同句子里分别找它能替换的同义词,就能分清它在这里是哪个意思。
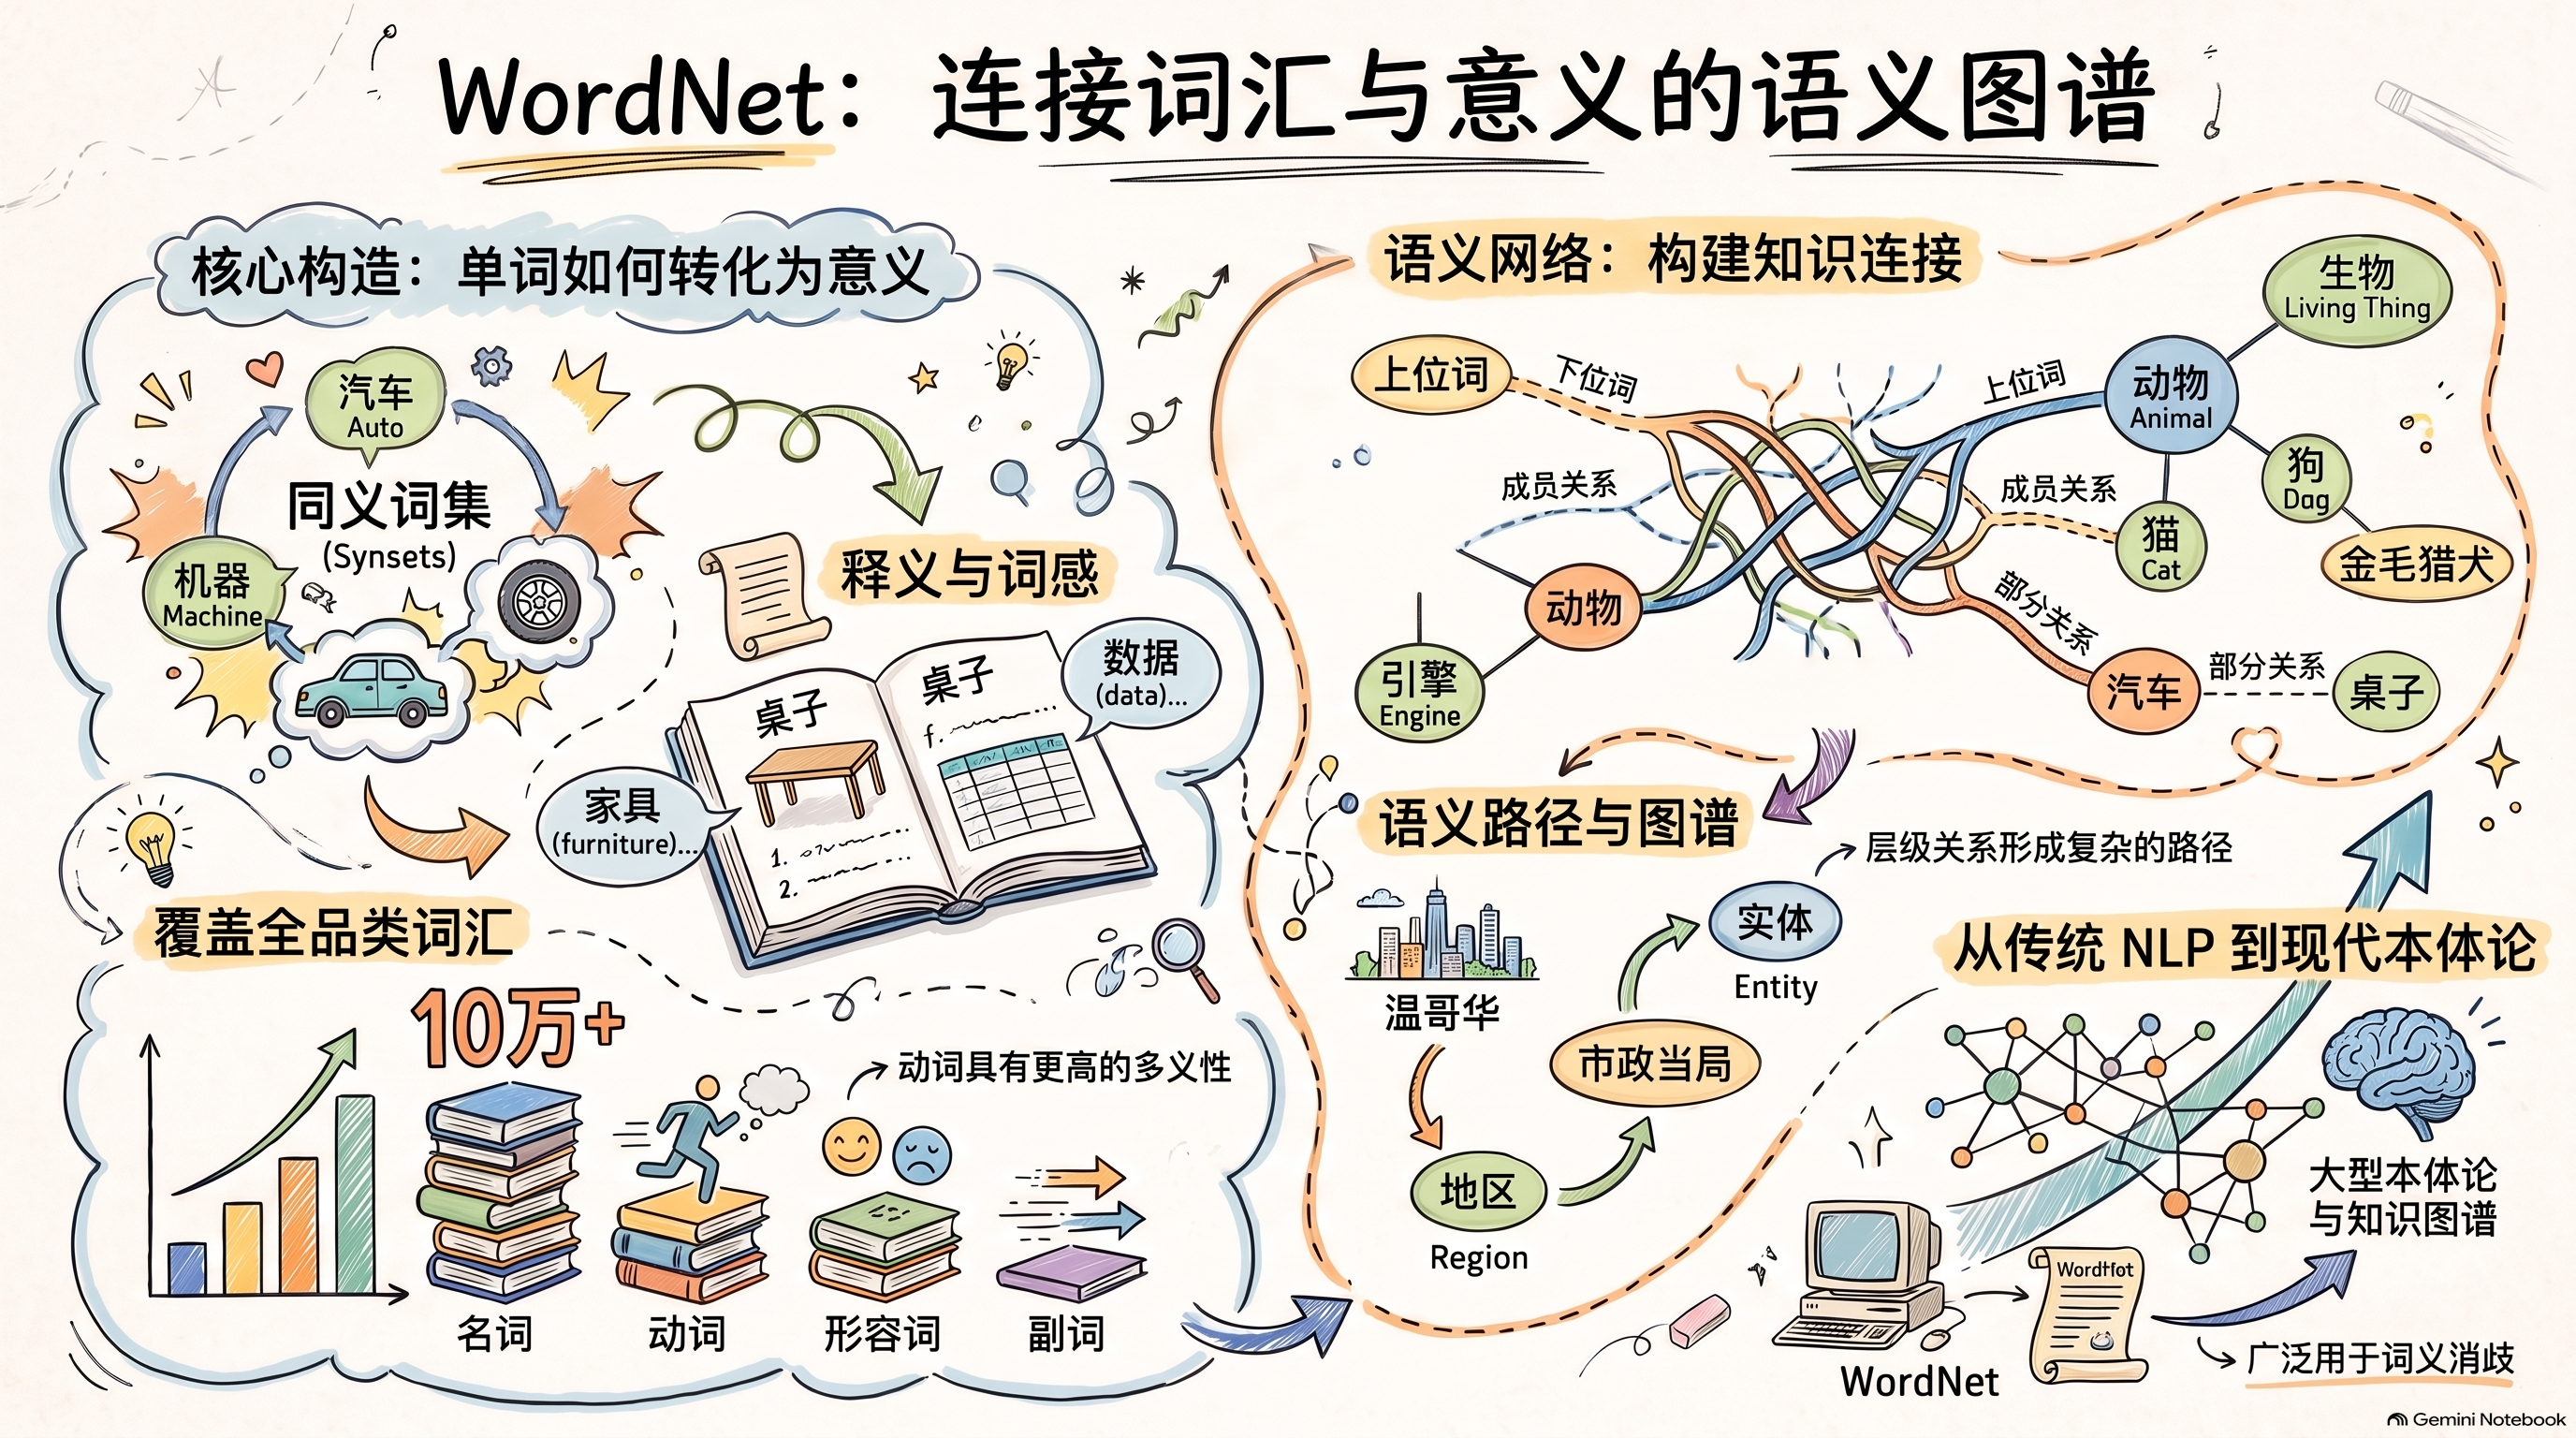
阅读提示:右上角网络中,“成员关系”和“部分关系”属于整体—部分关系(meronymy),与“上位词/下位词”的层级关系是两回事。“机器 Machine”在 WordNet 里确实是 car 的一个同义词,但这是较少见的用法。
第三站:FrameNet——从词走向事件
WordNet 擅长回答“这个词是什么意思”,但不擅长回答“这句话里谁对谁做了什么”。FrameNet 补上的就是这一块。
FrameNet 的核心是语义框架(semantic frame):描述一类情境的背景知识结构,并定义这类情境里的参与者,称为框架元素(frame elements),也就是语义角色。句子里的某个词会“唤起”一个框架。SLP3 第 22 章
| 句子 | 唤起框架的词 | 框架 | 框架元素 |
|---|---|---|---|
| I ate a turkey sandwich. | ate | Ingestion(进食) | Ingestor(进食者)= I;Ingestibles(被吃的东西)= a turkey sandwich |
| The company hired Maria as a nurse. | hired | Hiring(招聘) | Employer = the company;Employee = Maria;Position = a nurse |
不同的动词可以唤起同一个框架:hire、employ、retain 都属于 Hiring。这样,即使说法不同,计算机也能认出它们描述的是同一类事件。FrameNet 目前约有 1,200 个框架,框架之间也有层级关系,类似 WordNet 的上下义。
人工标注的价值
FrameNet 的框架和角色由语言学家人工定义,并配有大量人工标注的例句。这些例句把人对语句的理解规范化,可以直接用来训练模型。Chundru 等人(2025)发现,大语言模型不经专门训练也能较好地识别框架;在 FrameNet 标注数据上微调后,in-domain(与训练数据同类的文本)准确率大幅提升,同时在 out-of-domain 基准上也保持了不错的泛化。Chundru et al., EMNLP 2025
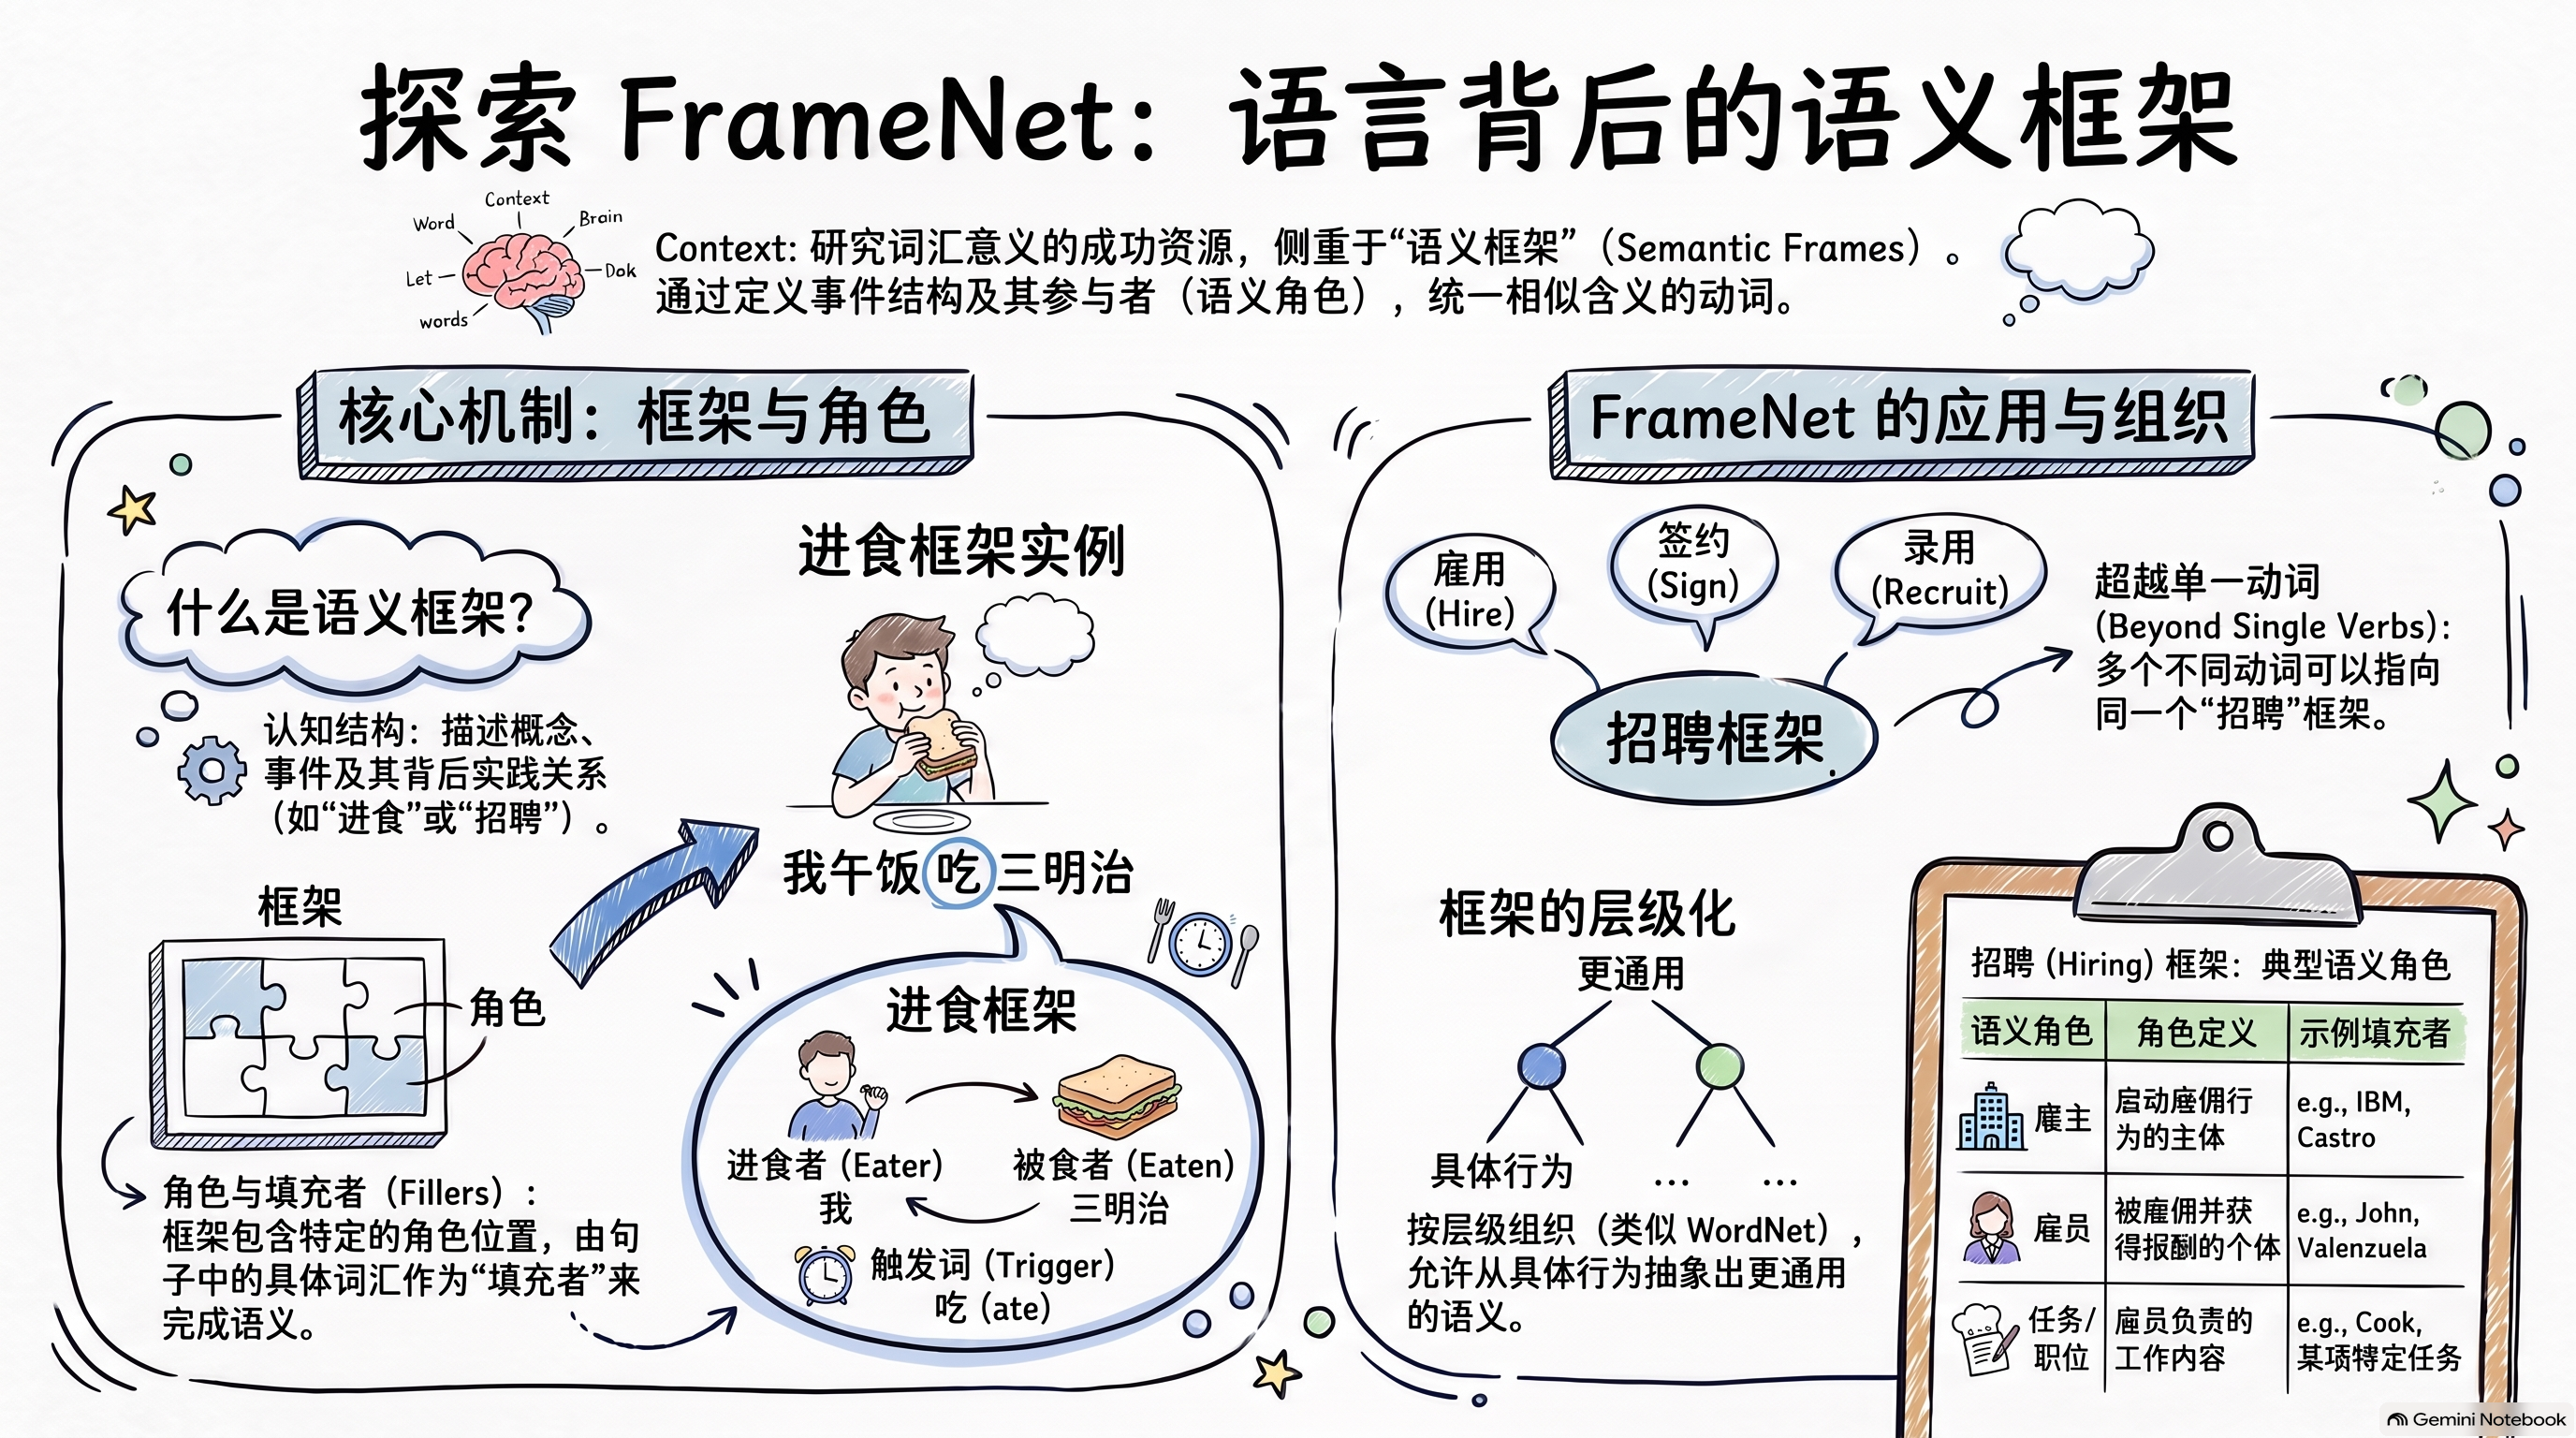
阅读提示:图中的“进食者 / 被食者”在 FrameNet 里的正式名称是 Ingestor / Ingestibles;“触发词”指唤起框架的词(这里是“吃”)。
第四站:知识图谱——把事实连成网络
FrameNet 回答“这句话是怎么表达的”,知识图谱关心的是“这句话说了什么”。知识图谱(knowledge graph)把现实世界的概念和事实表示成“实体—关系—实体”的结构,例如:
- 阿莫西林 —可治疗→ 社区获得性肺炎
- 肺炎 —是一种→ 肺部疾病
当大量事实统一用这种结构表示,知识就从分散的句子变成了可以查询、推理和连接的网络。词汇资源(WordNet、FrameNet)提供了概念和关系的骨架,后来的知识图谱再从百科和网页里大规模抽取事实。
| 资源 | 特点 |
|---|---|
| YAGO(2007 起) | 结合维基百科与 WordNet,事实带有时间和空间信息 |
| Freebase → Wikidata | 协作编辑的大型知识库;Freebase 2016 年关闭后数据迁往 Wikidata |
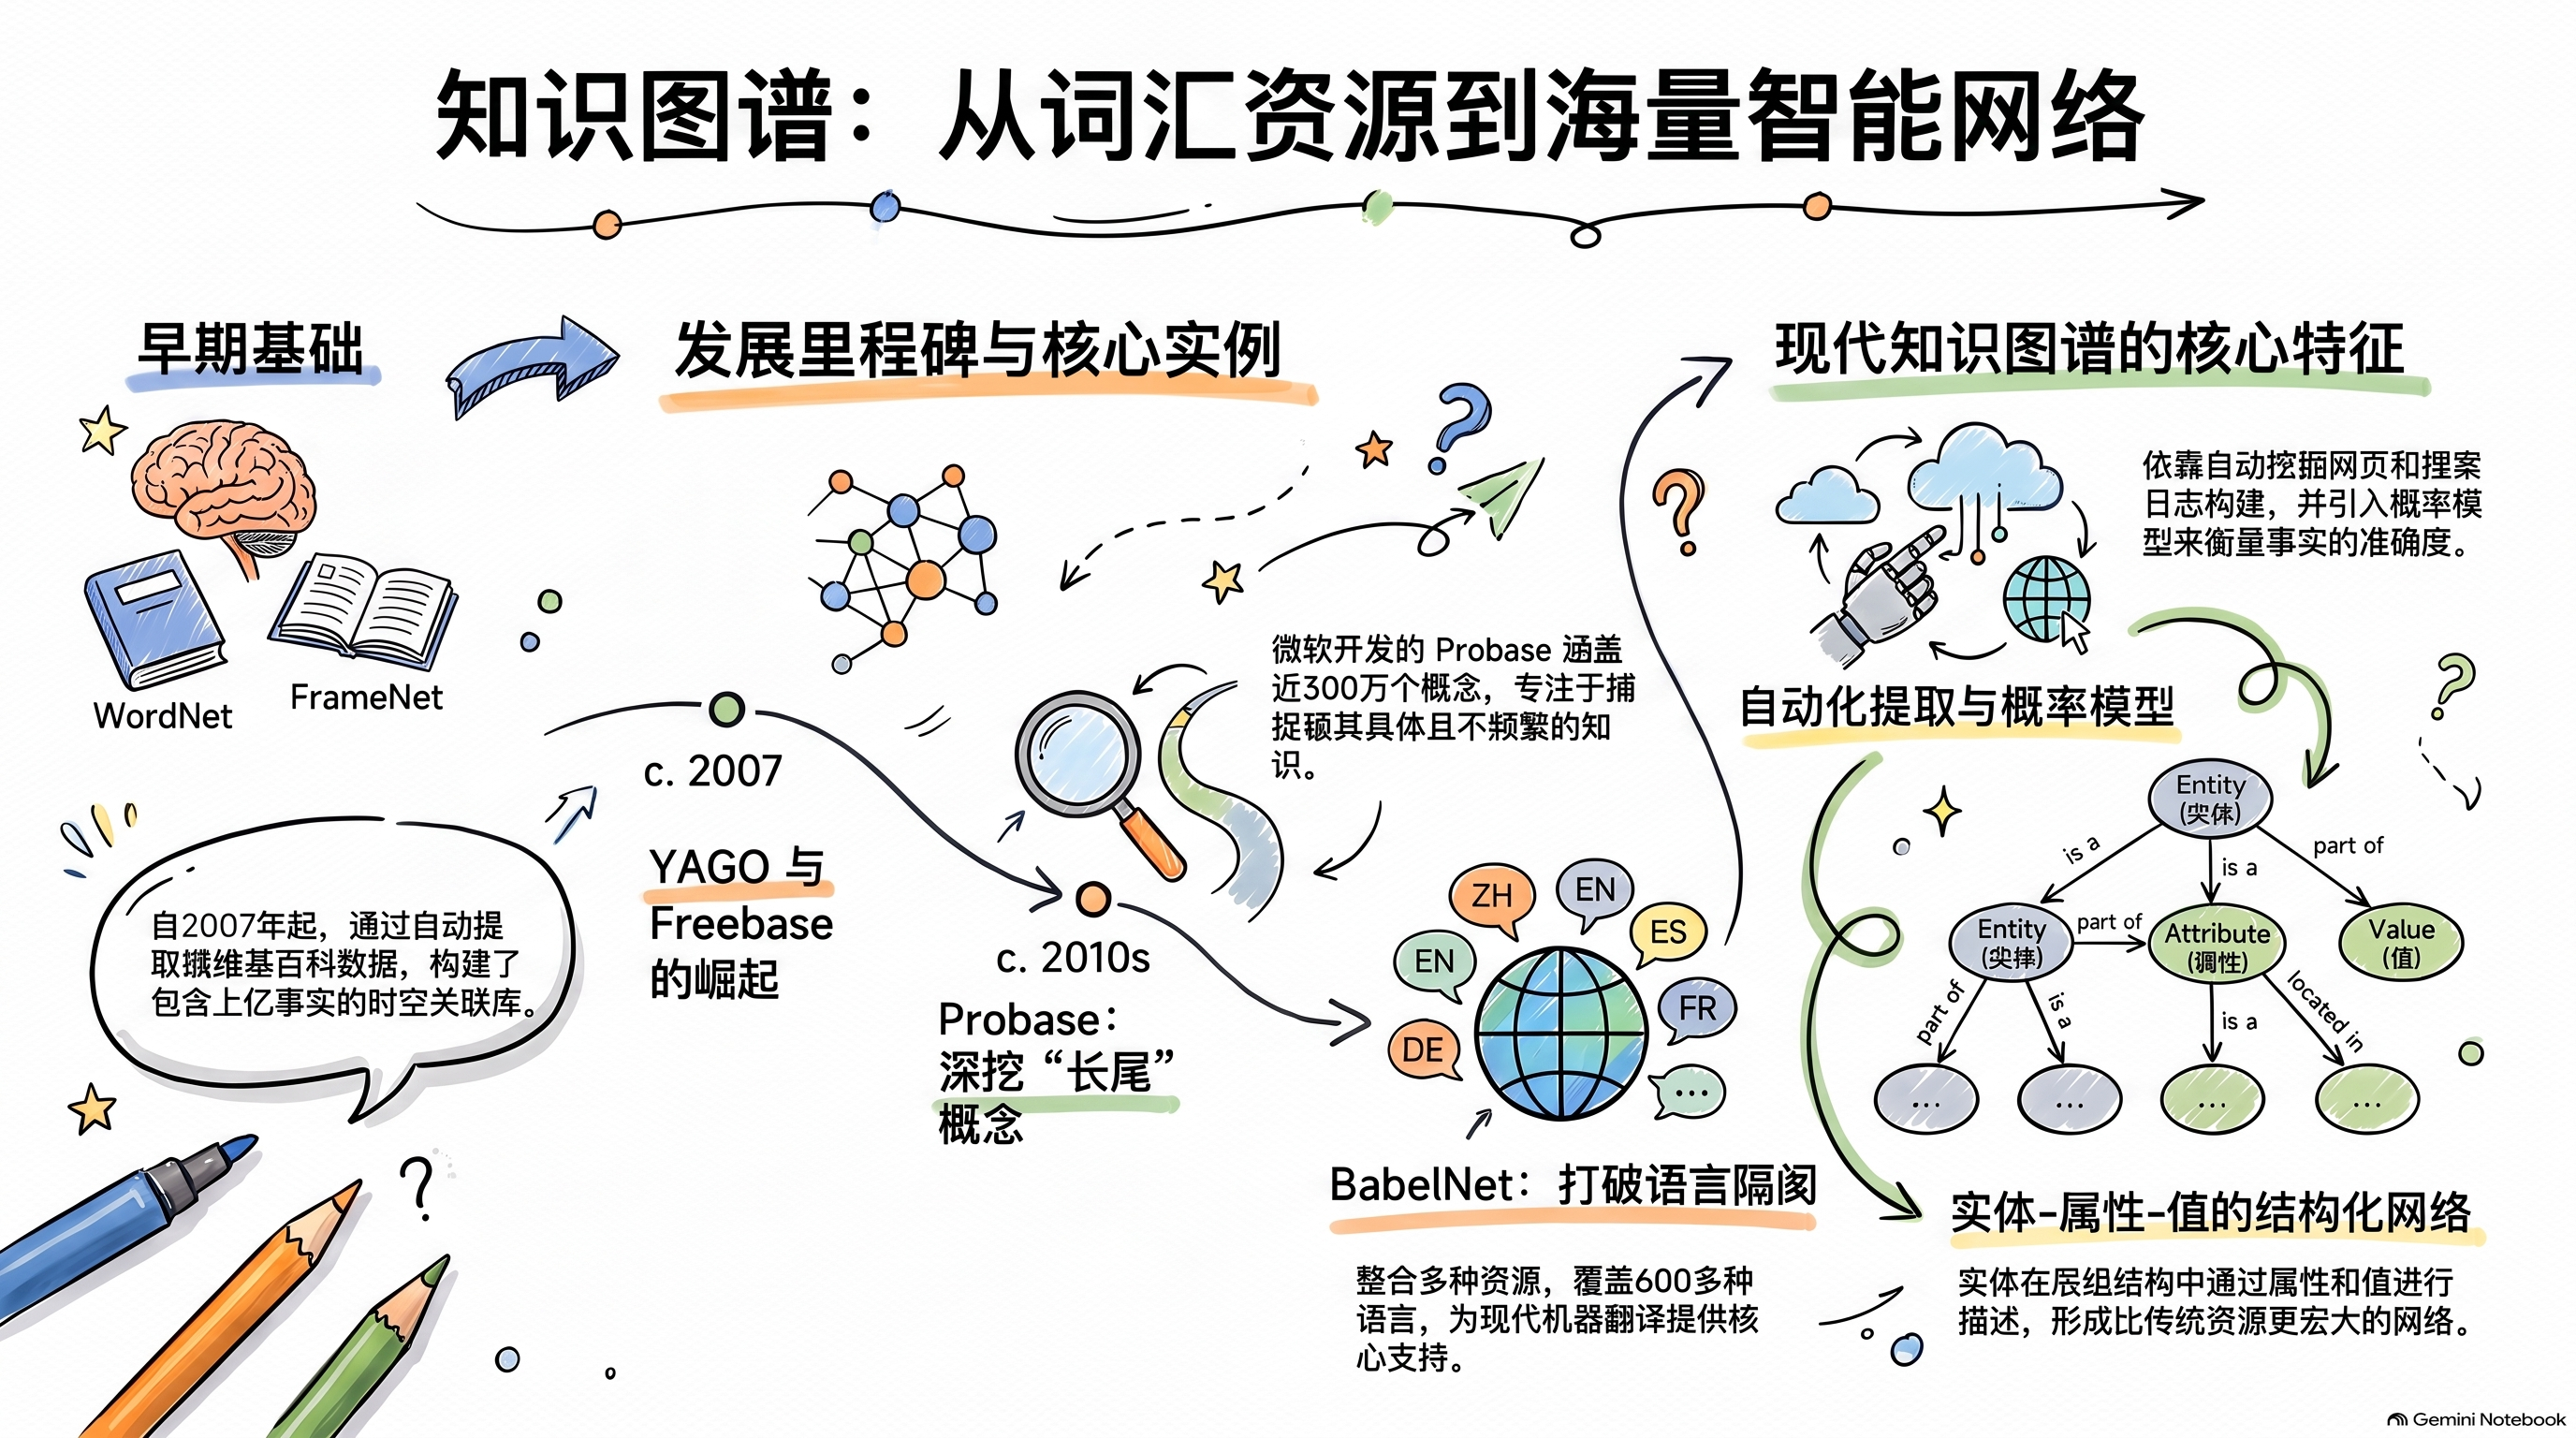
| Probase | 微软从网页中自动挖掘概念,约 270 万个概念,覆盖许多不常见的“长尾”概念 |
| BabelNet | 把 WordNet 与维基百科等资源整合成多语言、百科式的语义网络,覆盖约 600 种语言 |
BabelNet:覆盖更广,结果也更分散
BabelNet 比 WordNet 更全面,因为它把词义和多语言知识、百科知识连在了一起。About BabelNet 但覆盖更广也让结果更分散。我搜索 library 时,BabelNet 不仅返回了“图书馆”这个常见概念,还返回了一些冷门实体,包括某位歌手的一首歌。这正是它的优点和局限:语义网络更丰富,但也会带来不太相关或过于具体的结果,需要使用者自己筛选。
医学里的知识资源:UMLS 与 MeSH
医学领域同一个概念往往有很多说法:心肌梗死、心梗、MI、heart attack。医学 NLP 最常用的两个知识资源,正是为了解决这一点,但分工不同。
| UMLS 统一医学语言系统 | MeSH 医学主题词表 | |
|---|---|---|
| 是什么 | 美国国家医学图书馆(NLM)整合的“元词表”(Metathesaurus),加上语义网络和专业词典 | NLM 编制的受控、层级化主题词表 |
| 怎么组织 | 把约 190 个来源词表(SNOMED CT、ICD-10-CM、RxNorm、LOINC、MeSH 等)中表达同一概念的名称归到同一个概念编号(CUI) | 主题词按从宽到窄的树状层级排列,例如 疾病 → 肿瘤 → … → 肺肿瘤 |
| 主要用途 | 串联、整合不同系统的术语,让病历、编码和检索系统可以互相对应 | 给 PubMed/MEDLINE 文献标引主题,并用于编目和检索 |
| 和知识图谱的关系 | 概念(CUI)是节点,概念间的关系构成网络,常被当作医学知识图谱的基础 | 本身是词表而非完整的知识图谱,但它的层级结构常被并入知识图谱 |
2025AB 版 UMLS 元词表收录约 349 万个概念,来自 190 个来源词表、29 种语言。UMLS 2025AB 统计 MeSH 用于“生物医学和健康信息的标引、编目与检索”。MeSH(NLM)
知识图谱在医学上的一个实际应用是罕见病药物再利用。美国阿拉巴马大学伯明翰分校开发的 mediKanren 用知识图谱把疾病机制、文献和数据库连接起来,寻找已获批药物的新用途,已用于帮助 500 多个罕见病家庭。Foksinska et al., 2022
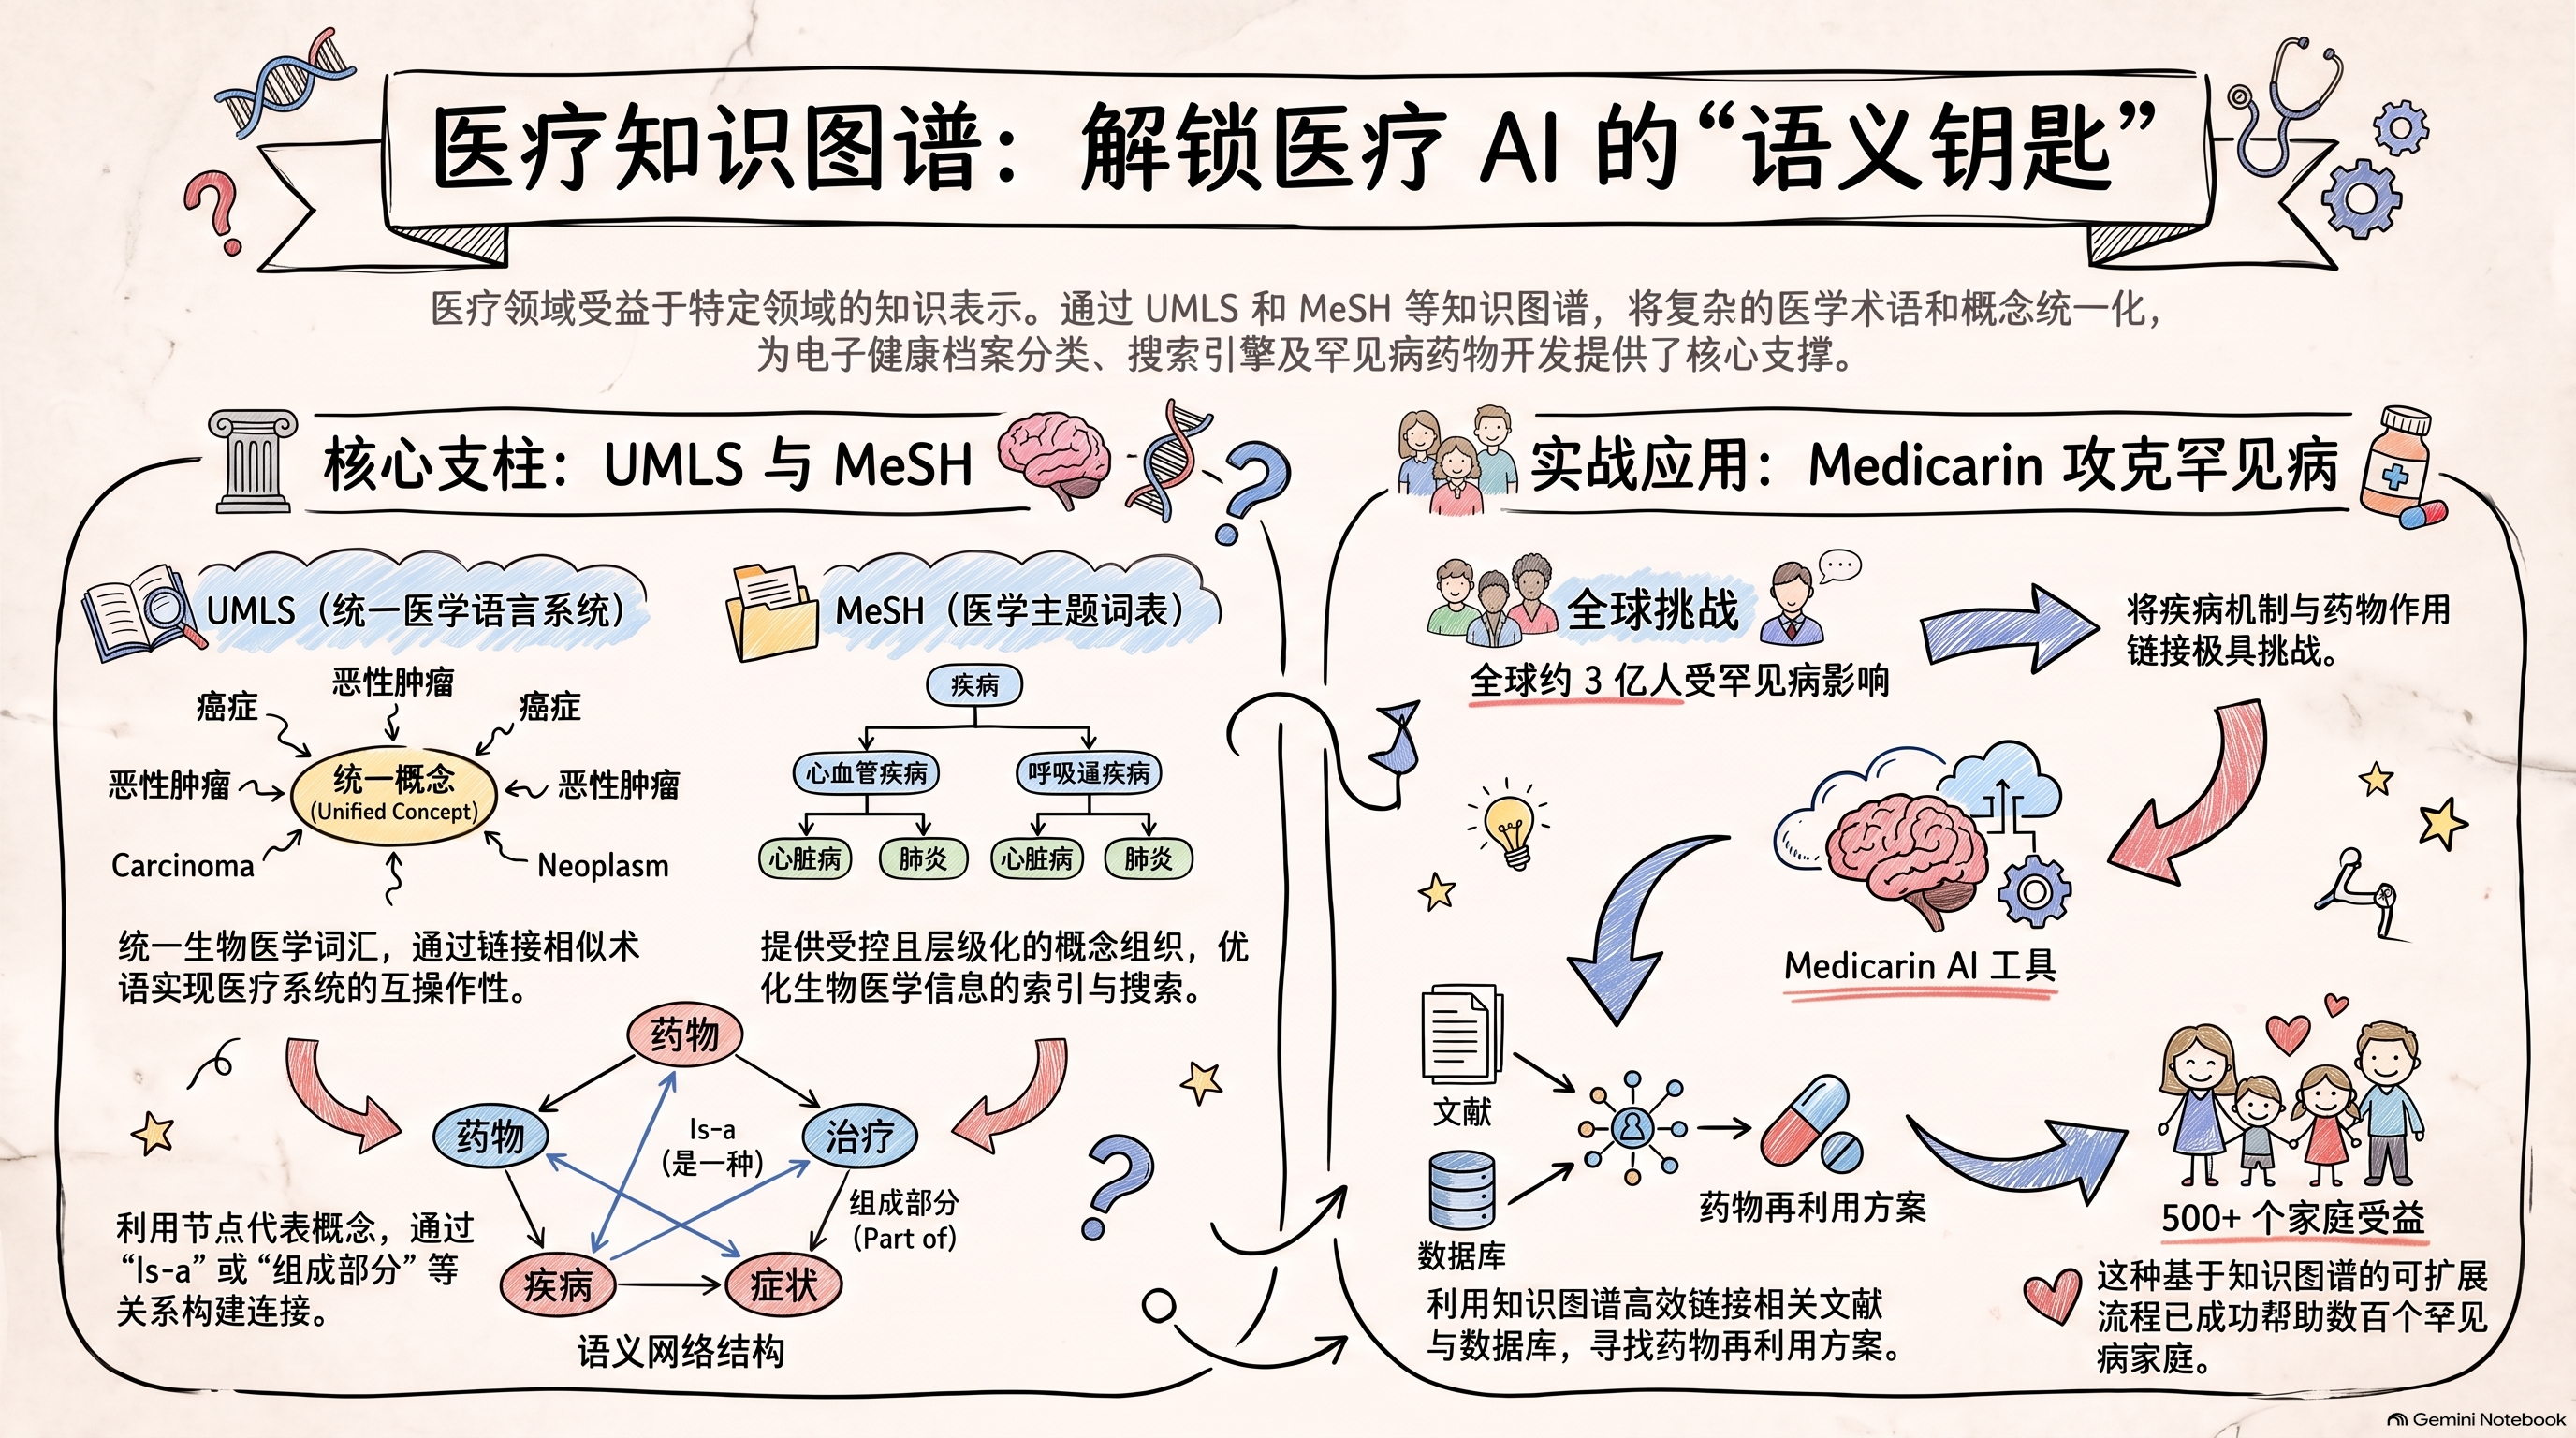
阅读提示:图中的“Medicarin AI 工具”正确名称是 mediKanren。
我的思考
当算法开始理解词义和句意后,就可以建立知识体系了。简单来说,就是在理解了词和词、句子和句子的含义后,理清它们之间的关系,再把关系连接起来,建立知识图谱。这个步骤也可以映射到我平时的学习过程:学了一定的新内容以后,进行知识归纳。
关系的连接可以从词开始。一个词包括它的读音、写法和具体含义。上一期我们给词贴标签,标签可以是词性,也可以是词义的大类。词和词之间的关系也可以从不同方向定义,比如是否是同义词、反义词、上下义词,这样就建立起了 WordNet。我学英语时也常用这个方法:学习替换词。它能帮助词义消歧——一个词有多个意思时,在不同句子里找到它的同义词,就能分清此处的意思。
有了 WordNet 之后,可以进一步定义语义框架,从词走向一个句子所表达的事件结构,比如理解谁对谁做了什么、句子里各自是什么角色。定义框架时依靠人工标注语料,也就是把人对语料的理解规范化;用这些标注数据训练或微调模型,可以提高同类文本上的准确率。
理解语义框架后,就可以通过语义构建具体的事实和概念(facts and concepts),并把知识结构化,形成知识图谱。
下一步我想研究的问题:简单的语言模型(simple language models)是怎样工作的?
学习来源与资源
本篇基于我在英属哥伦比亚大学(UBC)微证书项目 “Natural Language Processing to Improve Patient Care” 第一门课 “Overview of NLP and Large Language Models” 中的学习笔记。技术细节对照了 Jurafsky 与 Martin《Speech and Language Processing》(第 3 版草稿,2026 年 8 月):附录 I:Word Senses and WordNet、第 22 章:Semantic Role Labeling;以及 Chundru et al.(2025)Do LLMs Encode Frame Semantics? Evidence from Frame Identification、Foksinska et al.(2022)The precision medicine process for treating rare disease using the artificial intelligence tool mediKanren。
动手试试
- Open English WordNet:输入 bank,看它分成多少个 synset,每个 synset 的上义词是什么。
- FrameNet:在框架索引里查 Ingestion 或 Hiring,看它的框架元素和标注例句。
- BabelNet:搜索 library,对比返回的概念和实体,体会“覆盖广”与“结果分散”。
- MeSH Browser:查 Lung Neoplasms,看它在树状层级中的位置。UMLS 的在线浏览需要先免费申请 UTS 账号与许可。