
NLP 学习笔记 / NLP005
语言模型的基础:概率
前面四期讲的是设计:计算机怎样拆解词和句子、给它们贴标签,再把词义连成知识。接下来是一个很实际的问题:我们怎样和能处理文本的电脑互动,电脑又是怎样给出回答的?背后的技术其实是生活中常常碰到的东西——概率。简单语言模型统计“接下来通常是什么”:在单词里是下一个字母,在句子里是下一个词,再把这些次数变成概率。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
频率与概率
频率是次数:e 在 103 个字符里出现 11 次。概率再除以总数:11 ÷ 103 ≈ 0.107。所有概率加起来等于 1。
条件概率
已知前面是什么时,下一个结果的可能性。P(red | big) 是 big 后面紧接 red 的概率,不是 red 在任何地方出现的概率。
一元与二元模型
一元模型只用每个词自己的概率,不看词序。二元模型以前一个词为条件:P(red | big) = big red 的次数 ÷ big 的次数。
抽样
生成时,按每个词的概率把 0 到 1 切成区间,取一个随机数,落在哪个区间就选哪个词;从 <s> 开始重复,直到 </s>。
全景图:从字母到句子
从左上角开始:英文字母加空格共 27 个符号,数出每个符号出现的次数就是字母频率,再除以总数就是字母概率。黑色箭头指向单词:只用单词各自的概率,就是一元语言模型;旁边的蓝色批注是,词频也能用来区分 AI 写的文字和人写的文字。中间的条件概率加入了上下文:已知前面是什么,下一个是什么。向下的箭头通向生成句子:查单词概率表,一个词一个词地抽出来。右下角是我的重点。
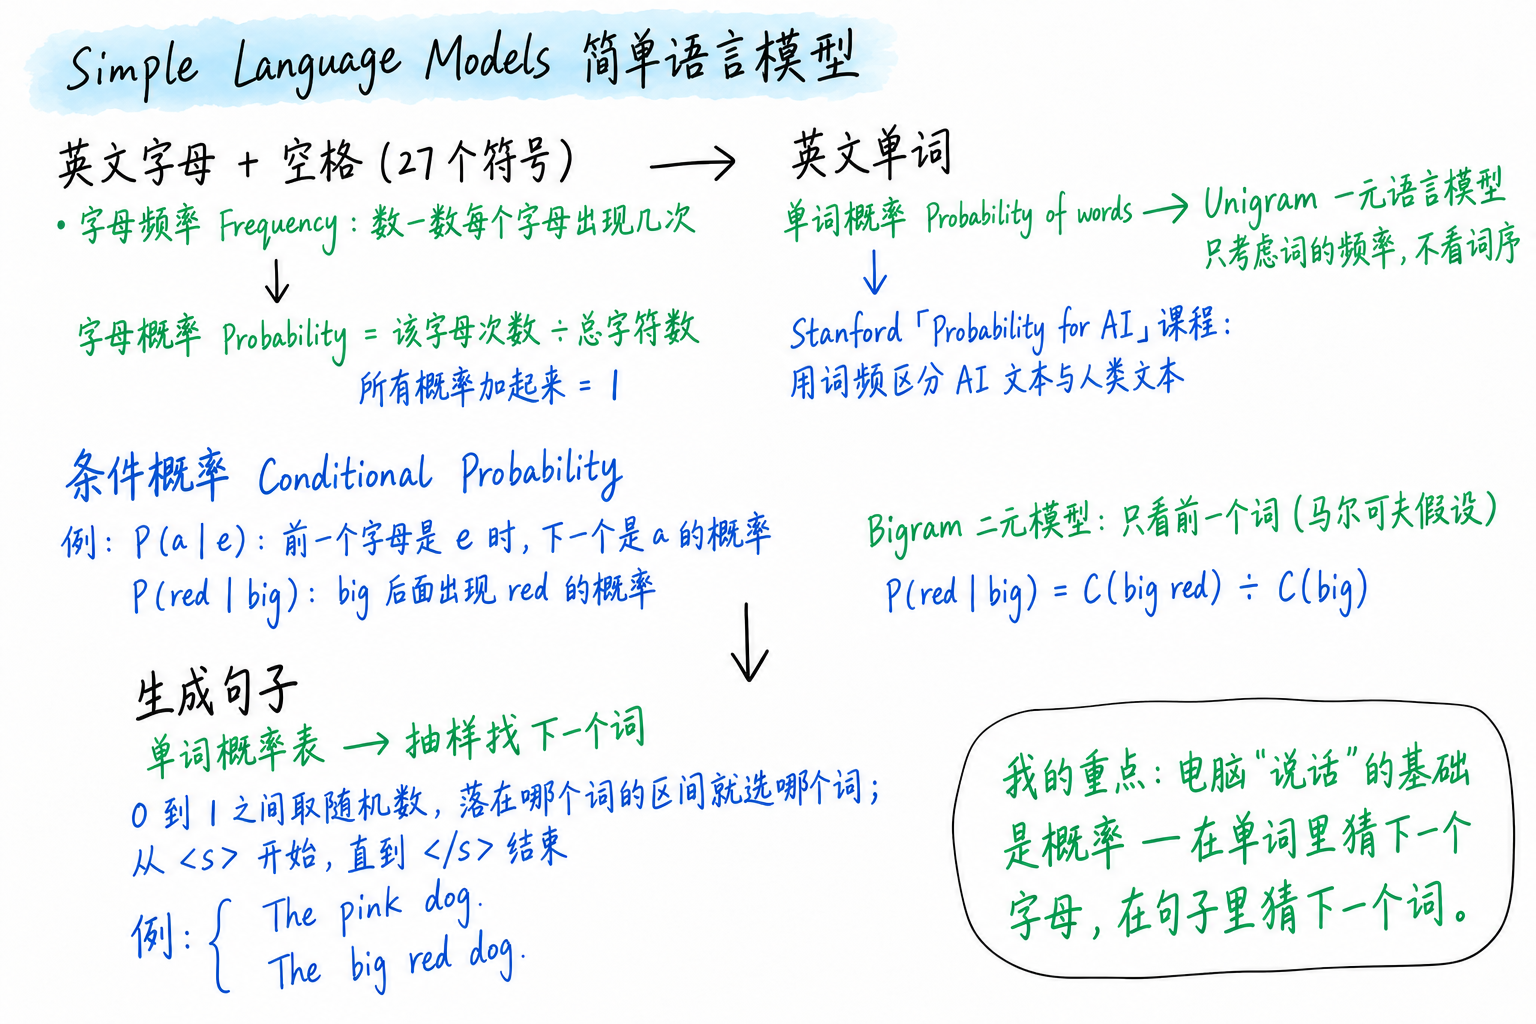
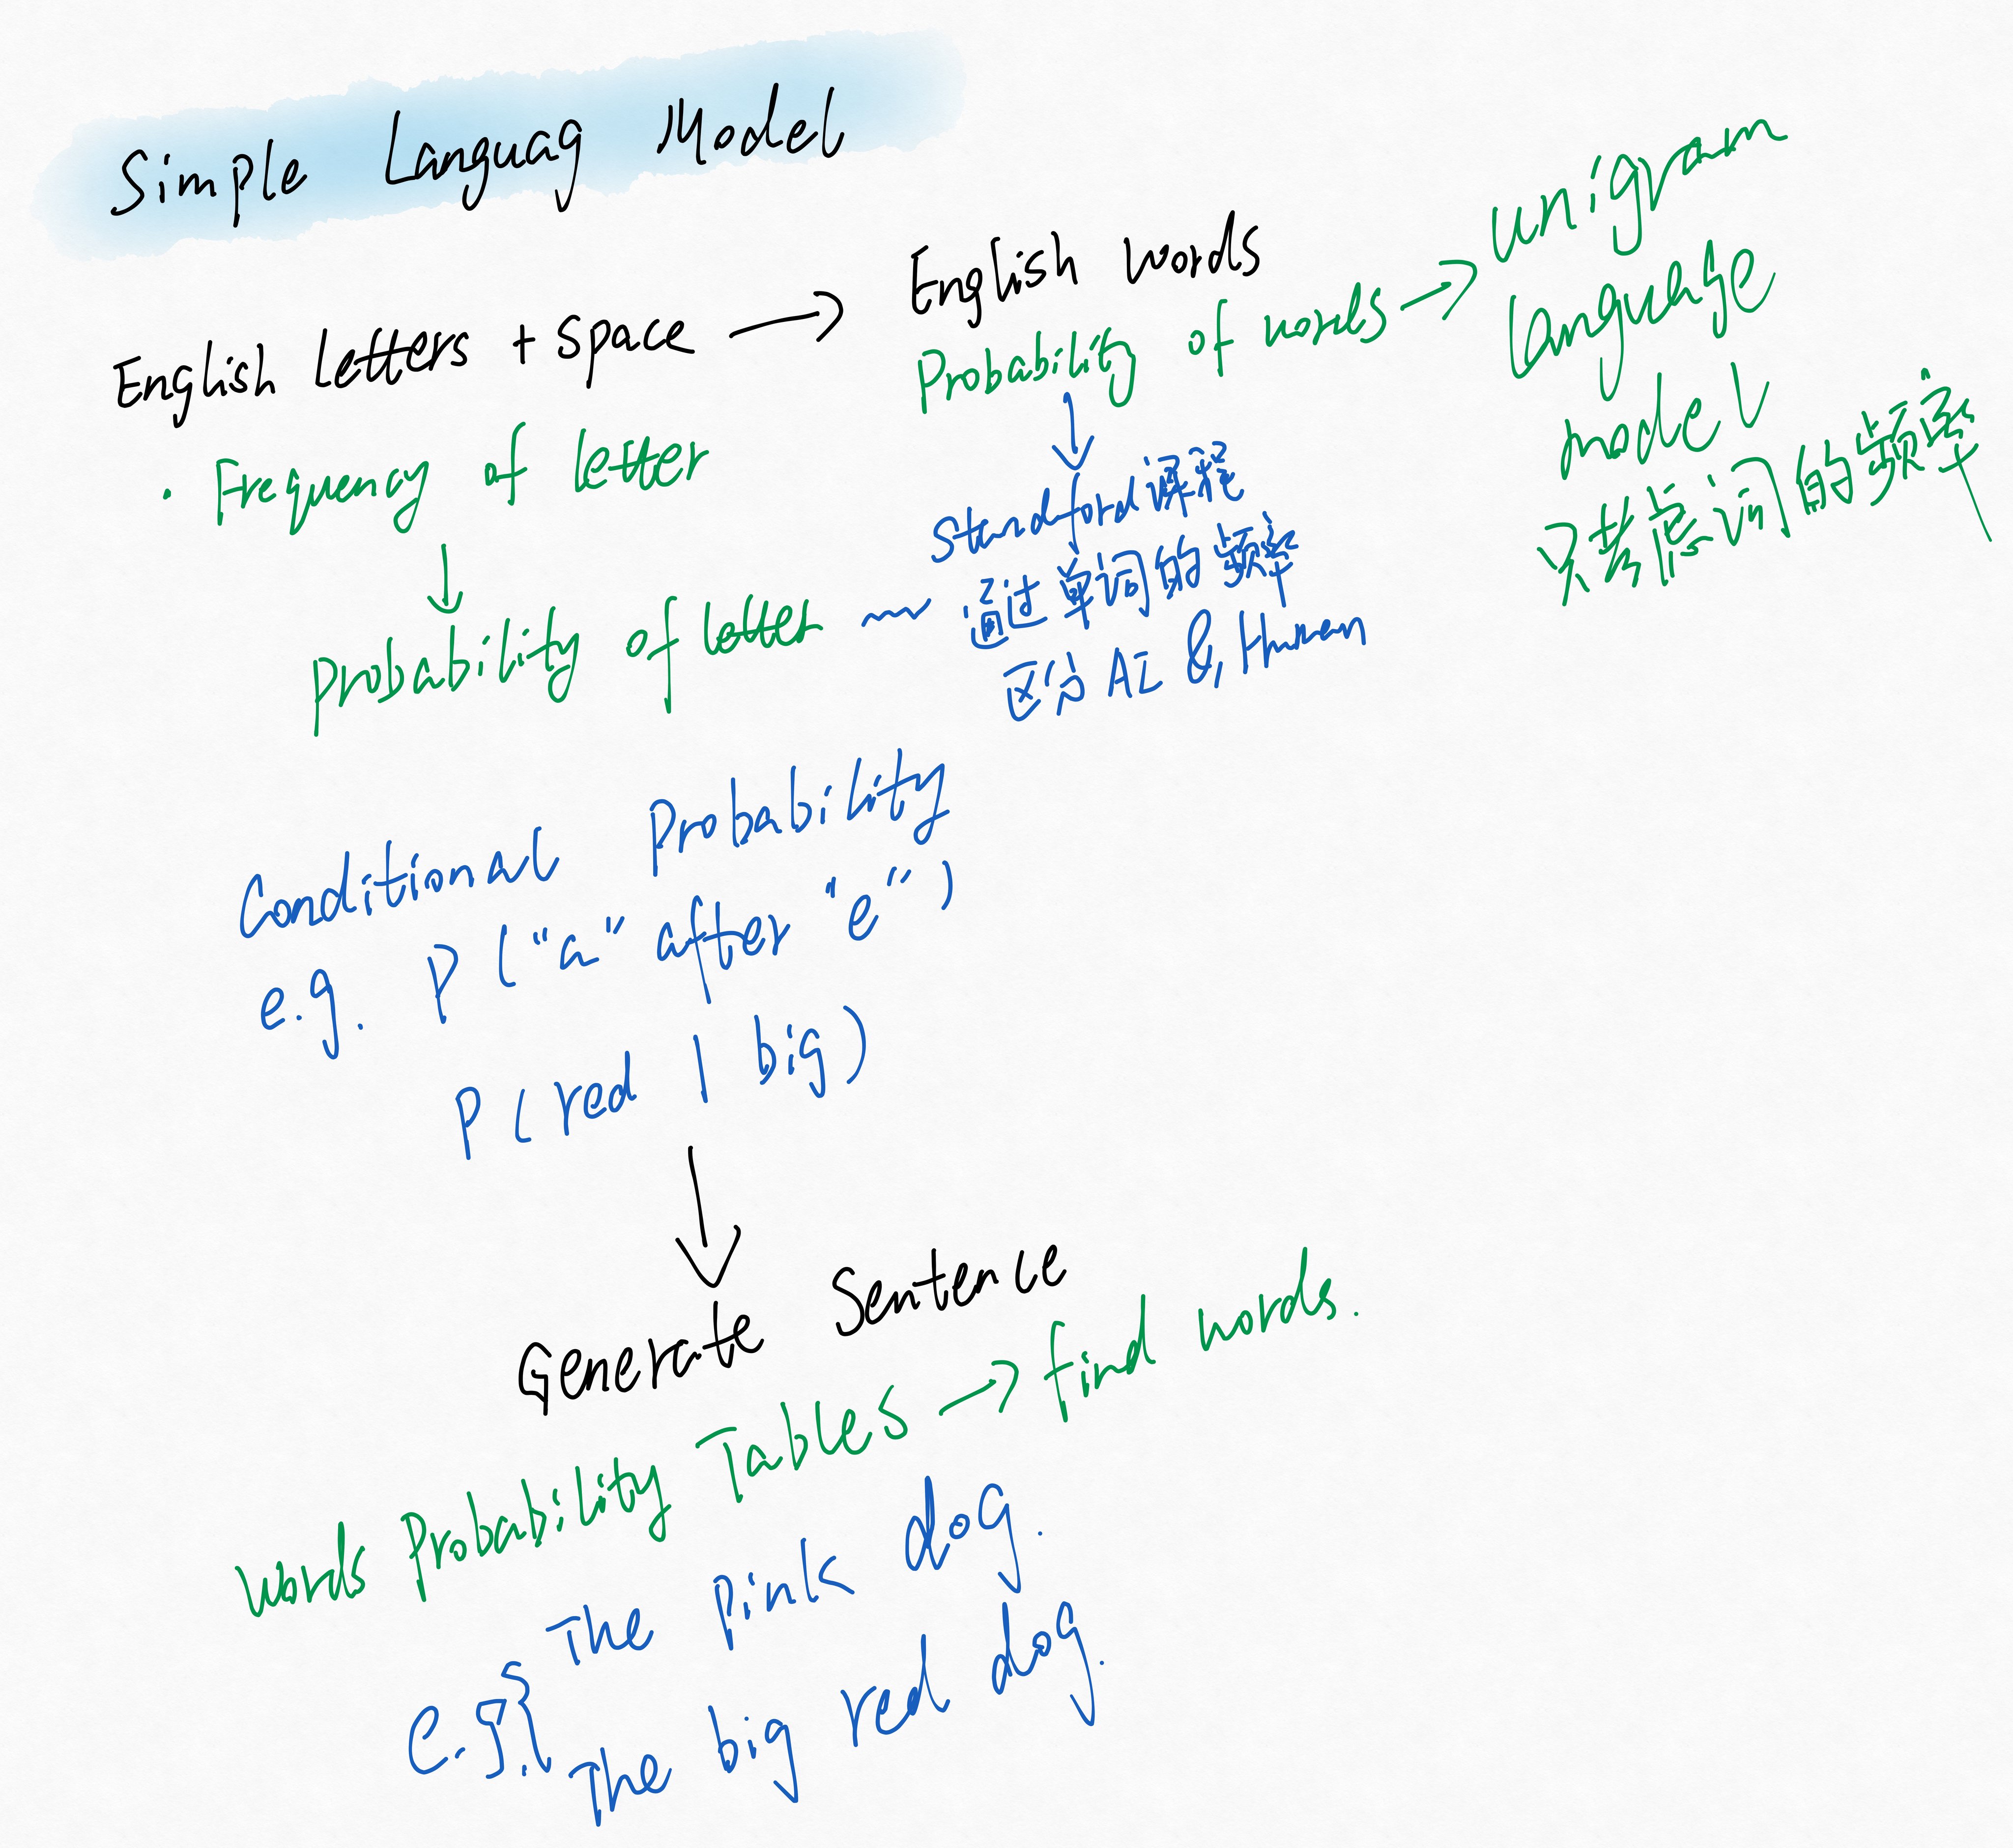
根据我的手写笔记整理,做了几处修正和补充。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
字母:从数次数到概率
最简单的语言模型以字符为单位。取 26 个英文字母加上空格,共 27 个符号,数一数每个符号在一段文字里出现多少次,这就是频率。用它除以总字符数,就得到这个字母的概率:
P(字母) = 该字母出现的次数 ÷ 总字符数
| 符号 | 在 103 个字符的文本中出现次数 | 概率 |
|---|---|---|
| a | 8 | 8 ÷ 103 ≈ 0.078 |
| e | 11 | 11 ÷ 103 ≈ 0.107 |
| 空格 | 14 | 14 ÷ 103 ≈ 0.136 |
无论文本多长,有两点总成立:每个概率都在 0 到 1 之间;27 个概率加起来正好等于 1,因为每个字符都必然是这 27 个符号之一。在一般的英文里,空格出现得最多,其次是 e、a 等元音字母,z、q、x 则很少见。
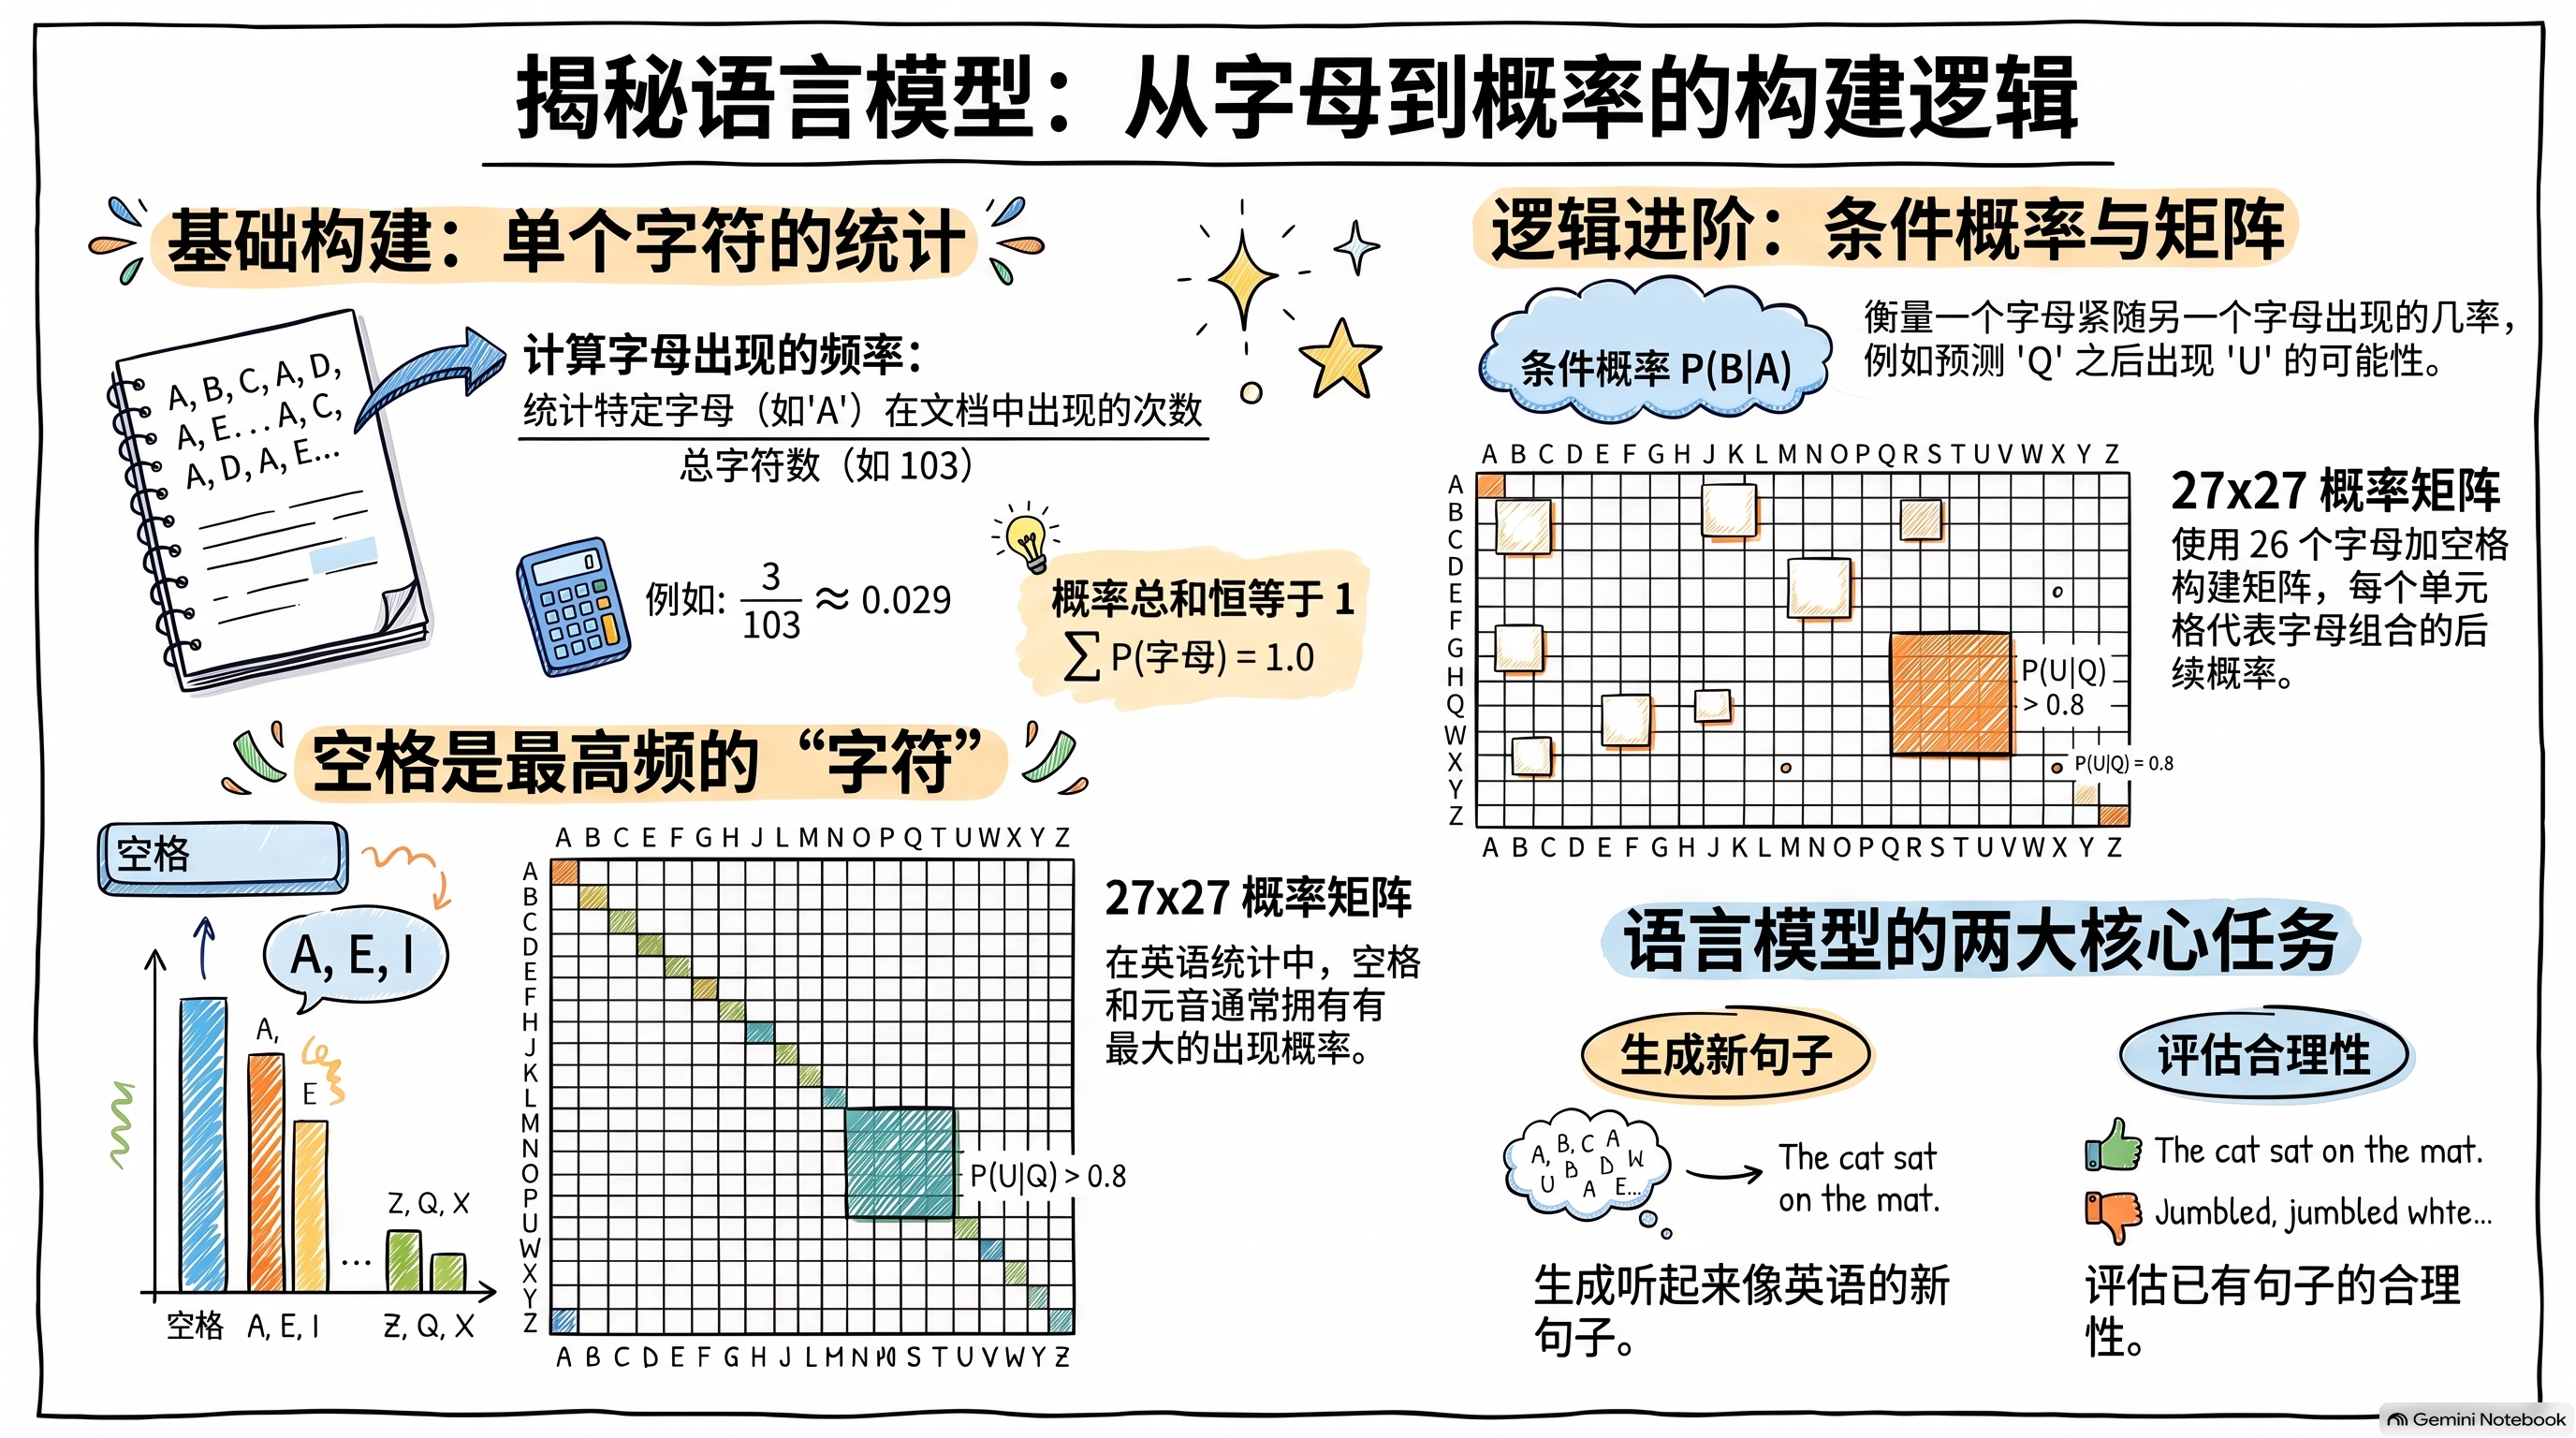
阅读提示:左下角的矩阵把高亮画在对角线上,容易误读成“字母后面接同一个字母”;它想表达的只是“空格和元音最常见”。两个矩阵的字母标签都漏了几个字母,真实的矩阵对 27 个符号各有一行一列。
单词:一元语言模型
同样的数法可以上升一层:把每个词当作单位,在一大批文本(语料库)里数它出现的次数,再除以总词数。这里有两个术语:
| 术语 | 含义 | 例子:“the cat sat on the mat” |
|---|---|---|
| 词例(token) | 词的每一次出现 | 6 个词例 |
| 词型(type) | 不重复的词,也就是词汇表 | 5 个词型:the、cat、sat、on、mat |
只用这些单词概率的模型叫一元语言模型(unigram)。它只看词频、不看词序,所以会认为 “the cat sat” 和 “sat the cat” 一样可能。要解决这个问题,模型需要上下文。
句子还会加上两个特殊符号:开头的 <s> 和结尾的 </s>。有了它们,模型就能学到哪些词常常出现在句首,以及句子什么时候该结束。SLP3,第 3 章
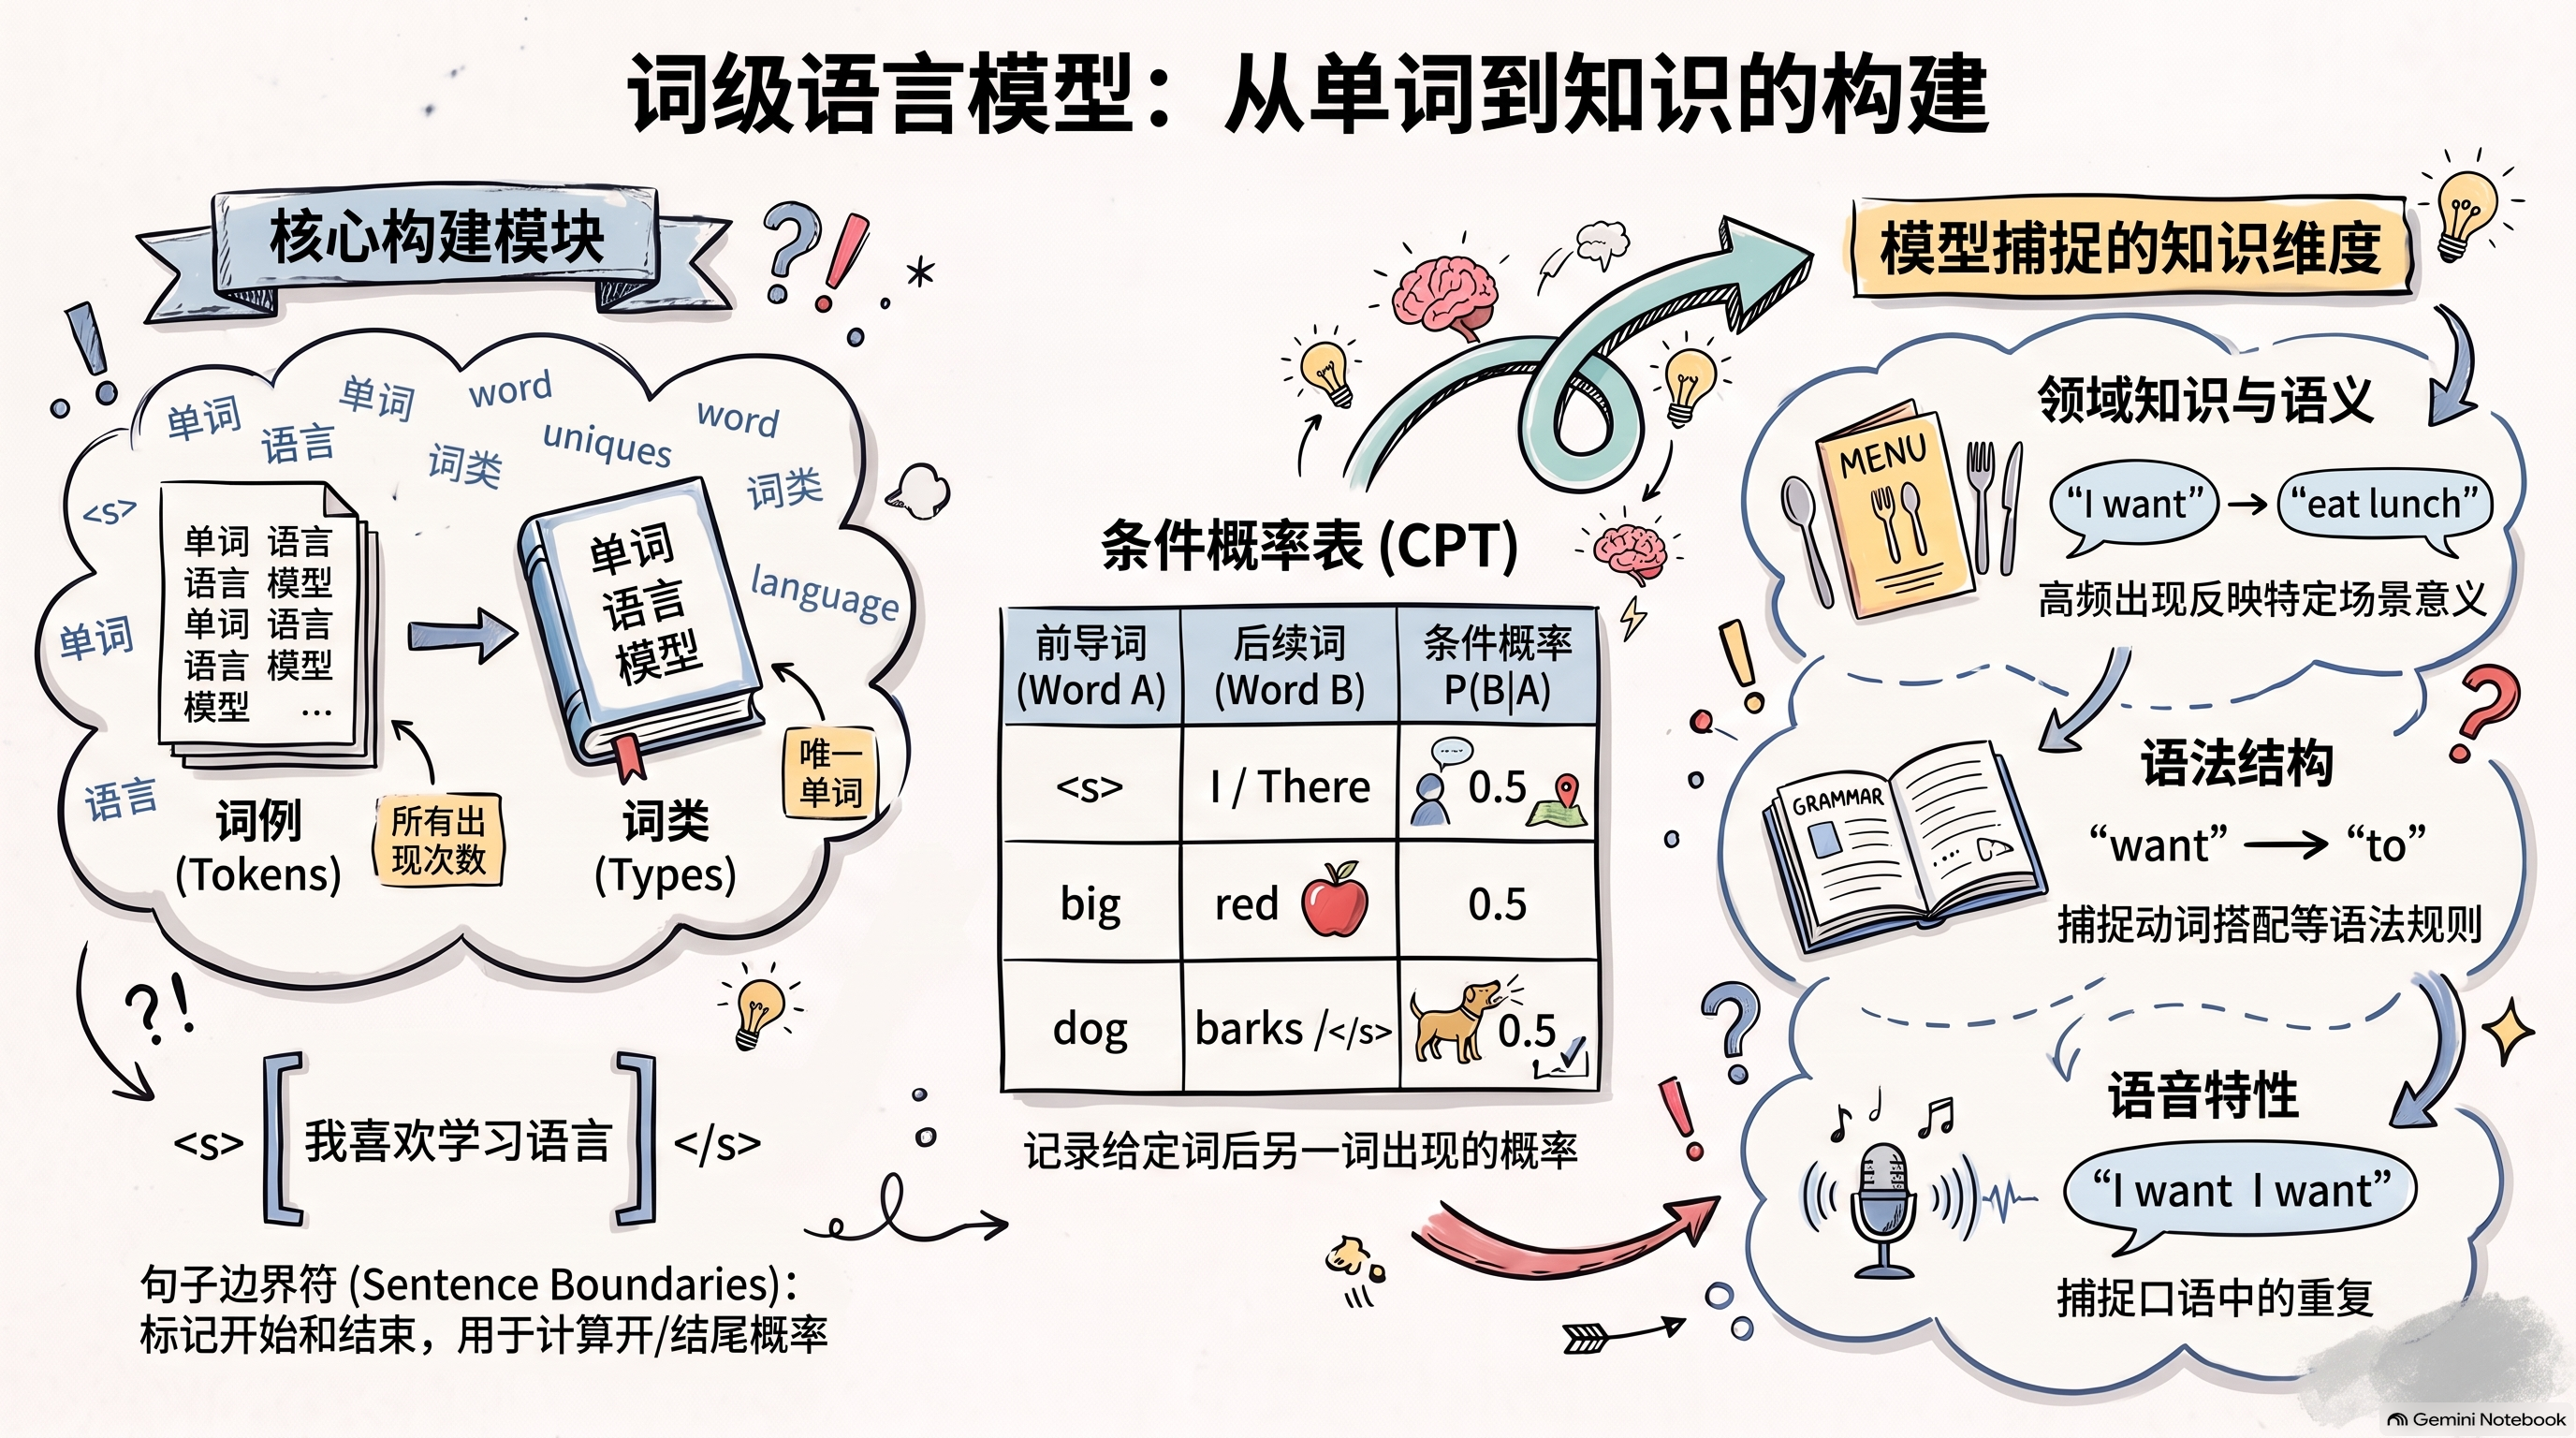
阅读提示:图中的“词类”指词型(type),即不重复的词,和语法上的“词类”(词性)不是一回事。条件概率表里的 0.5 只是示意数值。
条件概率:下一个是什么
条件概率问的是:已知前面出现了什么,接下来某个结果有多大可能。写法是中间加一条竖线,读作“在……条件下”:
- P(a | e):当前字母是 e 时,下一个字母是 a 的概率。
- P(red | big):当前词是 big 时,下一个词是 red 的概率。
对字母来说,27 × 27 种组合构成一张表。有些格子几乎是确定的:英文里 q 后面几乎总是 u。对单词来说,只以前一个词为条件的模型叫二元模型(bigram),它的概率同样来自计数:
P(red | big) = “big red” 出现的次数 ÷ “big” 出现的次数
只看前一个词、不看全部历史,这个简化叫马尔可夫假设。三元模型往前看两个词,n 元模型往前看 n − 1 个词。在 Berkeley Restaurant Project(一个餐厅查询系统收集的问句语料)里,P(want | I) = 0.33:“I” 后面有三分之一的情况接 “want”。SLP3,第 3 章
这些数字记录了真实的规律:“want” 后面常接 “to”,这是英语语法;“I want” 很常见,是因为人们在找餐厅,这是关于任务场景的知识。
给句子打分
语言模型也能给整句话算一个概率。链式法则把每个词在前文条件下的概率相乘;二元模型把每一项的前文缩短为前一个词:
P(<s> i want english food </s>) = P(i | <s>) × P(want | i) × P(english | want) × P(food | english) × P(</s> | food) = 0.25 × 0.33 × 0.0011 × 0.5 × 0.68 ≈ 0.000031
这个数本身非常小,所以实际计算时会把概率取对数再相加,避免数值下溢。重要的是比较:越自然的句子,概率越高。这让语言模型成了一个过滤器。
| 任务 | 概率怎样帮忙 |
|---|---|
| 拼写和语法纠错 | “There are two midterms” 比 “Their are two midterms” 概率更高 |
| 语音识别 | “I will be back soonish” 比 “I will be bassoon dish” 概率更高 |
| 机器翻译、摘要 | 先生成多个候选,再留下概率最高的那个 |
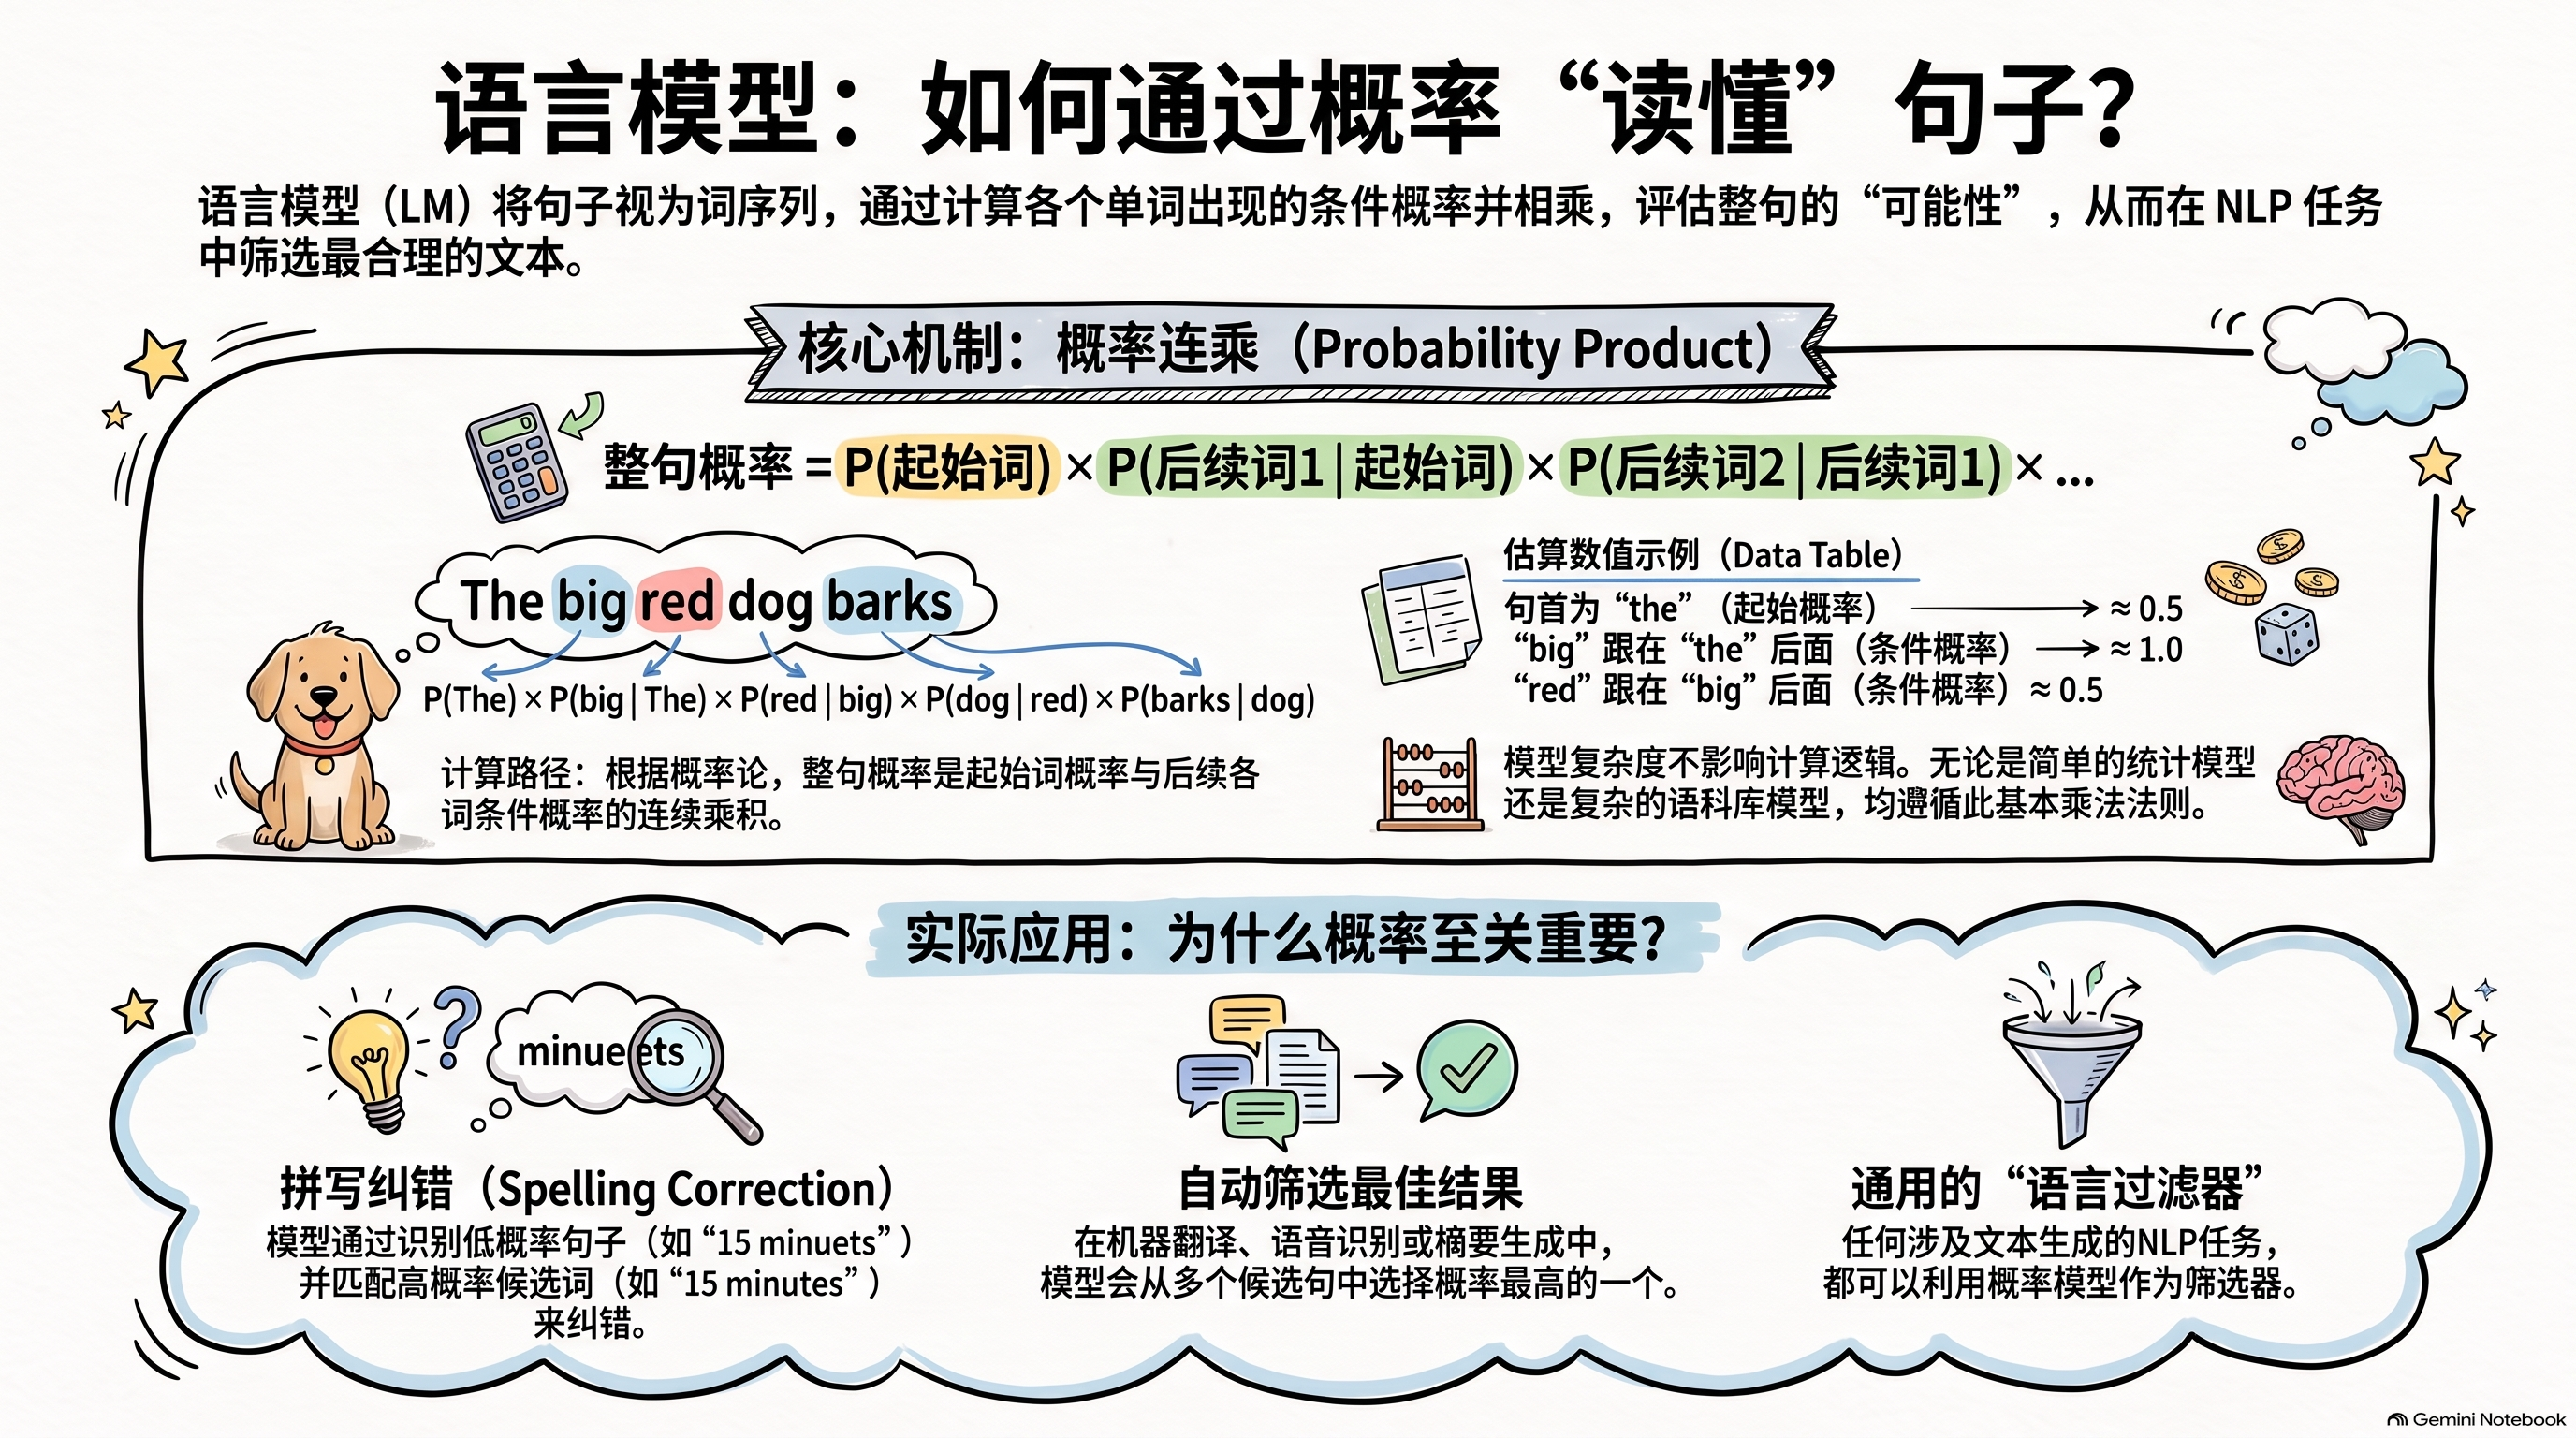
阅读提示:图中的公式只看前一个词,是二元模型的近似;完整的链式法则要以前面所有词为条件,例如 P(后续词2 | 起始词, 后续词1)。图中 P(big | the) ≈ 1.0 等数值来自一个很小的示例语料。
生成句子:抽样
要“写”而不只是“打分”,模型靠抽样。把 0 到 1 的数轴切成一段段区间,每个词占一段,长度等于它的概率。取一个 0 到 1 之间的随机数,落在哪个词的区间,就选哪个词。常见词占的区间大,被选中的机会多;罕见词只占很小一段。
- 从 <s> 开始,在 <s> 那一行的概率里抽出第一个词,比如 “the”。
- 转到 “the” 那一行再抽一次,比如 “big”,接着是 “red”、“dog”。
- 抽到 </s> 时停止。
单词概率表就是这样写出 “The pink dog.” 或 “The big red dog.” 的。这句话可能从没在训练文本里出现过:每一对相邻的词都说得通,整句却是新的。上下文越长,生成的句子越连贯:一元模型抽出来的是一堆词,二元模型有局部的连贯,三元、四元模型的句子开始像原文的风格。SLP3,第 3 章
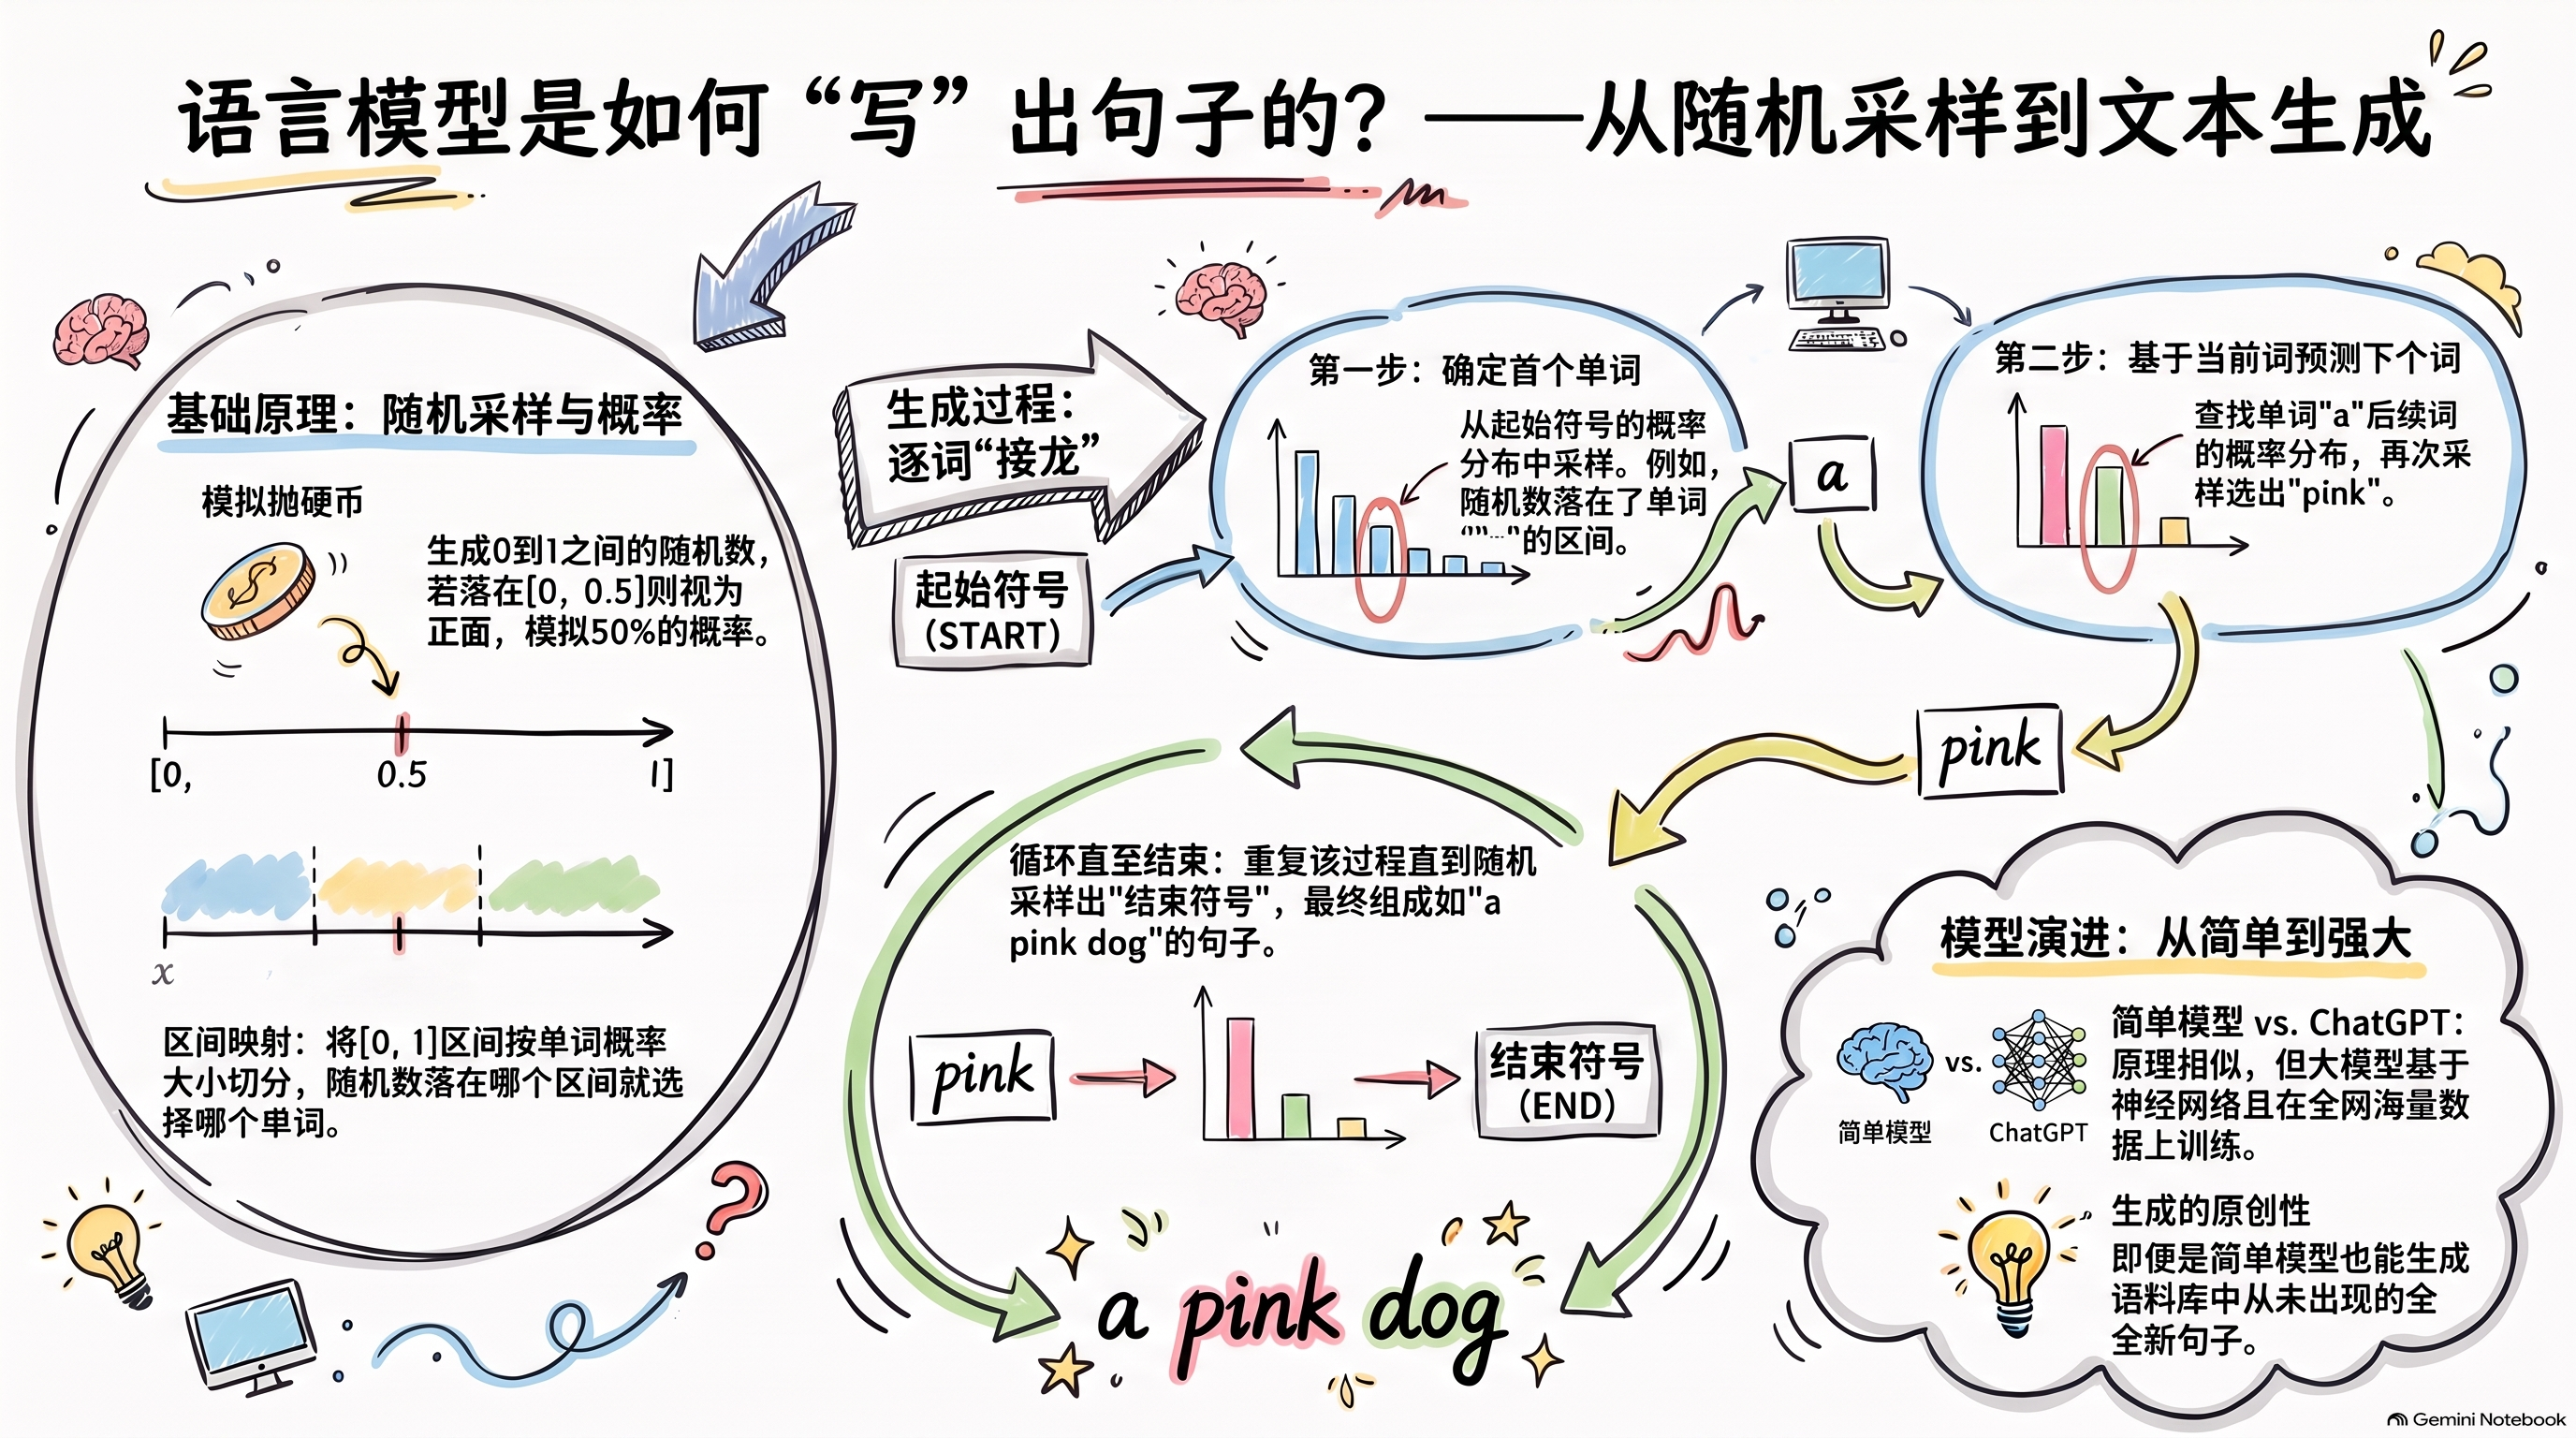
阅读提示:“第一步”里“随机数落在了单词“”…”的区间”中的词没有显示出来,按图中流程应为 “a”。右下角“原理相似”指都在预测下一个词,ChatGPT 用的是神经网络,而不是计数表。
计数的边界
单靠计数有两个先天的限制。训练文本里从没出现过的词对,概率是零,一个没见过的词对就会让整句的概率变成零;加一(拉普拉斯)平滑等方法会给没见过的词对分一点概率。另外,很短的上下文无法把句子里相隔较远的词联系起来。下一期要讲的神经语言模型,通过学习表示而不是存储次数,来处理这两个问题。
词频与 AI 写的文字
单词概率也像一种“指纹”,能透露一段文字是谁写的。语言模型偏爱某些词的程度和人不同,所以当一批文本里有很多出自 AI 时,词频分布就会发生变化。Stanford 的 Liang 等人(2024)利用这一点,在整个语料库层面(而不是逐篇判断)估计有多少文字被大语言模型大幅修改过。在 ChatGPT 发布后举办的四个 AI 会议的同行评审意见中,这一比例估计在 6.5% 到 16.9% 之间。Liang 等,ICML 2024
Stanford 的免费线上课程 Probability for AI(概率与 AI)由 Chris Piech 和 Mehran Sahami 讲授,面向只具备基础代数的学习者讲解现代 AI 背后的概率,由志愿者带小组讨论。我接下来会去上这门课,并整理学到的内容。Probability for AI
我的思考
之前几期学习的是,在概念上怎样设计,让电脑理解人类的语言:解构词和句子,进行分类和归纳,再定义并关联它们之间的关系,电脑就能理解和处理文本。
但我们怎样和理解文本的电脑互动呢?电脑又是怎样回答我们的?这里用到的技术,其实我们在生活中总能接触到,就是概率。简单来说,电脑在构建知识的时候,会学习每个单词之后出现各个单词的概率。比如在 “the big red dog” 里,它学到了 big 后面接 red 有多大可能,red 后面接 dog 有多大可能,再根据学到的概率选出下一个词。
所以我想把概率好好学一遍。Stanford 免费的 Probability for AI 课程是我的下一步,之后我也会总结自己学到的内容。
下一步我想研究的问题:神经语言模型是怎样工作的?
学习来源与资源
本期内容来自我在英属哥伦比亚大学(UBC)微证书项目“Natural Language Processing to Improve Patient Care”中“Overview of NLP and Large Language Models”课程的学习笔记。技术细节核对了 Jurafsky 和 Martin 的 Speech and Language Processing(第 3 版草稿,2026 年 8 月):第 3 章 N-gram Language Models;以及 Liang 等(2024)Monitoring AI-Modified Content at Scale: A Case Study on the Impact of ChatGPT on AI Conference Peer Reviews。
自己动手试试
- Google Books Ngram Viewer:比较 “big red” 和 “large red” 在历年书籍中出现的频率。这正是二元模型的计数起点。
- Stanford Probability for AI:上文提到的免费线上课程,讲现代 AI 背后的概率。