
NLP 学习笔记 / NLP008
大语言模型的问题与改进:幻觉、偏差、对齐与可解释性
上一篇笔记最后留下了两个挑战:数据污染和幻觉。这一篇来自课程的最后一讲,看大语言模型(LLM)还有哪些问题,以及研究者怎样应对。一共四类问题:幻觉与过时信息、不周到或有害的回答、偏差,以及黑箱问题。每一类都配有一种检测、减轻或解释它的方法,但没有哪一种能让问题彻底消失。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
幻觉
听起来合理,实际上不真实、没有意义或不忠实于原文的输出。即使最终答案正确,它也可能藏在推理步骤里。
原子事实
一条可以单独判断真假的短陈述。FActScore 把文本拆成原子事实,逐条到维基百科等可信来源核对;DoveScore 还会检查它们的先后顺序。
检索增强生成 RAG
先检索与问题相关的文档,和问题组合成新的提示,再生成回答。答案可以是最新的、能注明来源,模型本身不变。
人类反馈强化学习 RLHF
用人类反馈微调模型,分三步:人写出理想答案;人给模型的回答排序,训练奖励模型;再更新模型,争取更高的奖励分数。
机制可解释性
打开权重、神经元和激活路径,找出某项任务背后的“电路”,比如回忆秘鲁首都、做两数相加。
全景图:四类问题与对策
从左上角的幻觉开始:先是幻觉的三种表现,再是蓝色的可能解决方法,其中 FActScore 和 DoveScore 用来检测幻觉,RAG 用来预防。下面是大语言模型的偏差:从哪里来,以及四种缓解办法。右上角,不周到或有害的回答引出 RLHF 和它的三个步骤。右下角是可解释性:为什么需要它,以及研究者看进模型内部的两种主要方法。右下角的框里是我的重点。
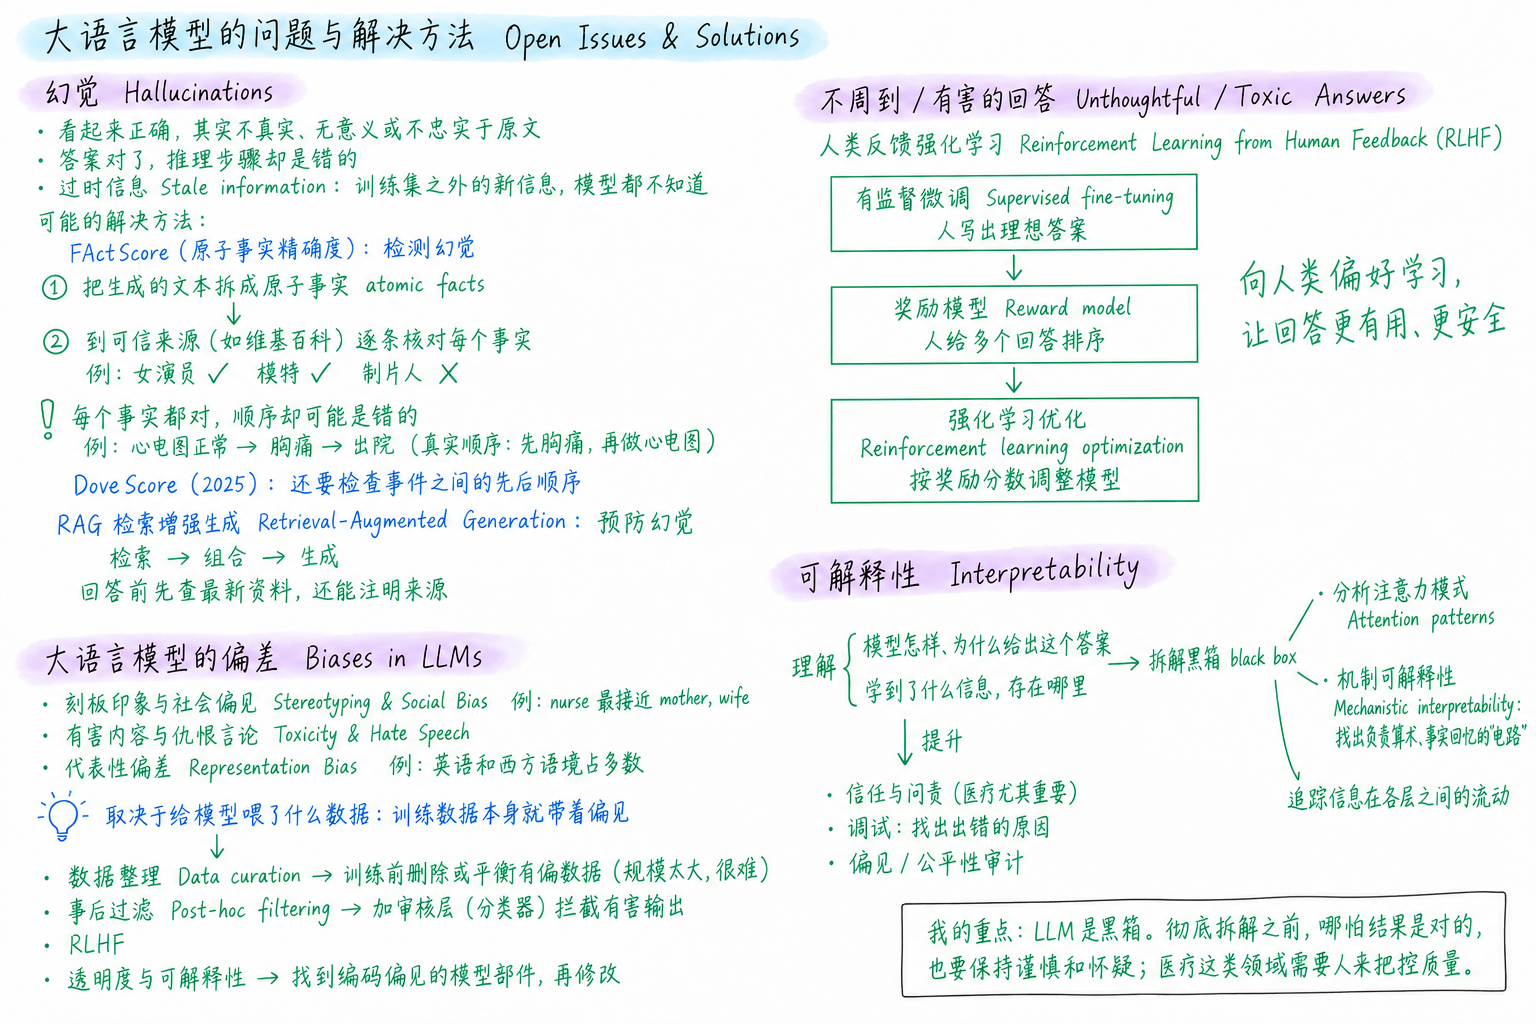
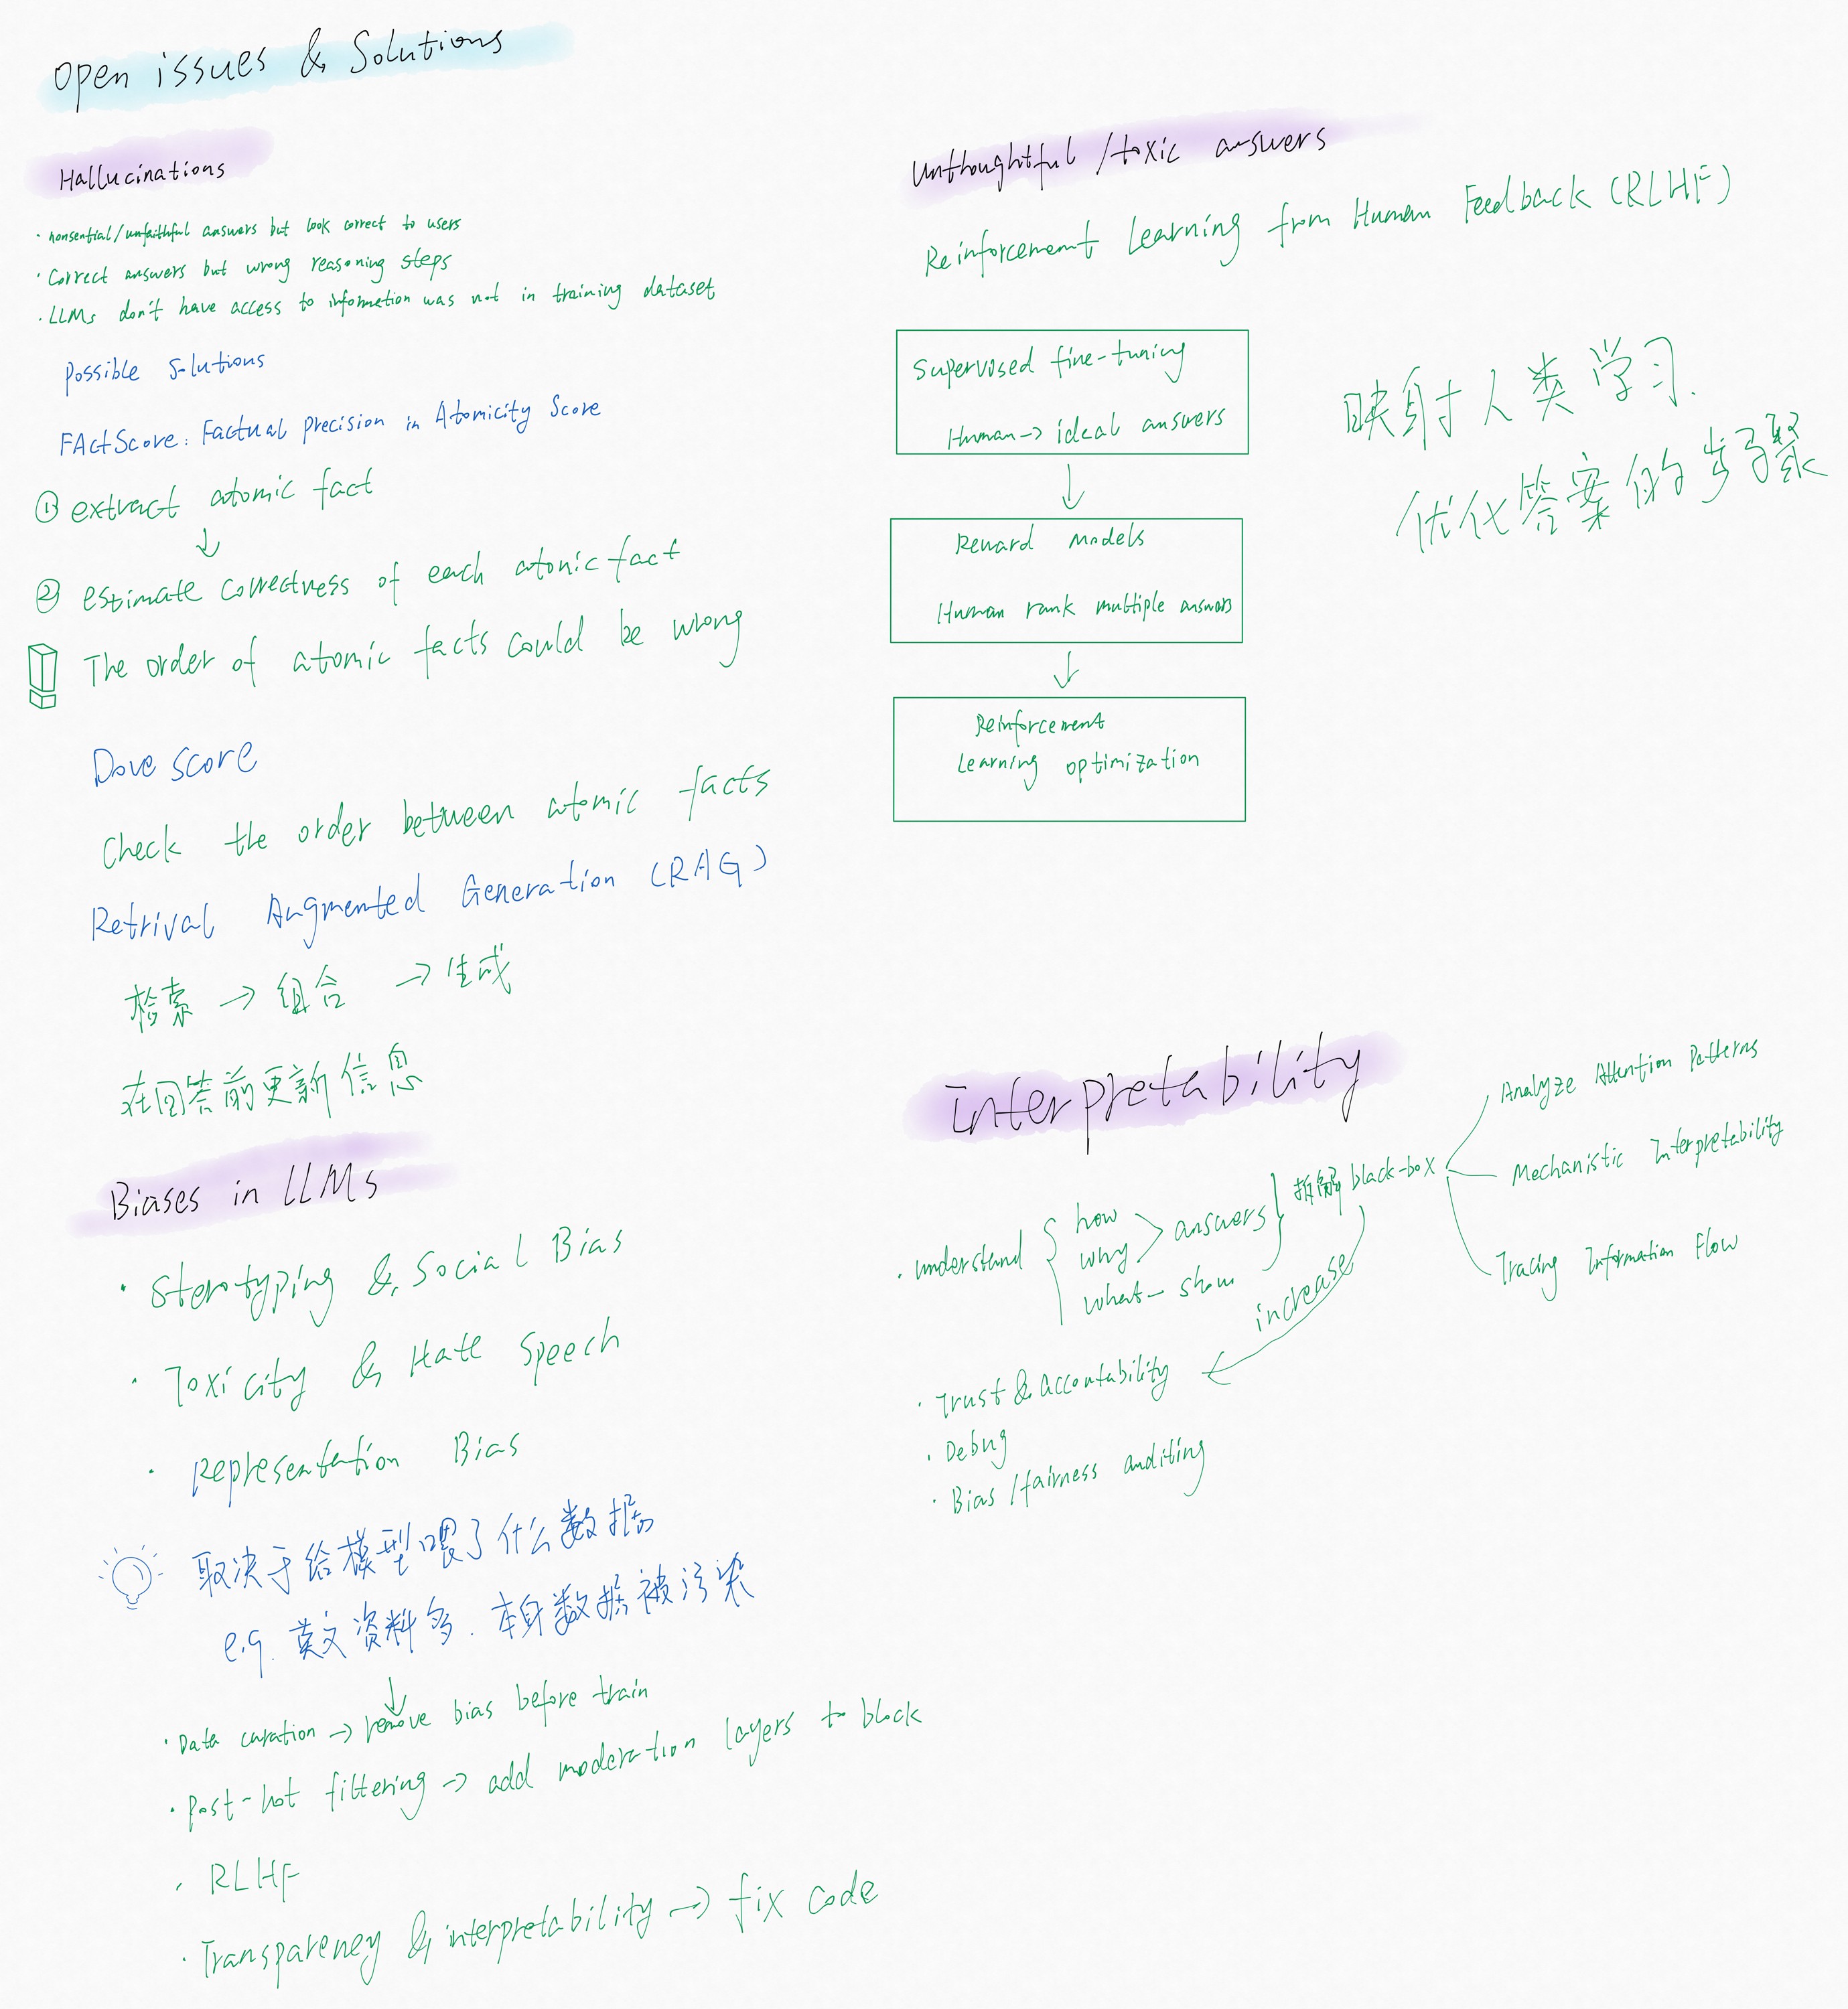
根据我的手写笔记整理,做了几处修正和补充。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
幻觉:流畅、自信,却是错的
LLM 生成的回答听起来合理,实际上却不真实、没有意义或者不忠实于原文,这就叫幻觉(hallucination)。最强的模型也不例外:GPT-4 技术报告自己就写明,模型“并不完全可靠”,在高风险场景使用时要格外小心。
课程给出了三种表现:
| 表现 | 课上的例子 |
|---|---|
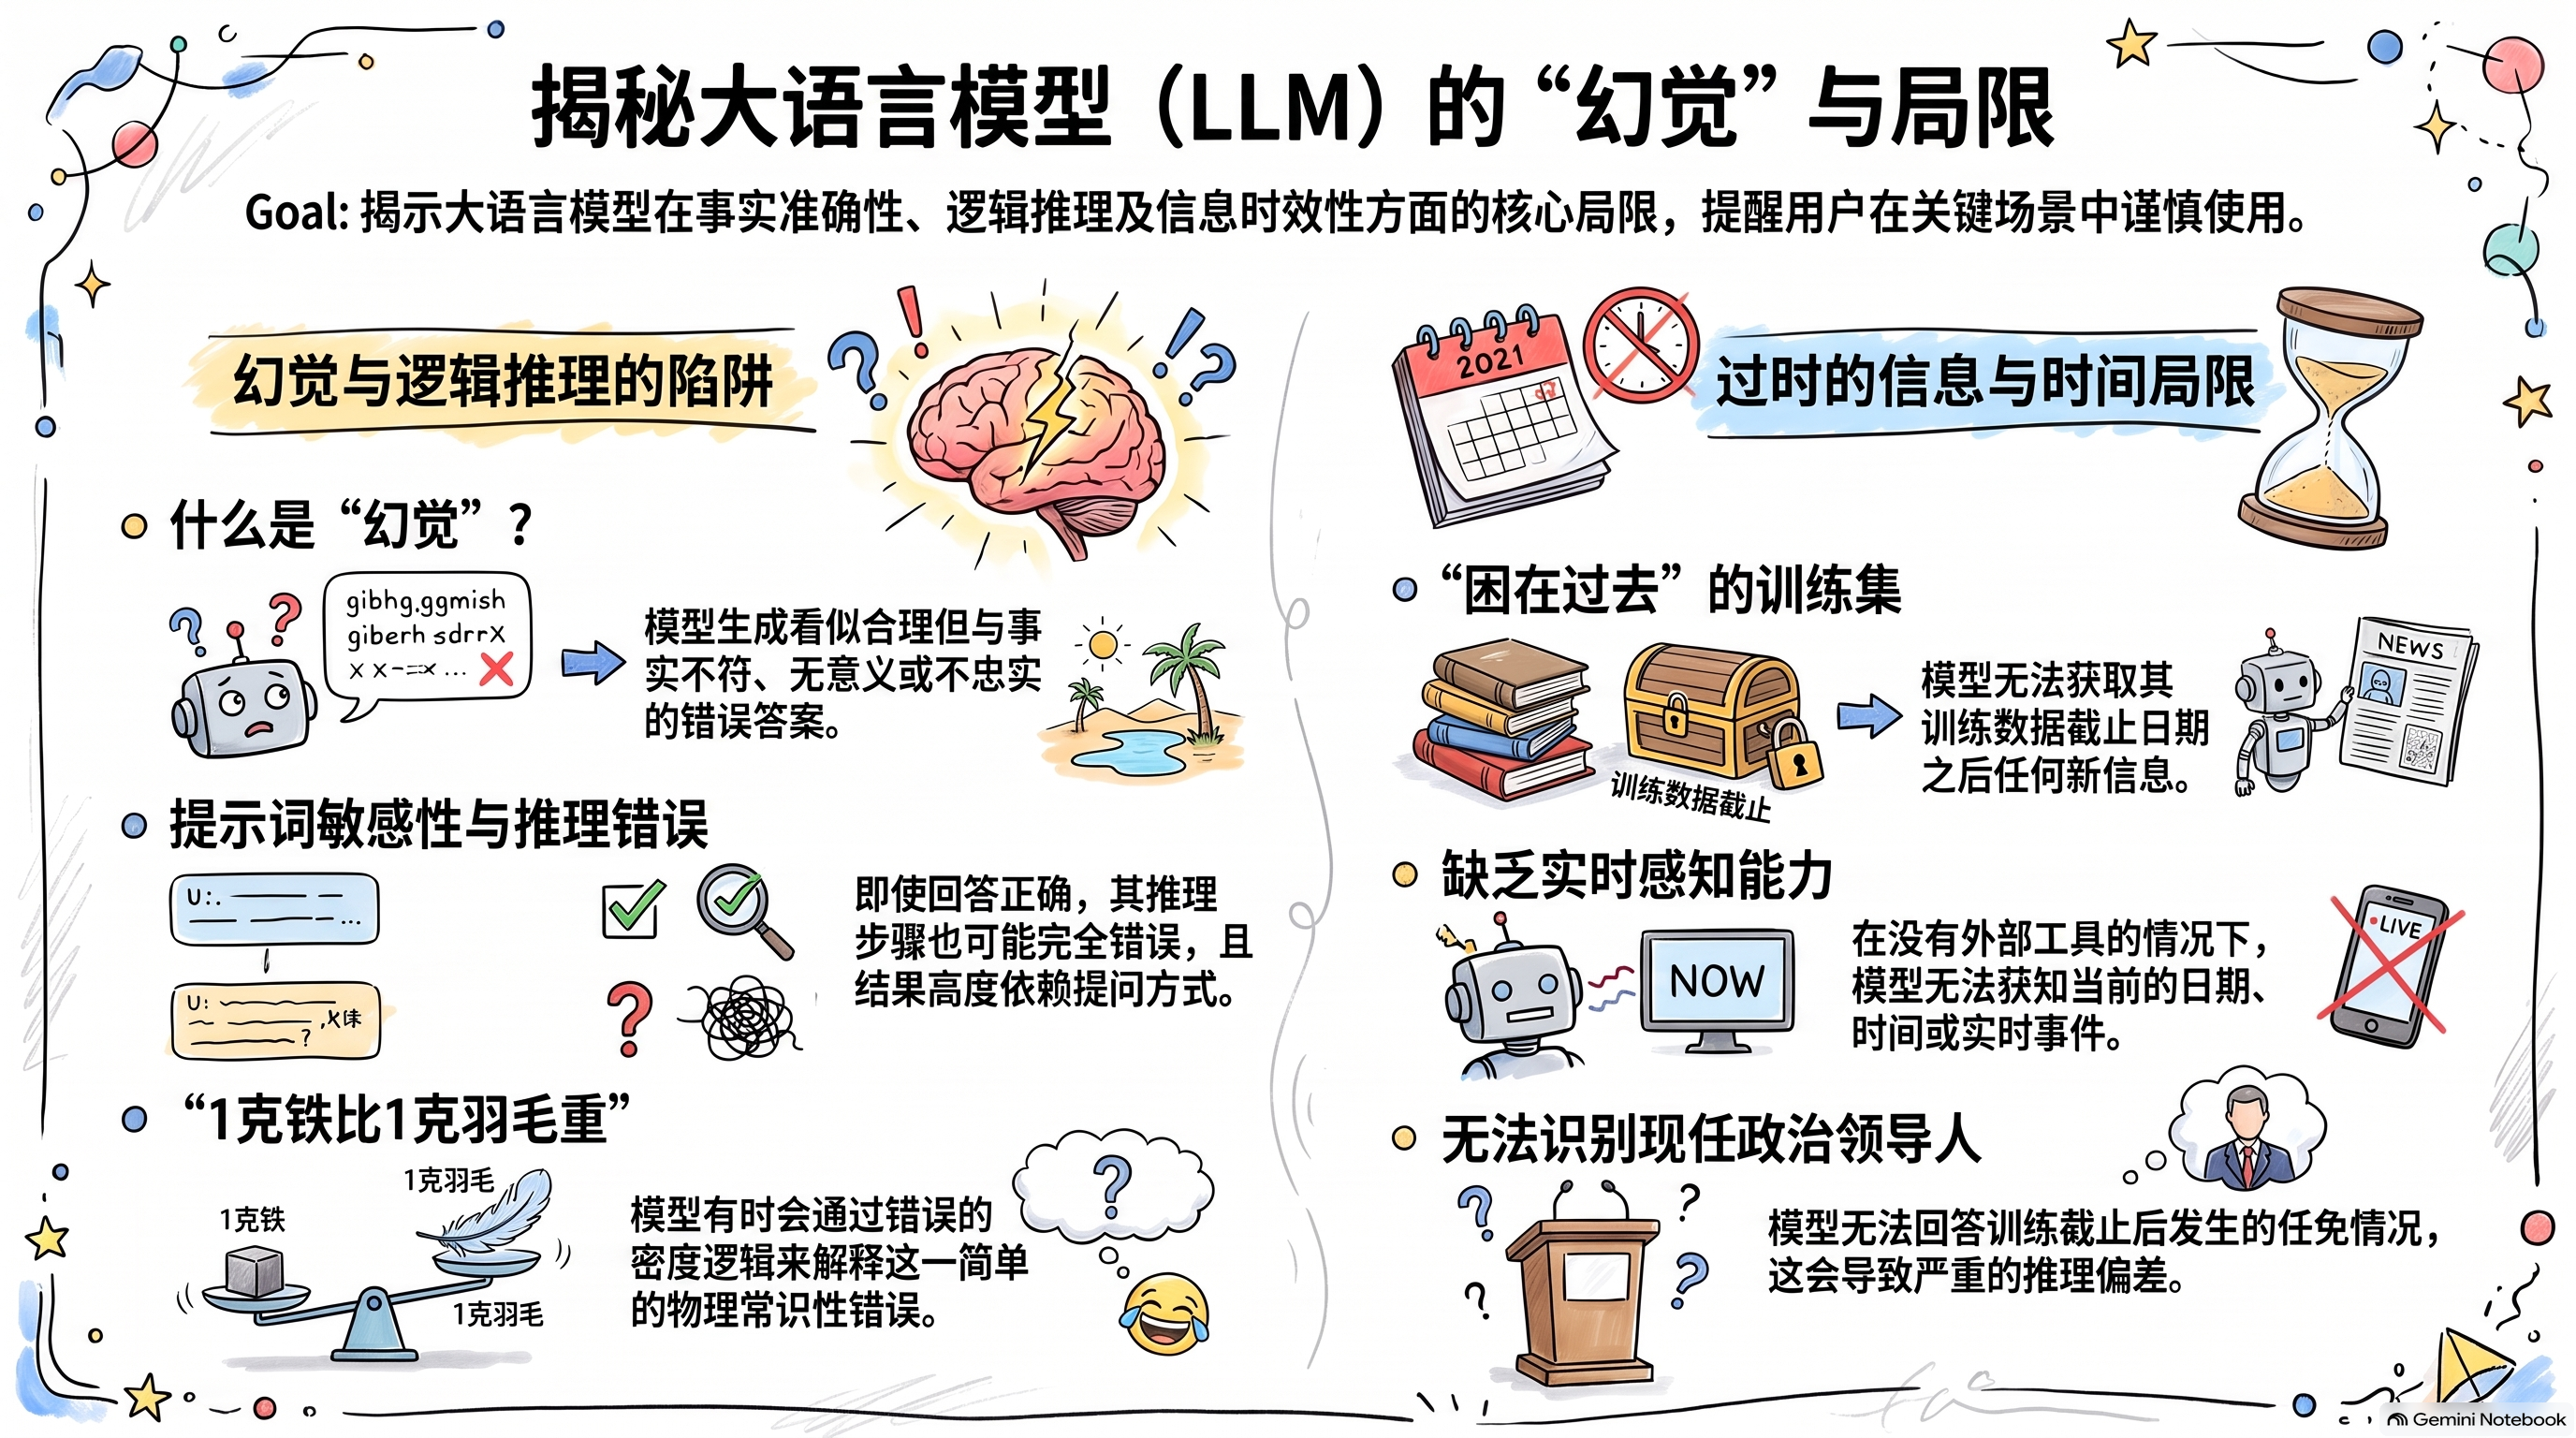
| 听起来合理,其实是错的 | 问“1 克铁比 1 克羽毛重吗?”,模型回答“是”,还解释说铁的密度更大。 |
| 前后不一致 | 换个问法,“1 克铁和 1 克羽毛哪个重?”,同一个模型又答对了。 |
| 答案对了,推理错了 | 在一道美国医师执照考试(USMLE)题上,模型选对了答案,解释里的推理步骤却有错;换几种“一步一步想”的提示,它又给出了错误答案,错因五花八门。 |
第三种对医疗工作最要紧:最终答案正确,并不说明背后的推理是对的,所以只核对答案还不够。
为什么会这样?LLM 的训练目标是根据文本里的模式预测下一个 token。它可以学会下一个位置应该是一个数字,甚至是一个听起来合理范围内的数字,但训练过程并不保证这个数字是真的。说对说错,听起来都一样顺,缺乏相关知识的读者很容易被骗过去。
过时信息:停在训练截止那一天
另一个独立的局限:训练数据里没有的东西,LLM 一概不知。2024 年 12 月训练完成的模型,不可能知道 2025 年谁当上了加拿大总理;没有外部信息来源,它甚至不知道今天是几号。如果它硬要回答,这个空白就可能变成幻觉。
检测幻觉:FActScore 与 DoveScore
怎么判断一段长回答里有没有幻觉?细心的人会一句句读,一个事实一个事实地核对。FActScore(Factual precision in Atomicity Score,原子事实精确度;Min 等,2023)把这个过程自动化,分两步:
- 把文本拆成原子事实。 用另一个 LLM 把生成的每句话拆成一条条可以单独判断真假的短事实。“Bridget Moynahan 是美国女演员、模特和制片人”拆成四条:她是美国人、女演员、模特、制片人。
- 到可信来源逐条核对。 针对每条事实,从维基百科等来源检索相关段落,再让 LLM 判断这些段落是否支持它。课上的例子里,“制片人”找不到依据;“她在美国戏剧艺术学院学习”也不成立(她是在别的地方学的表演)。
得分就是被来源支持的原子事实所占的比例。注意,这里是用一个 LLM 去检查另一个 LLM 的输出。
FActScore 有个盲点:一段回答可以全部由真实的事实拼成,讲的却是假的经过。
| 原子事实 | 顺序 | |
|---|---|---|
| 实际经过 | 患者主诉胸痛。心电图(ECG)正常。患者出院。 | 胸痛 → 心电图 → 出院 |
| 生成的文本 | 心电图正常。患者主诉胸痛。患者出院。 | 心电图 → 胸痛 → 出院 |
每条事实都核对无误,FActScore 就会放行,可它讲的已经不是实际发生的事了。DoveScore(Zheng、Lapata、Pan,2025)在事实描述事件时还会检查事实之间的先后顺序,所以这段文本通不过。作者报告:用真实陈述拼出来的误导性文本,能让以往的细粒度评估方法 AUC 跌到 65% 以下。
FActScore 和 DoveScore 是在衡量幻觉,并不能预防幻觉。课上也说,检测幻觉还是一个没有解决的问题。
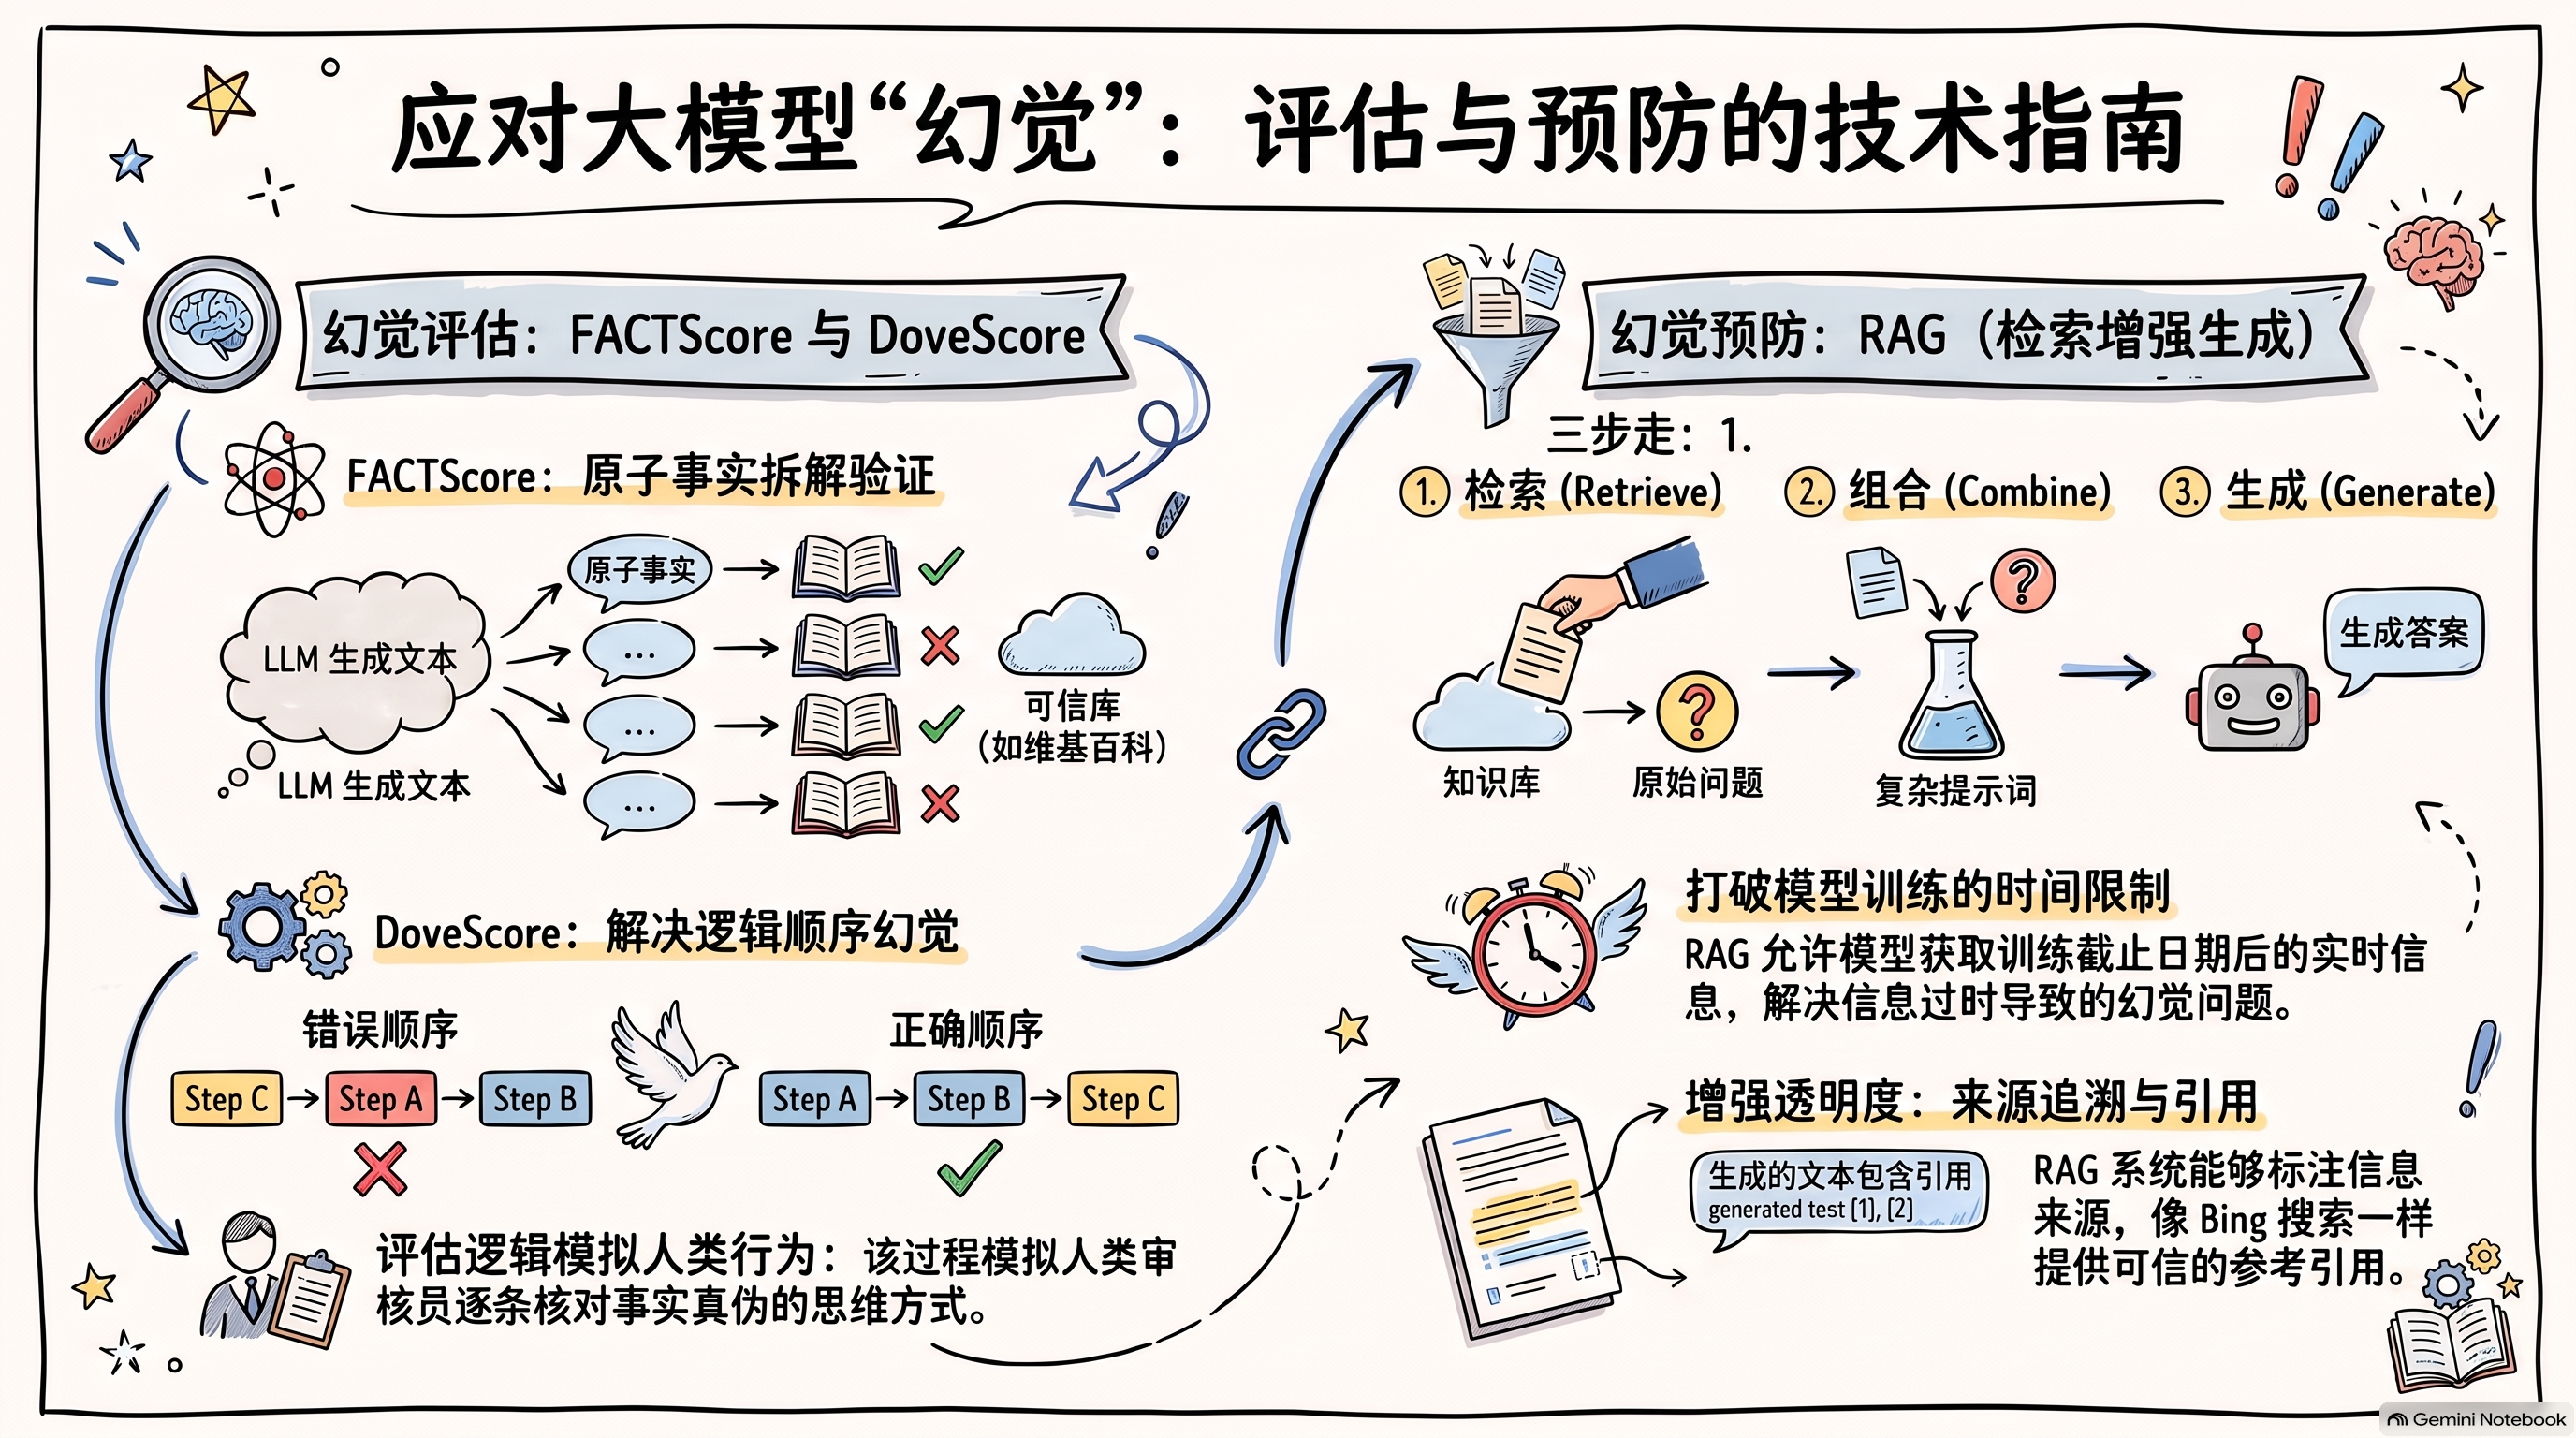
阅读提示:DoveScore 是检测顺序错误的评估方法,并不能“解决”逻辑顺序幻觉;左下角“模拟人类审核员逐条核对事实”说的其实是 FActScore 的思路。RAG 下面多出来的“1.”是图里的笔误。
预防幻觉:检索增强生成(RAG)
检索增强生成(Retrieval-Augmented Generation,RAG;Lewis 等,2020)在提问和回答之间加了一步:
| 步骤 | 直接用 LLM | 加上 RAG |
|---|---|---|
| 1 | 用户提问 | 用户提问 |
| 2 | (无) | 从知识库中检索与问题相关的文档,和问题组合成新的提示 |
| 3 | LLM 凭训练时学到的内容生成回答 | LLM 根据问题加上检索到的文档生成回答 |
文档可以是最新的、来自可信来源,所以 RAG 同时应对两个问题。问“现任加拿大总理是谁”,RAG 系统先检索最近的新闻,再据此回答。检索到的文档还能当作引用,读者可以查到每个说法的出处。课上的例子是 ChatGPT 加持的必应(Bing)搜索:它把复杂问题拆成几个简单问题,分别检索答案,再合并起来并注明来源。
放到医疗里是这样:回答一个药物剂量问题之前,系统先检索当前的临床指南,依据指南原文来回答,而不是依据模型训练时见过的旧版本。RAG 不改动模型本身,效果也取决于检索到了什么。检索到的文档本身有错或者过时,或者模型读错了,答案照样会错。
不周到或有害的回答:RLHF
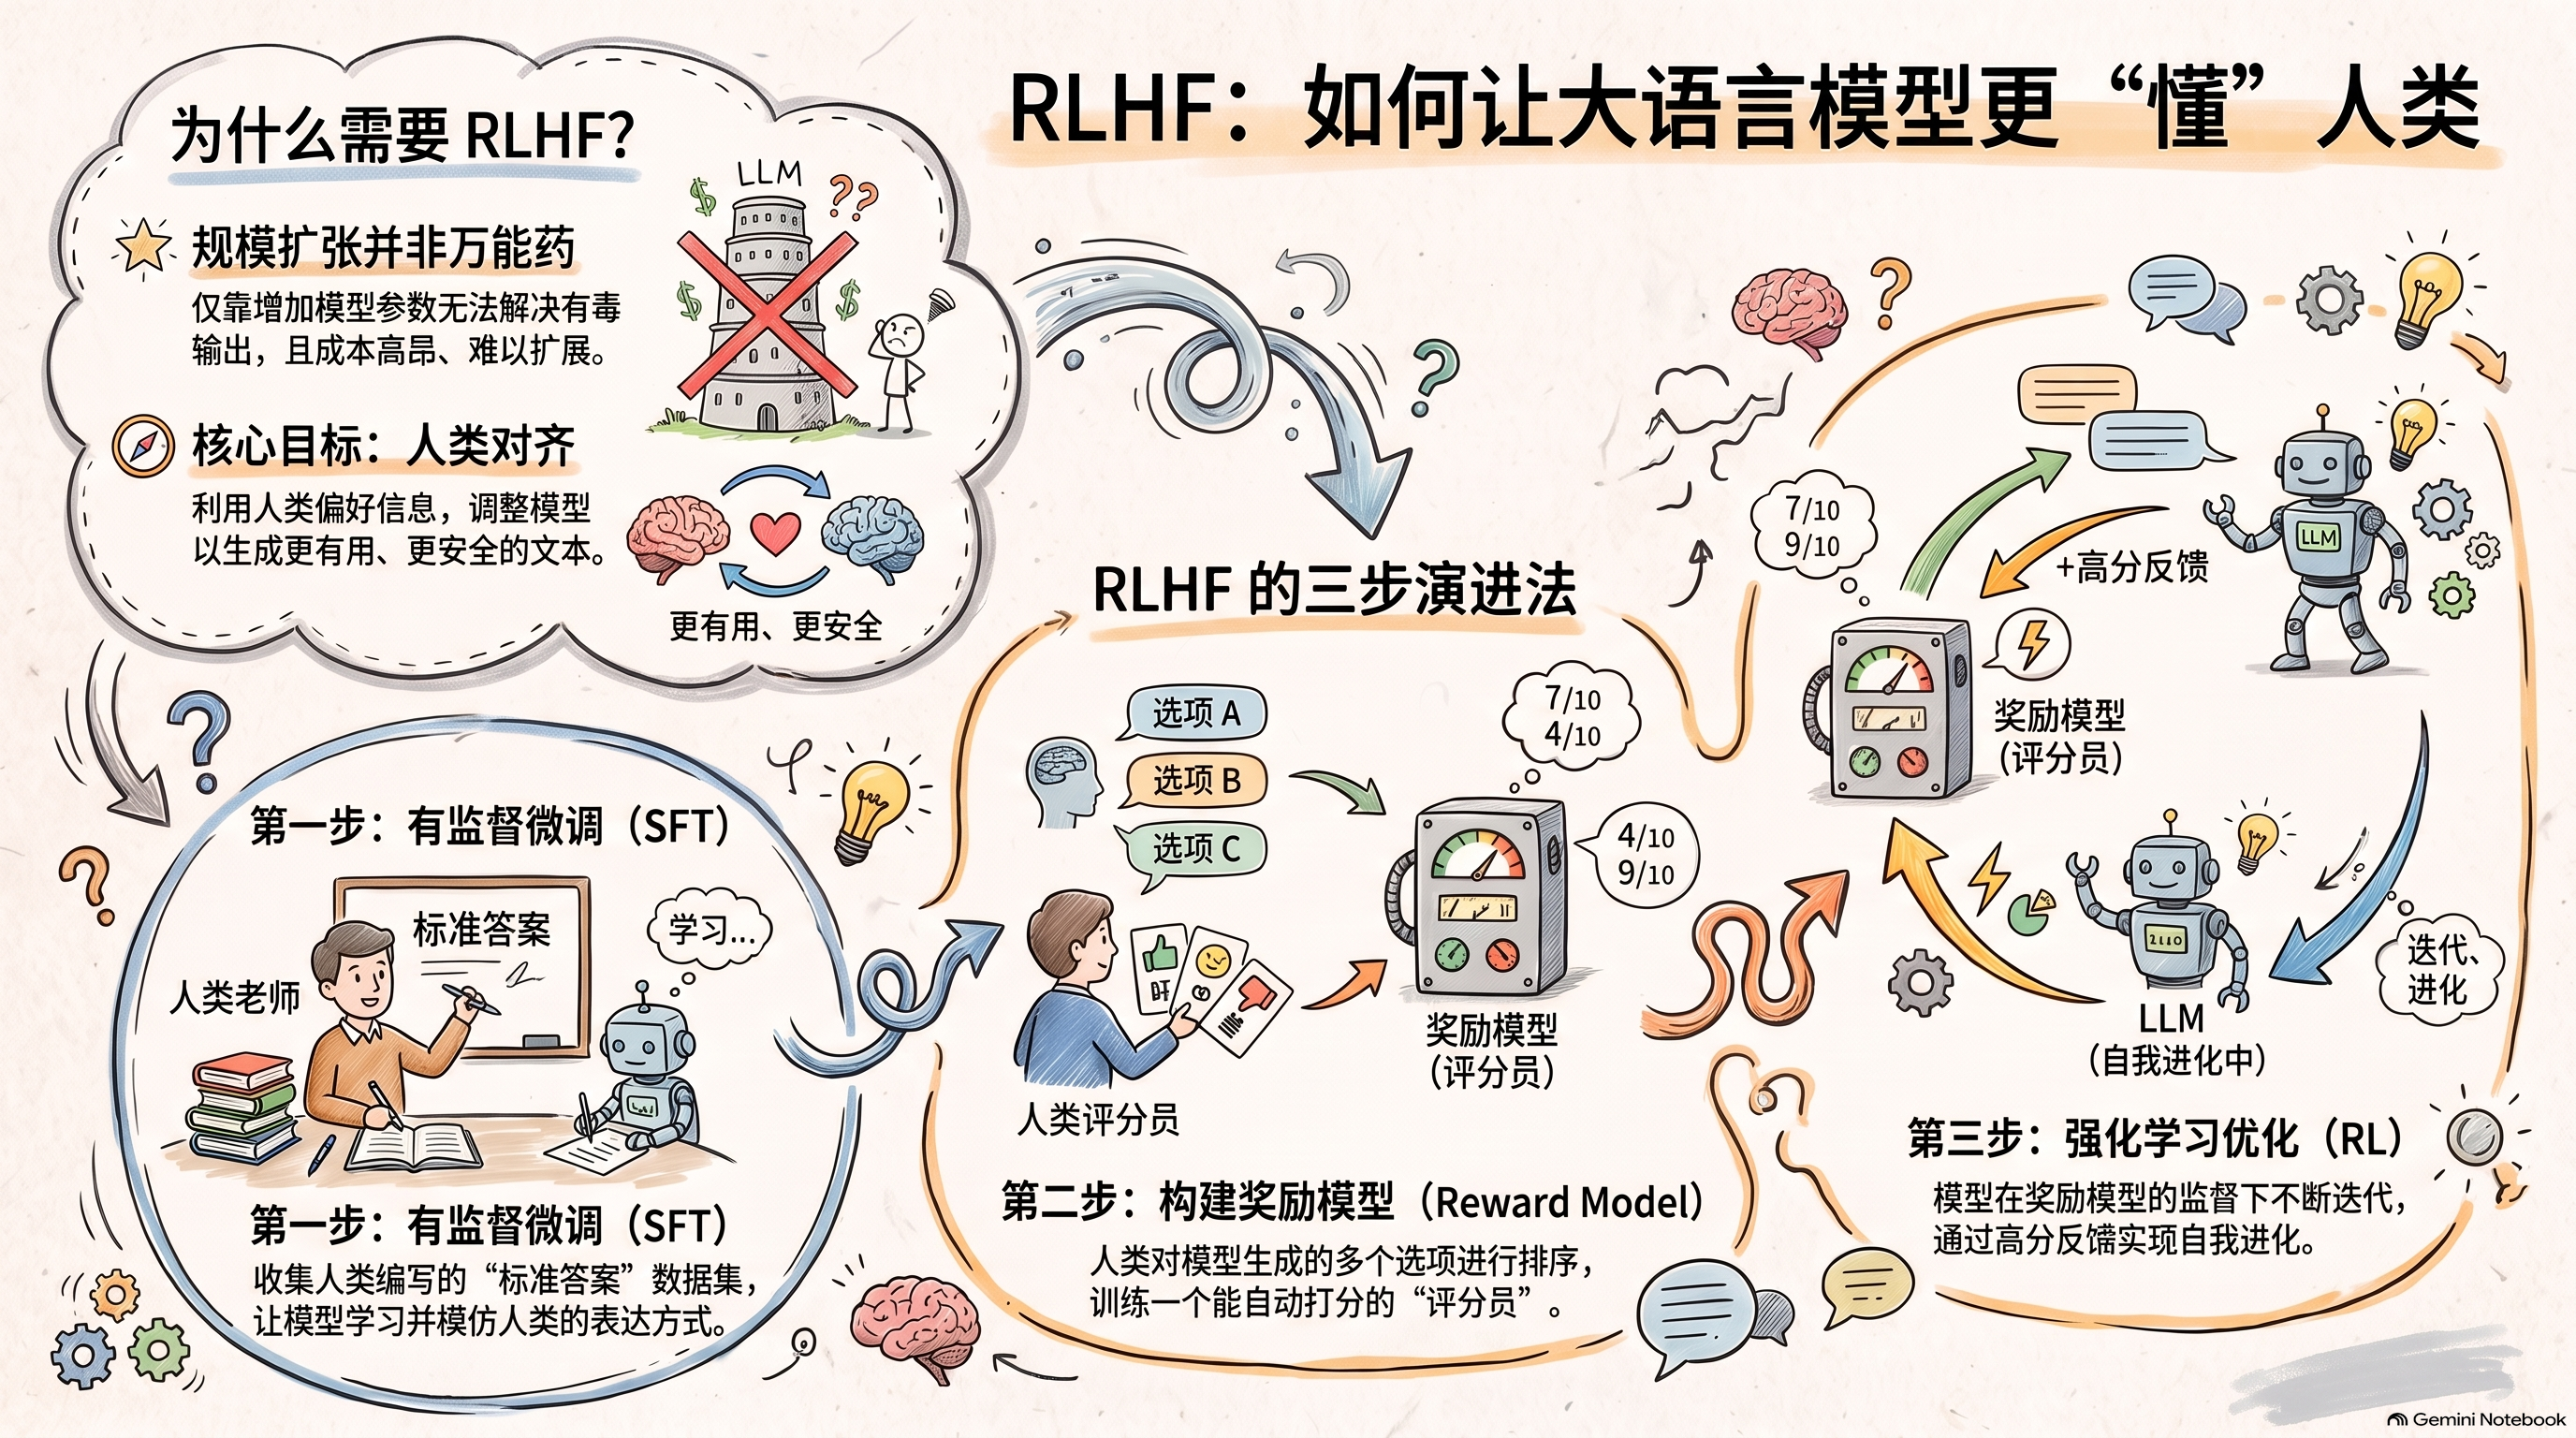
LLM 的回答有时内容不假,却没有帮助、考虑不周,甚至有害。一味把模型做大太昂贵,不是可持续的办法。人类反馈强化学习(Reinforcement Learning from Human Feedback,RLHF;Ouyang 等,2022)改用人类反馈来微调模型,让它的行为和用户的意图对齐。一共三步:
| 步骤 | 人做什么 | 训练什么 |
|---|---|---|
| 1. 有监督微调 | 标注员为提示写出理想答案,例如“给 6 岁孩子讲讲登月” | 微调 LLM,让它像标注员那样回答 |
| 2. 奖励模型 | 标注员把模型对同一提示的几个回答从好到差排序(课上的例子:D > C > A = B) | 训练一个单独的奖励模型,学会给任意回答打分,复现这些排序 |
| 3. 强化学习优化 | (不再需要新的标注) | LLM 生成回答,奖励模型打分,LLM 据此更新,争取更高的分数 |
也就是说,人类的偏好通过第 1 步的示范和第 2 步的排序进入,再由奖励模型在第 3 步大规模地传递下去。和 RAG 不同,RLHF 会改变模型的权重。这一讲的补充幻灯片还提到了直接偏好优化(DPO):它直接从偏好对里学习,不需要单独的奖励模型,是第 3 步的一个更简单的替代。
偏差:模型照出训练数据的样子
LLM 往往会反映、有时还会放大训练数据中的偏差。课程列出三种常见类型:
| 类型 | 表现 | 例子 |
|---|---|---|
| 刻板印象与社会偏见 | 关于性别、种族、宗教、年龄或其他身份的有害刻板印象 | 把某些职业和女性或男性绑在一起 |
| 有害内容与仇恨言论 | 复述训练数据里冒犯性或仇恨性的语言,碰到敏感话题时尤其明显 | 侮辱性称呼、冒犯性笑话 |
| 代表性偏差 | 数据里有些群体占比过高、有些过低,留下系统性的盲区 | 英语和西方文化语境占主导 |
性别的例子用的是词向量。每个词表示成一个向量,两个向量的相似度(余弦相似度)反映模型认为它们有多接近。和 nurse 最接近的词是 midwife(助产士)、mother(母亲)、wife(妻子)和 widower(鳏夫)。其中大多是女性词,说明这种表示吸收了“护士是女性”的刻板印象。(课程列表里还有 widower,即丧妻的男子,可见这种拉扯不只关乎性别,也偏向家庭和照护角色。)Bolukbasi 等(2016)在常用词向量里发现了同样的规律。
模型产出什么,取决于给它喂了什么数据。英文资料占多数,或者数据本身就带着偏见和有害内容,回答也会带上这些偏差。课程列出四种缓解办法:
| 方法 | 作用阶段 | 怎么做 |
|---|---|---|
| 数据整理 Data curation | 训练之前 | 删除或平衡有偏的数据。数据量达到数十亿甚至上万亿份文档时很难做到 |
| 事后过滤 Post-hoc filtering | 推理时,也就是回答时 | 用审核层(通常是分类器)检测并拦截有害或有偏的输出;很多商用 LLM 都这样做 |
| RLHF | 微调阶段 | 用人类反馈引导模型不去放大偏差 |
| 透明度与可解释性 | 训练之后 | 追查模型的哪些部分编码了某种偏见,再修改这些部分 |
怎样在去除偏差的同时不损失目标任务的准确度,仍在研究之中。
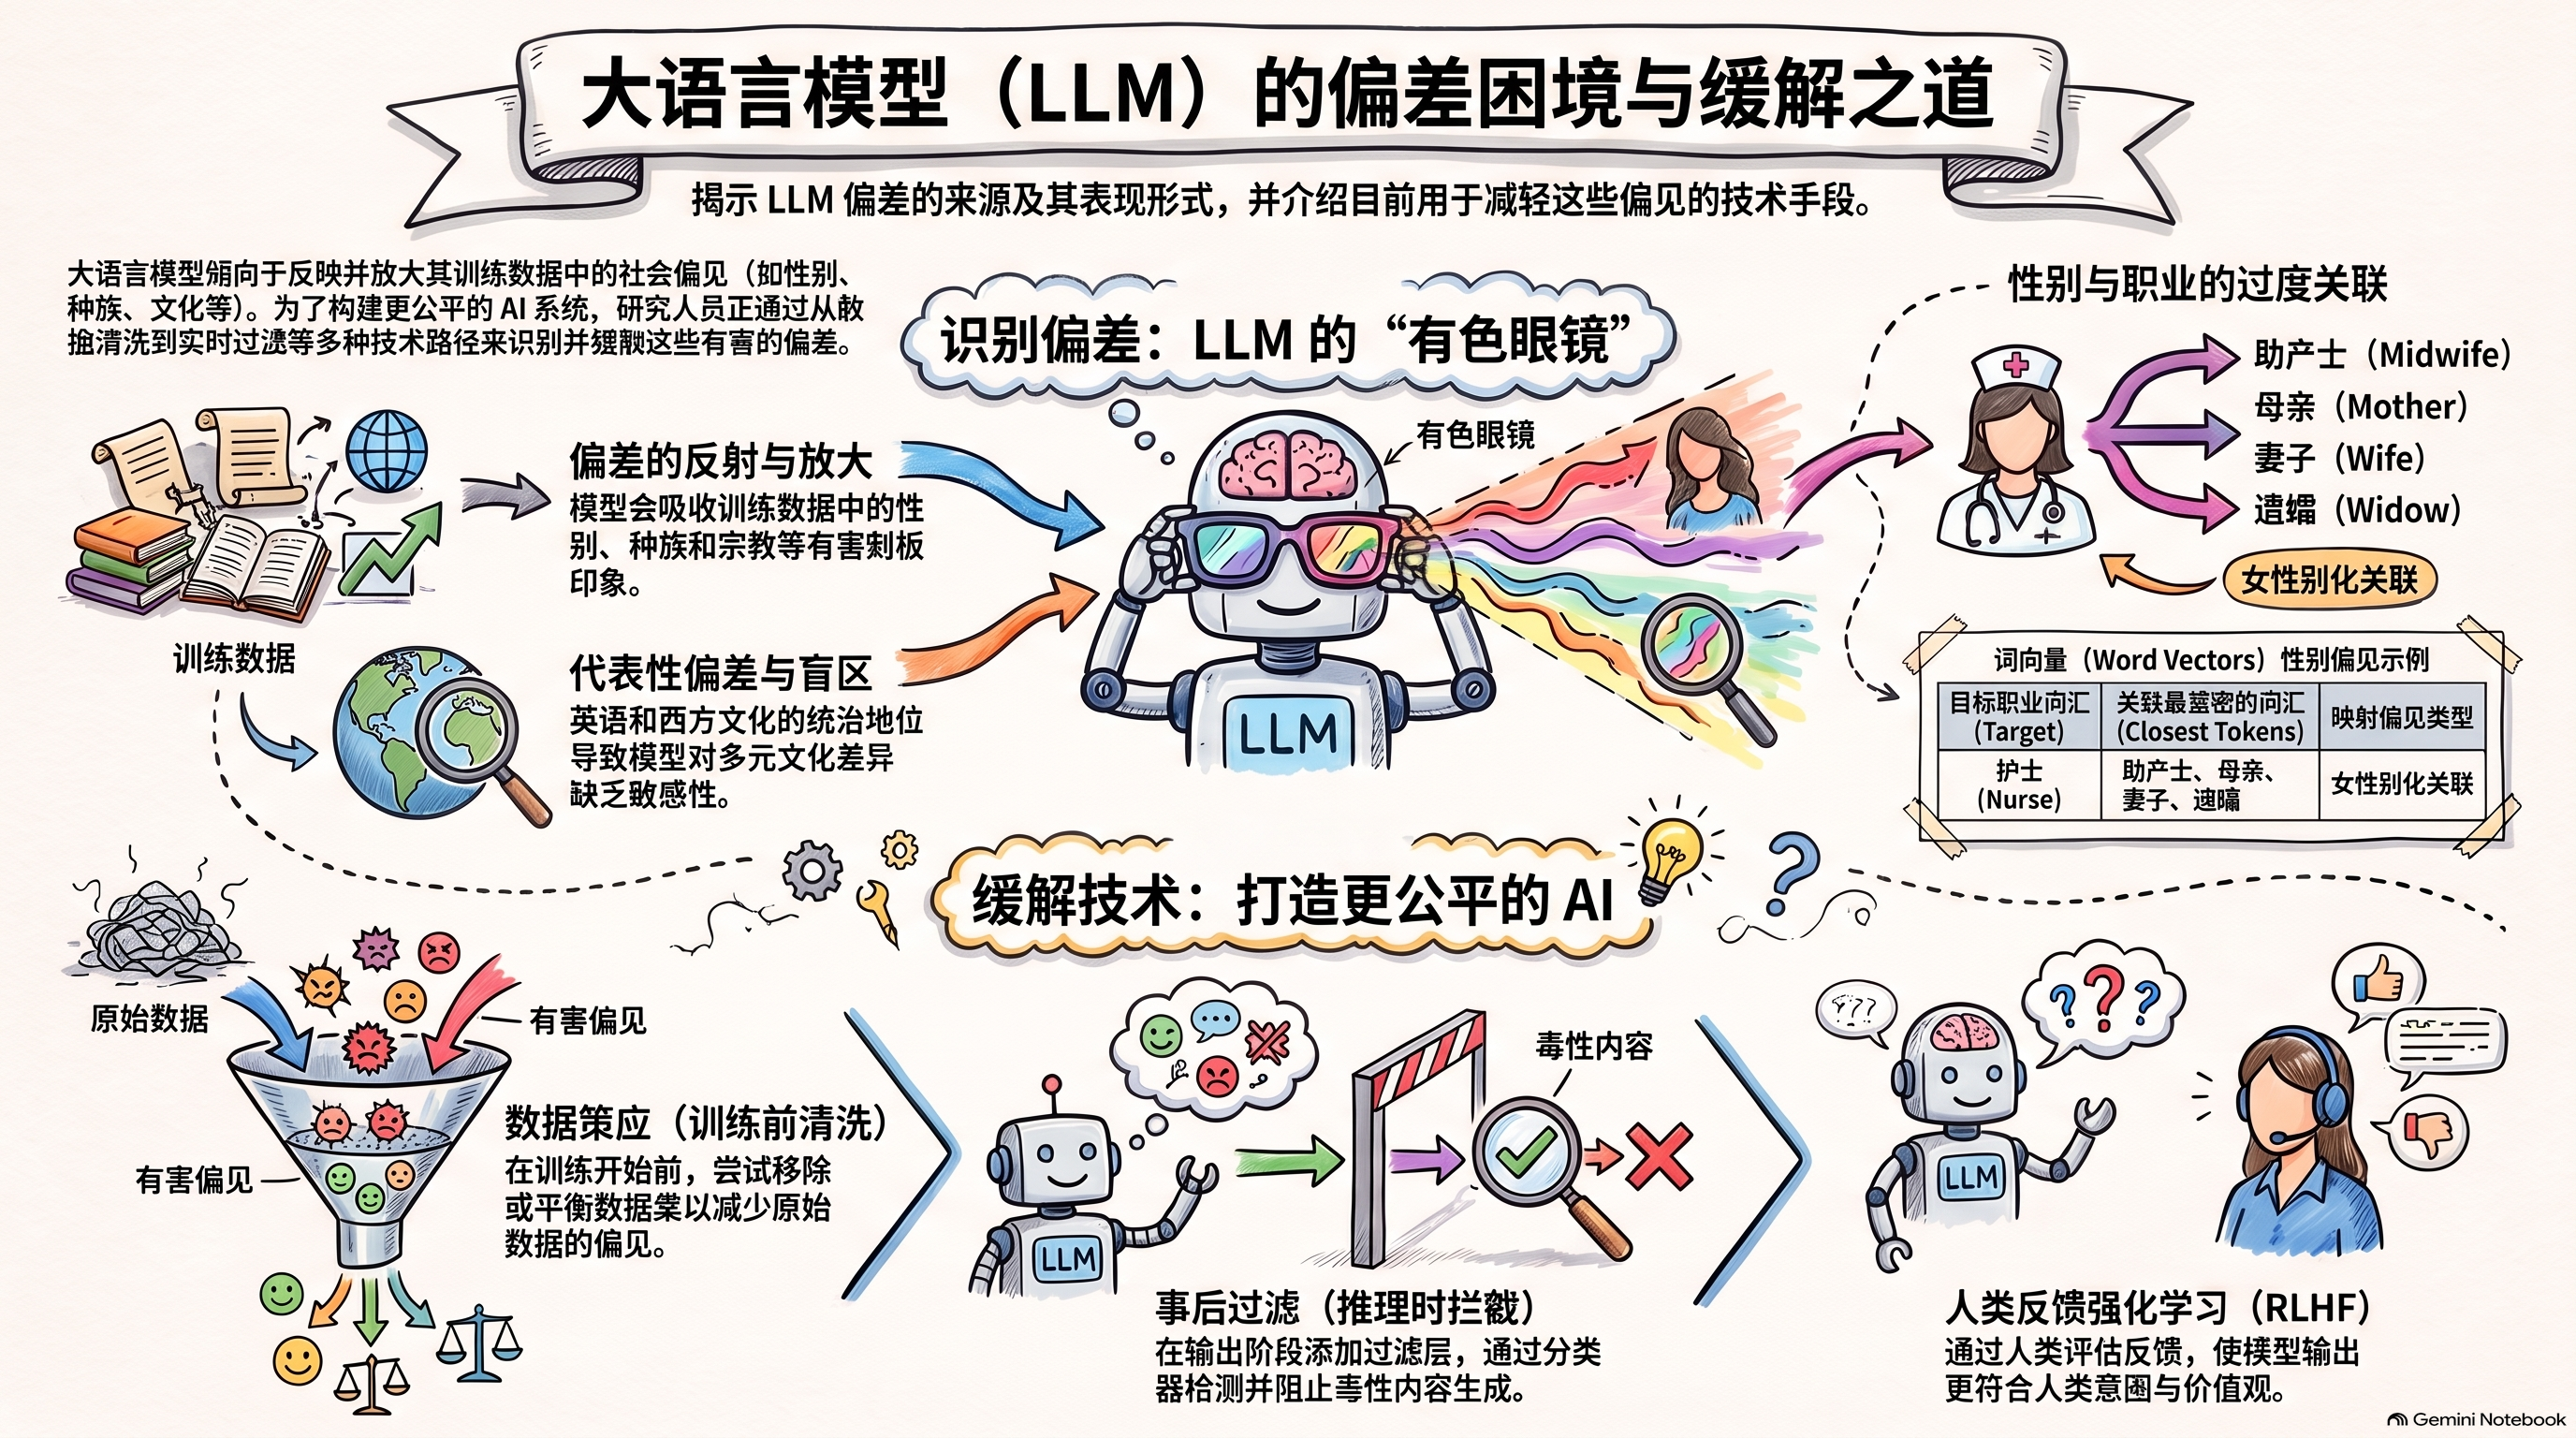
阅读提示:图中“数据策应”应为数据整理(data curation),“数据桊”应为数据集;右侧表格里“向汇”应为词汇,“最蓌密”应为最紧密,“迪瞒”是乱码。课程列表里是 widower(鳏夫),图里写成了“遗孀(Widow)”。课程的第四种办法,透明度与可解释性,图里没有画出来。
可解释性:打开黑箱
LLM 是一个有数十亿权重的神经网络,知识和推理都隐含在这些权重里,我们看得到答案,却看不到答案是怎么得出的。可解释性(interpretability)就是要理解模型怎样、为什么给出它的输出,以及它表示了哪些信息、怎样表示、存在哪里。
它能提升三件事:
- 信任与问责:向专家和非专家解释模型的预测,这在医学等领域至关重要。
- 调试:查明模型为什么出错,比如产生幻觉,好修复对应的部分。
- 偏见与公平性审计:找出有害模式从哪里来。
课程介绍了两种主要方法:
| 方法 | 看什么 | 例子 |
|---|---|---|
| 分析注意力模式 | 注意力矩阵:每个词的含义在多大程度上取决于其他词(汇总后也可以看句子之间) | 从中提取树状结构,和已知的句法或篇章结构对比:哪些学到了、哪些缺失、怎样补进去 |
| 机制可解释性 | 权重矩阵、神经元、激活路径和“电路”(子网络) | 找出模型回忆“秘鲁首都”时被强烈激活的神经元;追踪做两数相加时信息怎样逐层流动;找出把中文翻译成他加禄语时活跃的电路 |
机制可解释性是两者中更有野心的一种。追踪信息流动、找出重要神经元、修改权重来检验假设,都是它的工具。目标是让模型更透明、更容易调试、也更安全。
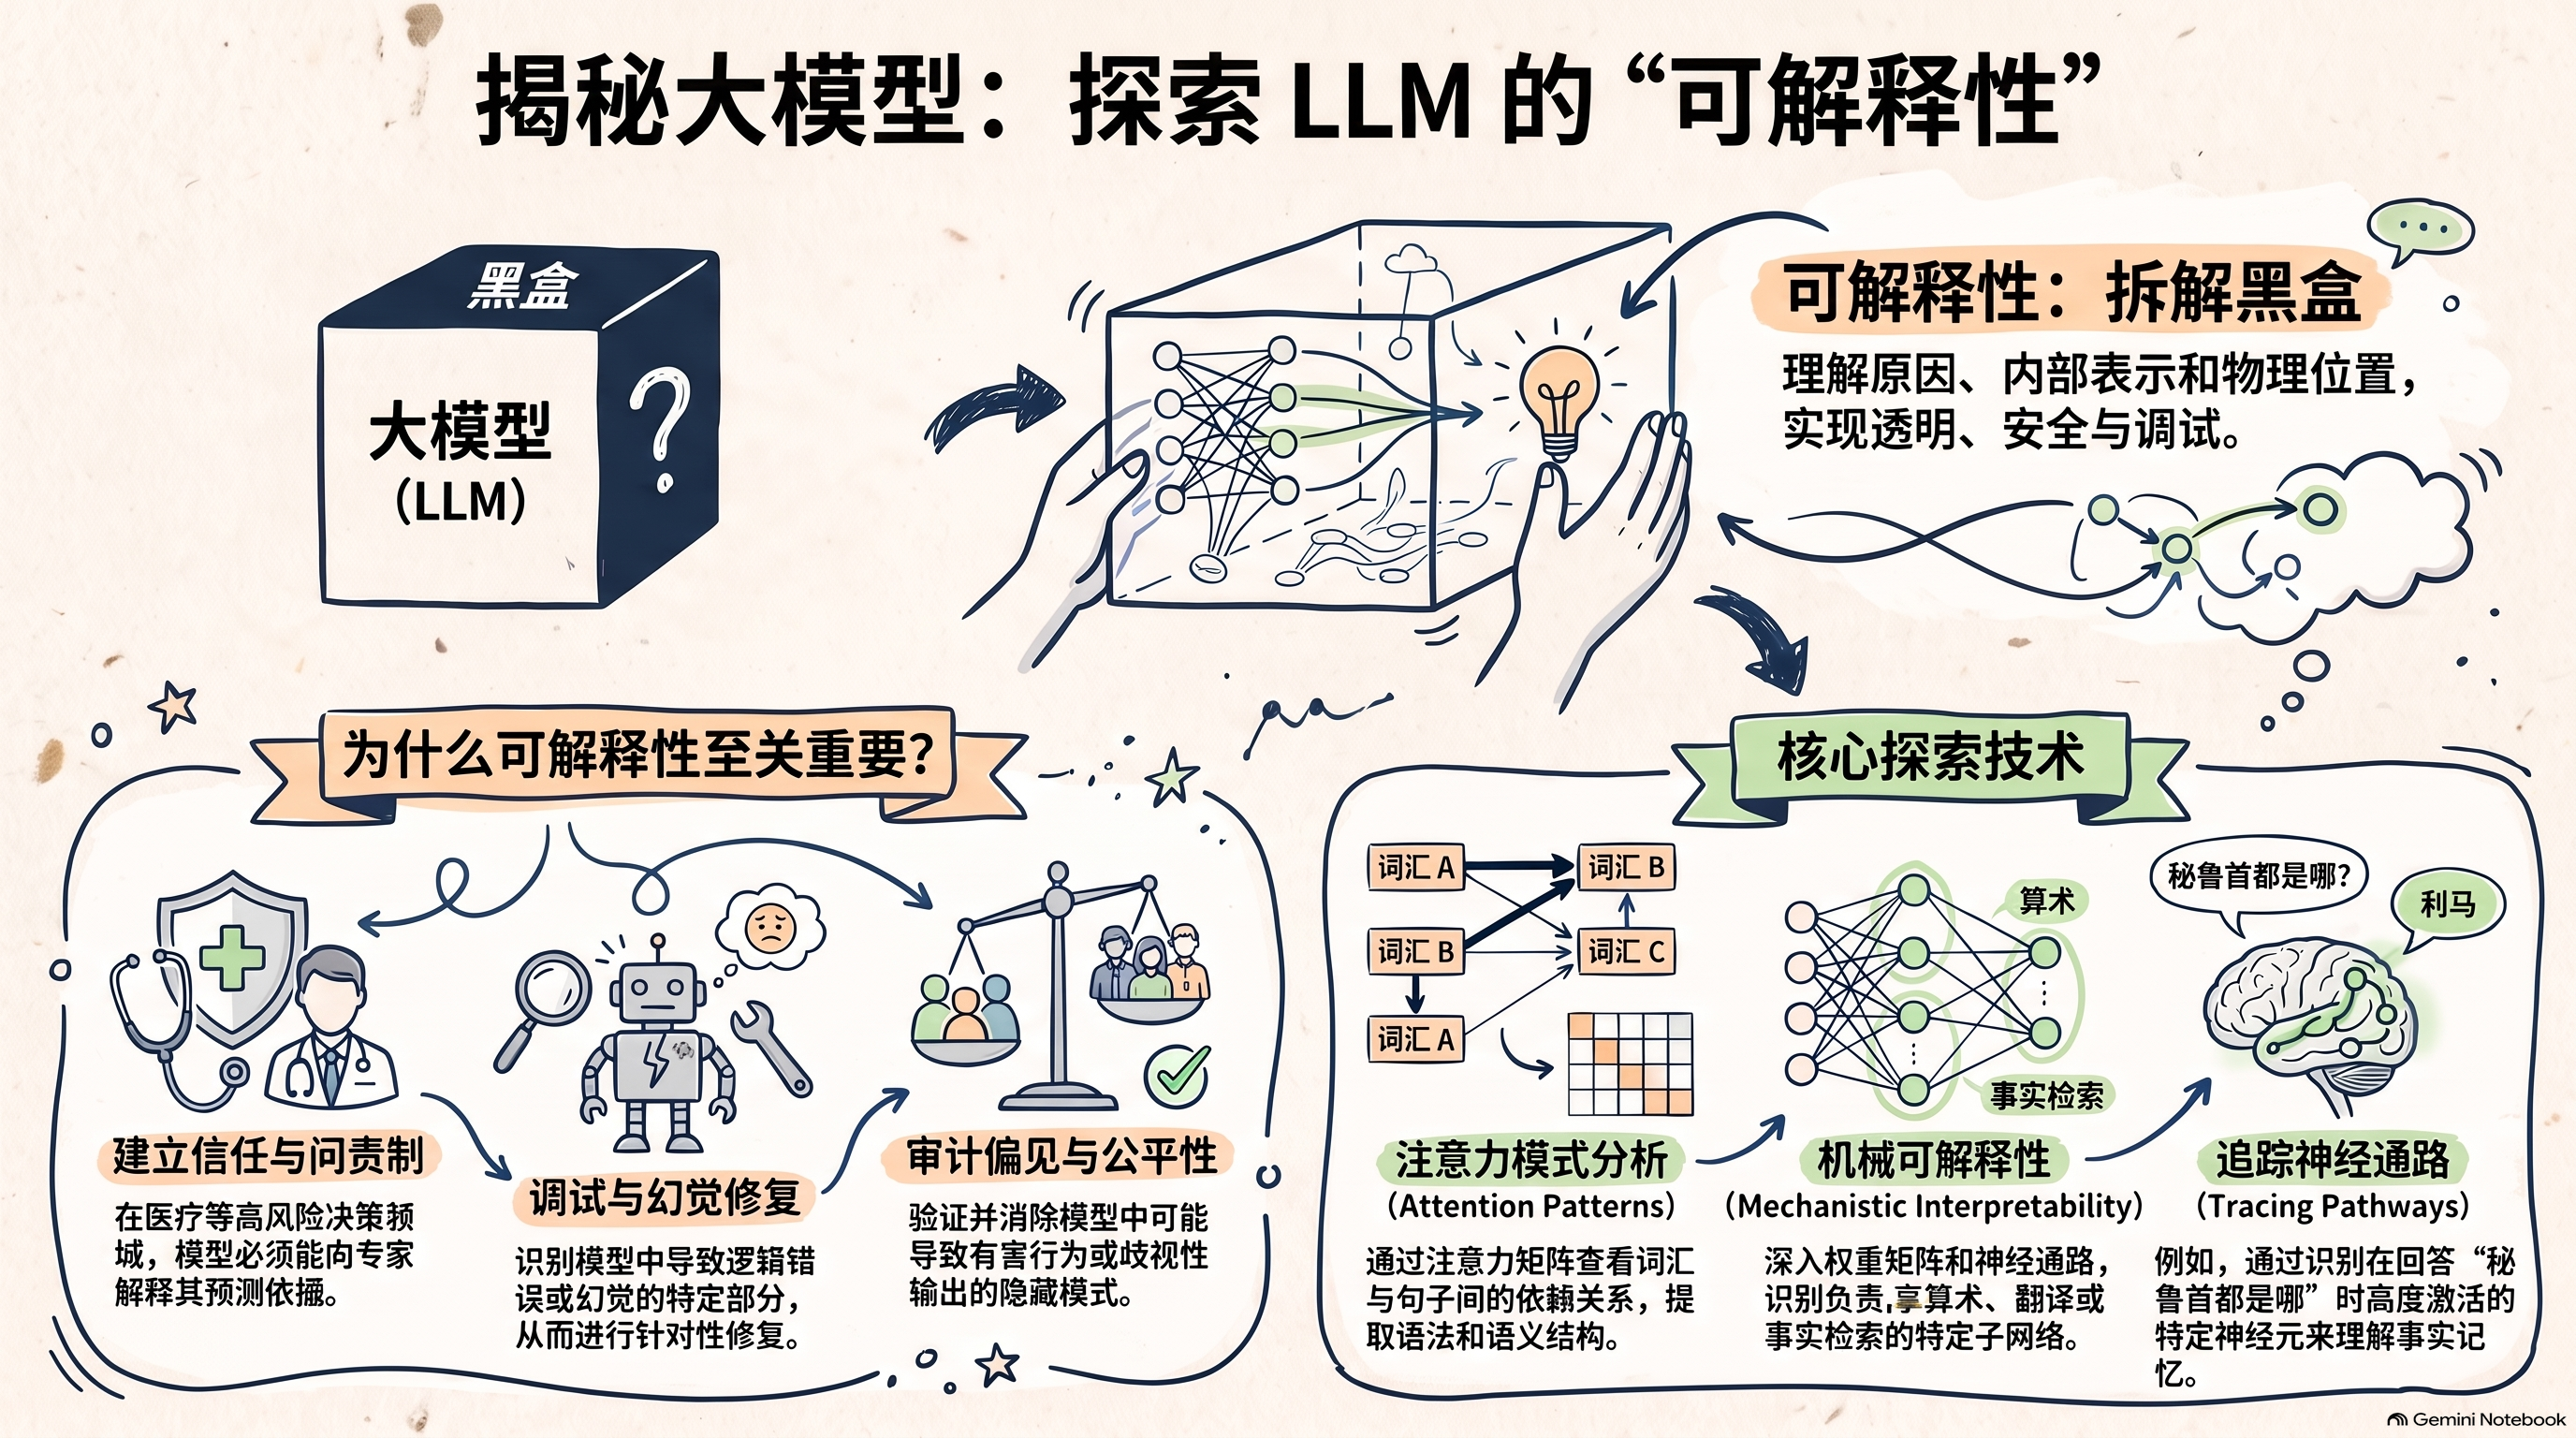
阅读提示:“物理位置”指的是信息存在网络的哪个位置;图下方有几处错字:“决策预域”应为决策领域,“预测依攄”应为预测依据,“负责享算术”应为负责算术。课上,“秘鲁首都”是找重要神经元的例子,追踪信息流用的是两数相加的例子,而且追踪信息流属于机制可解释性的工具之一。
我的思考
相信很多人在使用 ChatGPT、Gemini、Claude 等工具时,都遇到过它们编答案,还编得和真的一样,这就是 AI 的幻觉。回忆一下前面介绍的 LLM 怎样给出答案:训练时在 token 之间建立联系、学习概率,然后预测下一个 token。这也就意味着,LLM 可能知道下一个位置应该输出一个数字,甚至是一个合理范围内的数字,但具体数字是否正确,无法保证。这也是为什么人在缺乏相关知识时,很容易被骗过去。
这个问题目前还不能说完全解决,只能通过一些方法改进。RAG 就是其中一种:系统先查找最新、可信的资料,再根据资料回答,就像我回答一个用药问题之前,会先查最新的指南一样。
另一种幻觉是每个事实都对,顺序却错了,比如病历里写成先做心电图、后出现胸痛。每句话单独看都合理,而生成过程中并没有一步去核对事件实际的先后。FActScore 和 DoveScore 就是用来发现这类错误的:先提取原子事实,再评估每条事实是否正确,再评估事实之间的顺序。它们衡量问题,而不是预防问题,但先找得到,才谈得上改。
LLM 还可能存在偏差,或者给出考虑不周的回答。偏差主要来自喂给模型的数据:如果训练数据本身就带着偏见或有害内容,它生成的答案也很难好。所以改进首先要提高数据质量。由于在网络规模上清洗数据非常困难,过滤输出、RLHF 和可解释性也要一起用上。
其实这些问题最大的后果,是我们该对 LLM 生成的结果有多少信任。LLM 发展得很快,也确实能提高很多效率,但尤其是想要应用在一些特定行业时,比如健康医疗,以及涉及生命安全的技术开发,一定要谨慎,需要人来把控质量。LLM 是一个黑箱,对于看不见的步骤,在彻底拆解之前,我们都应该保持谨慎和怀疑,哪怕结果是正确的。
学习来源与资源
这篇笔记来自我在不列颠哥伦比亚大学(UBC)微证书项目“Natural Language Processing to Improve Patient Care”中,“Overview of NLP and Large Language Models”课程的学习笔记(Giuseppe Carenini 主讲的“LLMs: Open Issues and Solutions”一讲)。技术细节核对了以下资料:
- OpenAI(2023),GPT-4 Technical Report(局限性部分)。
- Liévin、Hother、Winther(2022),Can large language models reason about medical questions?
- Min 等(2023),FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation(EMNLP 2023)。
- Zheng、Lapata、Pan(2025),Long-Form Information Alignment Evaluation Beyond Atomic Facts(DoveScore 与 MontageLie 基准)。
- Lewis 等(2020),Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks。
- Ouyang 等(2022),Training language models to follow instructions with human feedback(InstructGPT,RLHF 三步流程)。
- Bolukbasi 等(2016),Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings。
动手试一试
- FActScore(GitHub):作者公开的代码和数据,README 里说明了怎样用维基百科给自己模型生成的人物简介打分。
- Illustrating RLHF(Hugging Face):用图示一步步讲清 RLHF 的三个步骤。
- BertViz:在笔记本里可视化 Transformer 的注意力头,可以自己看看注意力模式。
- Neuronpedia:开放的机制可解释性平台,可以浏览单个神经元对应的特征,用自己的文本测试。
- Tracing the thoughts of a large language model(Anthropic):在实际使用的模型里追踪“电路”的易读案例,包括多步推理和编造答案。