
斯坦福 · Probability for AI · 第二周第一课 / PAI002
随机变量与三种常见分布:从 PMF 到 AI 水印
斯坦福 Probability for AI(PAI)第二周从“事件”走到“随机变量”:不再只问某件事会不会发生,而是给每个结果配一个数,再看每个数出现的概率有多大。这篇笔记整理了概率质量函数(PMF)、期望和方差,以及计算机里最常用的三种分布:伯努利、二项和泊松。最后一部分是我上课时最感兴趣的问题:改变这些概率,能不能影响 AI 写出来的内容?
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
随机变量与 PMF
随机变量 X 给每个结果配一个数,比如骰子的点数。它的 PMF 列出每个取值的 P(X = x):每根柱子是一个取值,柱高是概率,所有柱高加起来等于 1。
期望与方差
期望 E[X] = Σ x · P(X = x) 是 PMF 的平衡点,也就是长期平均值;方差 E[(X − μ)²] 衡量取值围绕它散开多少。骰子:3.5 和约 2.92。
伯努利、二项、泊松
伯努利:一次是/否试验,成功概率 p。二项:n 次独立伯努利试验中成功的次数,期望 np。泊松:固定时间或区域内的事件数,期望 λ;n 很大、p 很小时,令 λ = np 就能近似二项。
水印
生成每个词之前,用前一个词做种子把词表随机分成绿词和红词,并给绿词加一点权重。检测时数绿词:明显多于一半,就说明文字带有水印。
全景图:从随机变量到三种分布
从顶部的标题开始,先读左半边:随机变量的定义,PMF 和它的柱状图,一条绿色箭头连到“AI 的下一个词”,下面是期望和方差,都用掷骰子做例子。右半边从上往下是伯努利 → 二项 → 泊松,蓝色下划线标出“n 很大、p 很小”这个条件,红色是泊松近似的经验法则,绿色是泊松在空间和时间建模上的拓展。底部紫色的一行是水印:怎样通过改变概率影响 AI 生成的内容。右下角是我的总结。
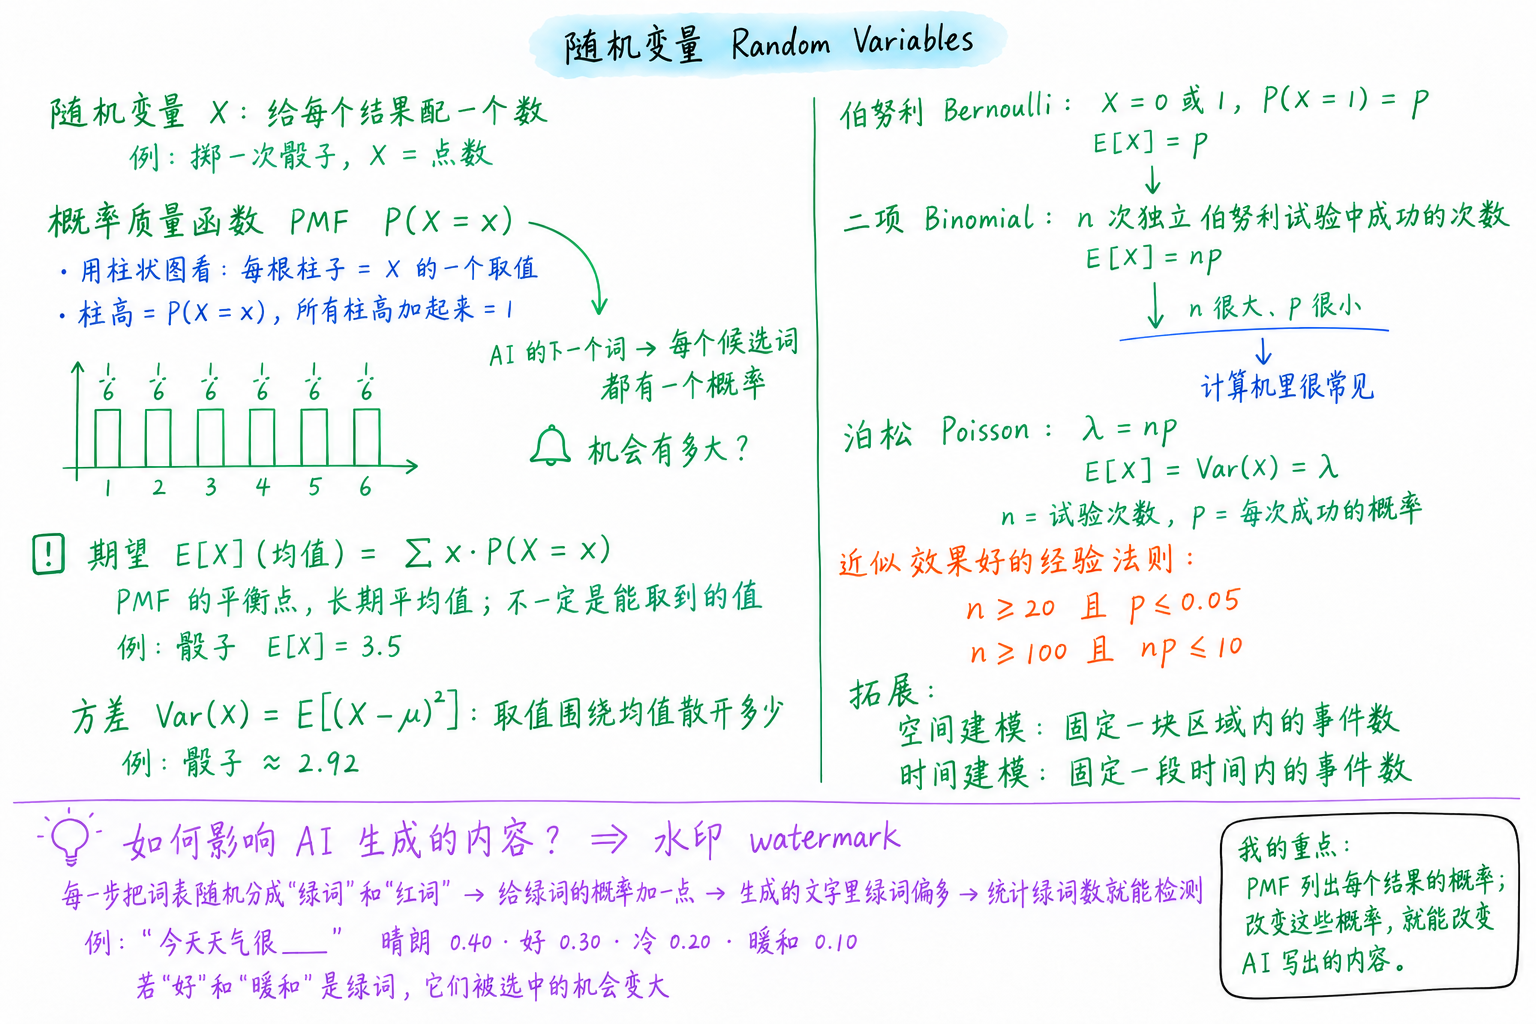
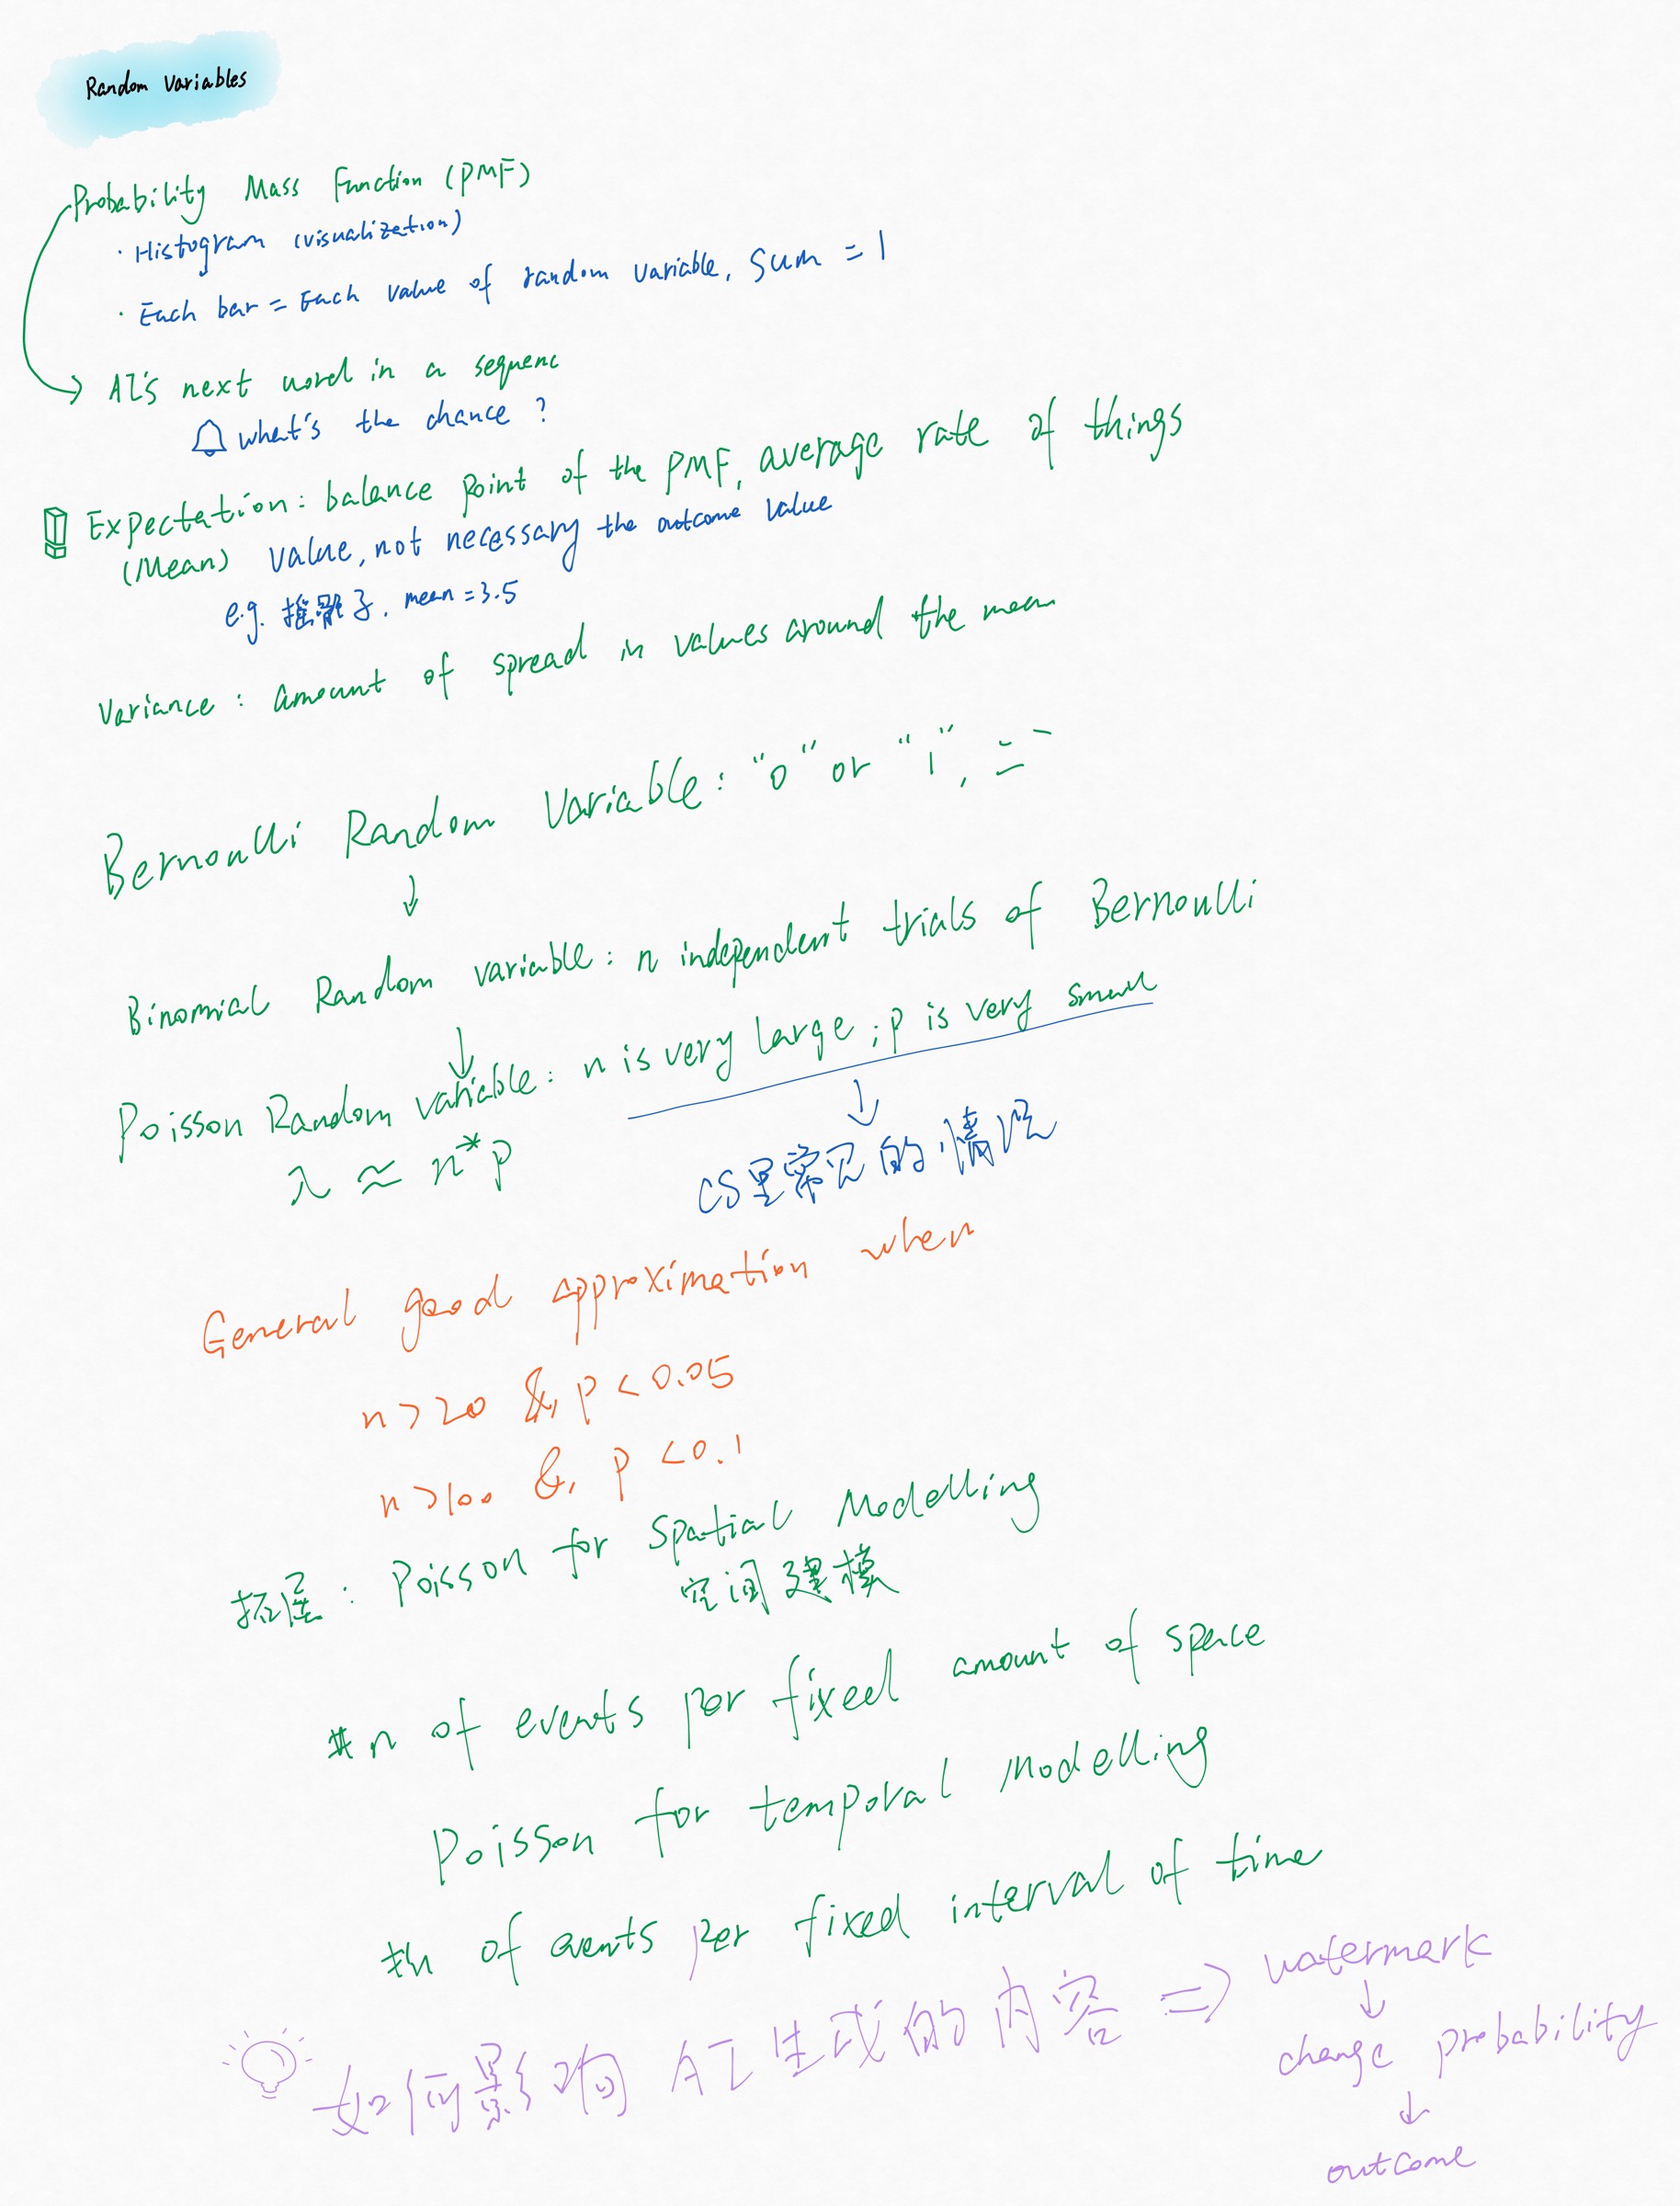
根据我的手写笔记整理,做了几处修正和补充。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
随机变量:给每个结果配一个数
随机变量(random variable)通常记作大写的 X,它给随机试验的每个结果配一个数。掷一次骰子,X 就是朝上的点数,可能取 1 到 6;抛 10 次硬币,X 可以是正面出现的次数,可能取 0 到 10。
有了数,就能做计算:求平均、比大小、算分散程度。上一周的事件(比如“掷出偶数”)在这里可以写成 X 的取值:P(X ∈ {2, 4, 6}) = 0.5。小写的 x 表示 X 可能取到的某个具体值。
概率质量函数 PMF:每个取值有多大概率
概率质量函数(probability mass function,PMF)列出离散随机变量每个可能取值的概率,写作 P(X = x)。它最常画成柱状图:
| 看柱状图的什么 | 含义 | 掷一枚公平的骰子 |
|---|---|---|
| 横轴上的每根柱子 | X 的一个可能取值 x | 1、2、3、4、5、6 |
| 柱子的高度 | P(X = x) | 每根都是 1/6 |
| 所有柱高之和 | 必须等于 1 | 6 × 1/6 = 1 |
如果手上只有数据,把每个取值出现的次数除以总次数,得到的“归一化直方图”就是 PMF 的近似。
在 AI 里,大语言模型每生成一个词,都会对词表里的每个候选词给出一个概率,这就是一个 PMF:柱子是词,柱高是“下一个词是它”的概率,加起来等于 1。模型再按这个分布抽出一个词。
期望:PMF 的平衡点
期望(expectation)E[X],也叫均值(mean),是每个取值乘以它的概率再加起来:
E[X] = Σ x · P(X = x)
把 PMF 的柱子想成放在横轴上的重物,期望就是让横轴保持平衡的那个支点;它也是试验重复很多次后的长期平均值。
掷骰子:E[X] = (1 + 2 + 3 + 4 + 5 + 6) × 1/6 = 3.5。骰子上没有 3.5,所以期望不一定是能取到的值,它描述的是“平均起来在哪里”,不是“最可能出现什么”。
方差:取值围绕均值散开多少
方差(variance)衡量取值离均值有多远,μ 表示均值 E[X]:
Var(X) = E[(X − μ)²]
也可以用更好算的形式 Var(X) = E[X²] − (E[X])²。掷骰子:E[X²] = (1 + 4 + 9 + 16 + 25 + 36) / 6 ≈ 15.17,所以 Var(X) ≈ 15.17 − 3.5² ≈ 2.92。方差的平方根是标准差,单位和 X 相同,更容易直观理解。
两个分布可以期望相同、方差不同:一个总是掷出 3 或 4,另一个总是掷出 1 或 6,平均都是 3.5,后者散得开得多。
三种常见分布:伯努利、二项、泊松
三种分布是一条链:二项由多次伯努利试验组成,泊松又是二项在特定条件下的近似。
| 分布 | X 表示什么 | 参数 | 期望 | 方差 | 例子 |
|---|---|---|---|---|---|
| 伯努利 Bernoulli | 一次试验成功为 1,否则为 0 | p:成功的概率 | p | p(1 − p) | 抛一次硬币是否正面;一封邮件是不是垃圾邮件 |
| 二项 Binomial | n 次独立伯努利试验中成功的次数 | n:试验次数;p:每次成功的概率 | np | np(1 − p) | 抛 10 次硬币,正面出现几次 |
| 泊松 Poisson | 固定时间或区域内事件发生的次数 | λ:平均发生次数 | λ | λ | 一分钟内网站收到多少次访问 |
伯努利只有“是”和“否”两个结果。二项把同一个伯努利试验独立地重复 n 次,数成功了几次:抛 10 次公平硬币,恰好 3 次正面的概率是 C(10, 3) / 2¹⁰ = 120 / 1024 ≈ 0.117,平均会有 10 × 0.5 = 5 次正面。
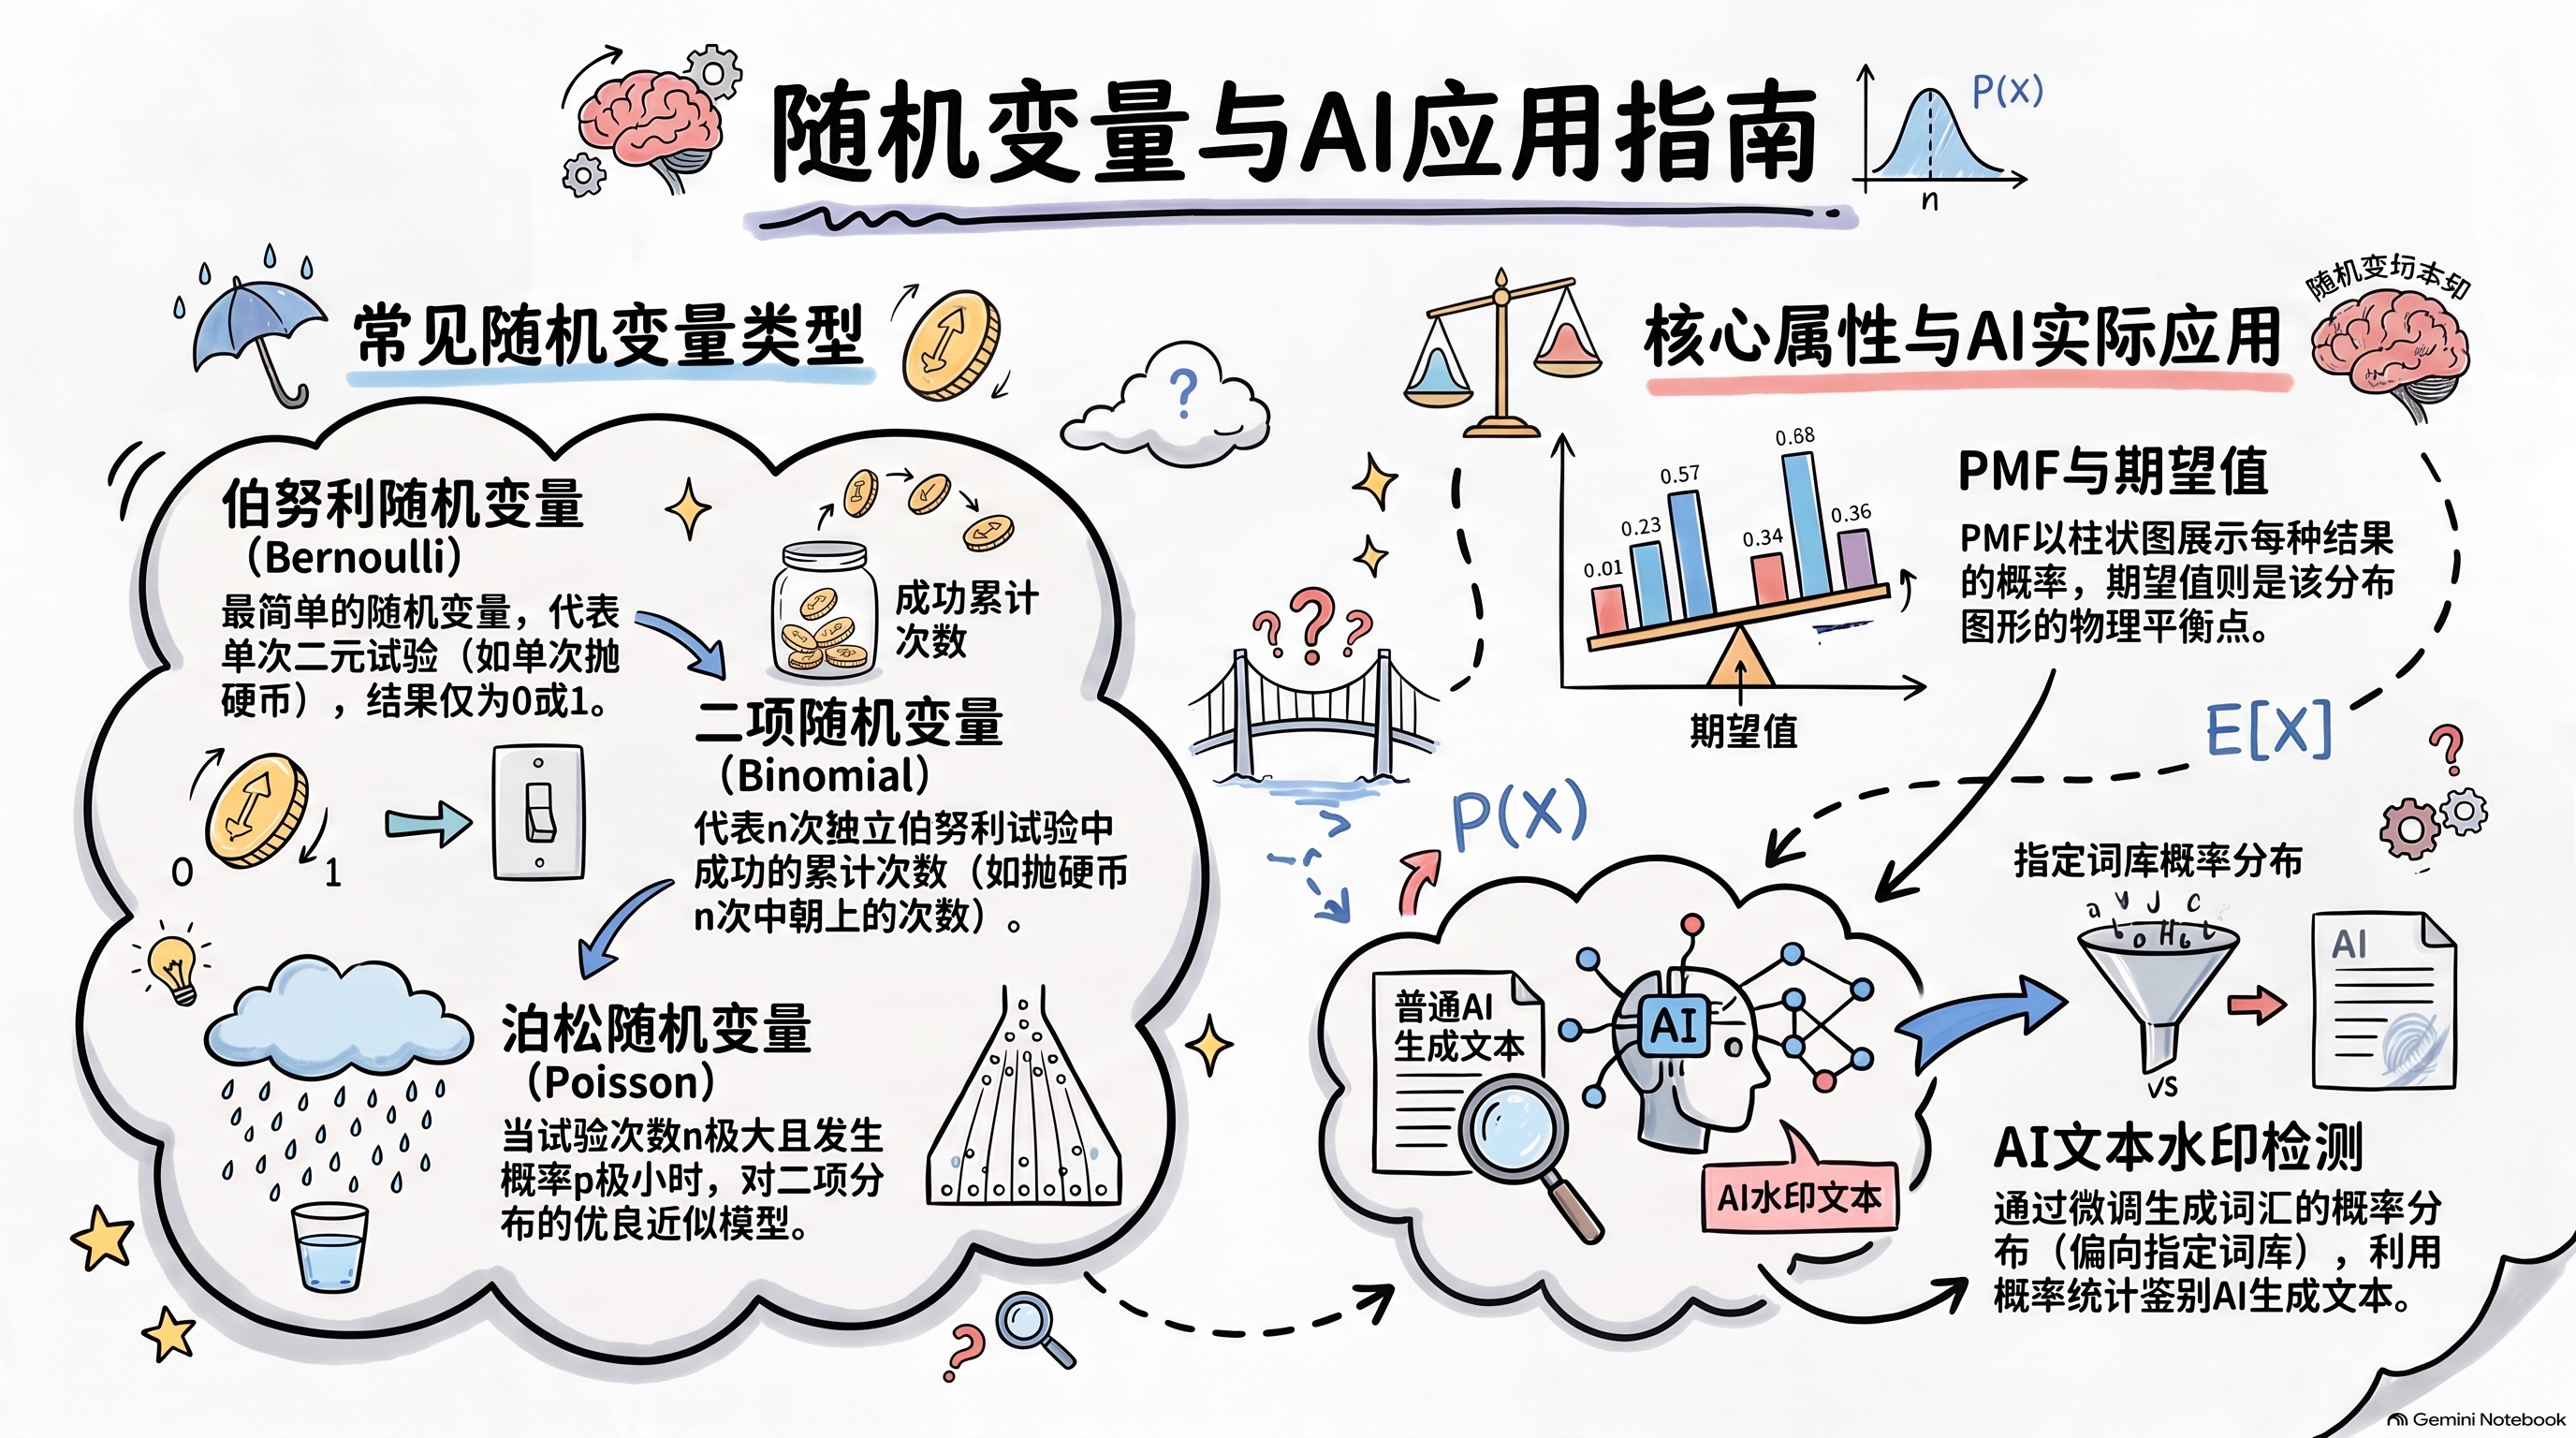
读图提示:右上角 PMF 柱状图标的几个概率加起来超过 1,真正的 PMF 所有柱高之和必须等于 1,这里只是示意。
泊松分布:n 很大、p 很小的时候
当二项分布的试验次数 n 很大、每次成功的概率 p 很小时,直接算二项很麻烦,这时可以用泊松分布近似,令 λ = np:
P(X = k) = λᵏ e^(−λ) / k!
例子:一个网页一天有 1000 次访问,每次访问点开某个广告的概率是 0.002。点击次数严格来说服从二项分布(n = 1000,p = 0.002),用泊松近似时 λ = 1000 × 0.002 = 2,一次都没人点的概率是 e^(−2) ≈ 0.135,和二项的精确结果 0.998¹⁰⁰⁰ ≈ 0.135 几乎一样。n 越大,近似越准。
近似效果好的常用经验法则:
- n ≥ 20 且 p ≤ 0.05;
- n ≥ 100 且 np ≤ 10。
这种“试验很多、每次的概率很小”的情况在计算机里很常见:服务器每分钟收到的请求数、一段文本里的拼写错误数、网络里丢失的数据包数。
拓展:空间与时间建模。泊松分布不只是二项的近似,它本身就用来数“固定范围内的事件数”,前提是事件以稳定的平均速率、彼此独立地发生。
- 时间建模:固定一段时间内的事件数,例如每小时到达急诊的病人数。
- 空间建模:固定一块区域内的事件数,例如一平方公里内的病例数,或显微镜一个视野里的细胞数。
一个经典的历史例子:1898 年,拉迪斯劳斯·博特基维茨(Ladislaus Bortkiewicz)统计了普鲁士骑兵军团每年被马踢死的士兵人数,发现这些罕见事件的次数和泊松分布吻合得很好。
改变概率,就能影响 AI 写出的内容:水印
既然大语言模型每一步都按下一个词的 PMF 抽样,那么只要悄悄改变这个 PMF,就能影响它写出的文字。文本水印(watermark)就是这样做的。Kirchenbauer 等人(2023)的方法是:
- 分组:生成每个词之前,用前一个词做随机种子,把整个词表随机分成“绿词”和“红词”两组(例如各一半)。
- 加一点权重:给所有绿词的分数加上一个常数,绿词被选中的概率就变大了;红词并没有被禁止。
- 检测:拿到一段文字后,用同样的种子重建每一步的绿词表,数一数绿词占多少。人写的文字大约一半是绿词;带水印的文字绿词明显偏多,用一个 z 检验就能判断。
一个例子。模型要补全“今天天气很___”,原来的 PMF 是:晴朗 0.40、好 0.30、冷 0.20、暖和 0.10。如果这一步“好”和“暖和”是绿词,加上权重后(论文实验里常用的强度 δ = 2)大约变成:好 0.62、暖和 0.21、晴朗 0.11、冷 0.06。四个词仍然都可能出现,只是更偏向绿词。一段 200 个词的文字,人写的大约有 100 个绿词;如果数出来有 150 个,z = (150 − 100) / √(200 × 0.25) ≈ 7.1,远高于论文用的阈值 4,基本可以判定带有水印。
需要注意:分组是随机的,和词常不常见无关;当下一个词几乎只有一个合理选择时(比如“中华人民共和___”),加权几乎改变不了结果,所以这类低多样性的文字很难加上水印。
我的思考
这一周要了解的定义不多。概率质量函数 PMF 用柱状图展示,每根柱子是一个可能结果的概率,所有柱子加起来等于 1;放到 AI 里,就是预测一个序列里下一个词的机会有多大。期望和方差可以简单理解:期望是 PMF 的平衡点,方差是取值围绕均值散开多少。
重要的是三个分布。伯努利只有是和否两个结果;二项是同样的是/否试验重复多次,数成功了几次;泊松适用于 n 很大、p 很小的情况,现实中经常用到,还可以拓展到空间建模和时间序列建模。
我最感兴趣的是:可以通过改变概率来影响 AI 生成的内容。在一句话里很多词都可能出现,但如果把一部分词的概率调高,模型就会更多地从这些词里选,水印就是这样做出来的。课程还有一个有意思的地方:老师会讲讲发现这些分布的人。
学习来源与资源
这篇笔记基于我在斯坦福免费在线课程 Probability for AI(PAI,Chris Piech 和 Mehran Sahami 主讲)第二周的学习笔记。定义和例子对照了课程配套读本:
- Chris Piech,Probability for Computer Scientists(CS109 课程读本)中的 PMF、期望、方差、伯努利、二项和泊松分布。
- John Kirchenbauer 等,A Watermark for Large Language Models,ICML 2023(绿词/红词水印与 z 检验)。
动手试一试
- Seeing Theory:Probability Distributions(布朗大学):拖动参数,看伯努利、二项、泊松等分布的柱状图怎样变化。