
UBC · 临床文档的提取与分析 / UBC10
UBC Extraction and Analysis of Clinical Documents:课程介绍
我开始学 UBC 的第二门课了:UBC Extended Learning 的 Extraction and Analysis of Clinical Documents(临床文档的提取与分析)。第一门课打下了 NLP 和大语言模型的基础,这一门把它们用到临床记录、报告和评估上。这一篇介绍这门课在项目里的位置、怎么上、谁来讲、四个模块学什么,以及我学完模块一后的第一印象。
- 章节
- 关键概念
- 阅读提示
这门课和它在项目里的位置
这门课是 UBC 微证书项目“用自然语言处理改善患者照护”(Natural Language Processing to Improve Patient Care)三门五周课程中的第二门。临床记录、报告和评估里有大量关于患者的细节,但它们是非结构化文本,很难大规模分析。这门课教用 NLP 方法对这些文档做分类、信息提取和摘要,也讲大语言模型怎样帮助回答临床问题、辅助书写病历。
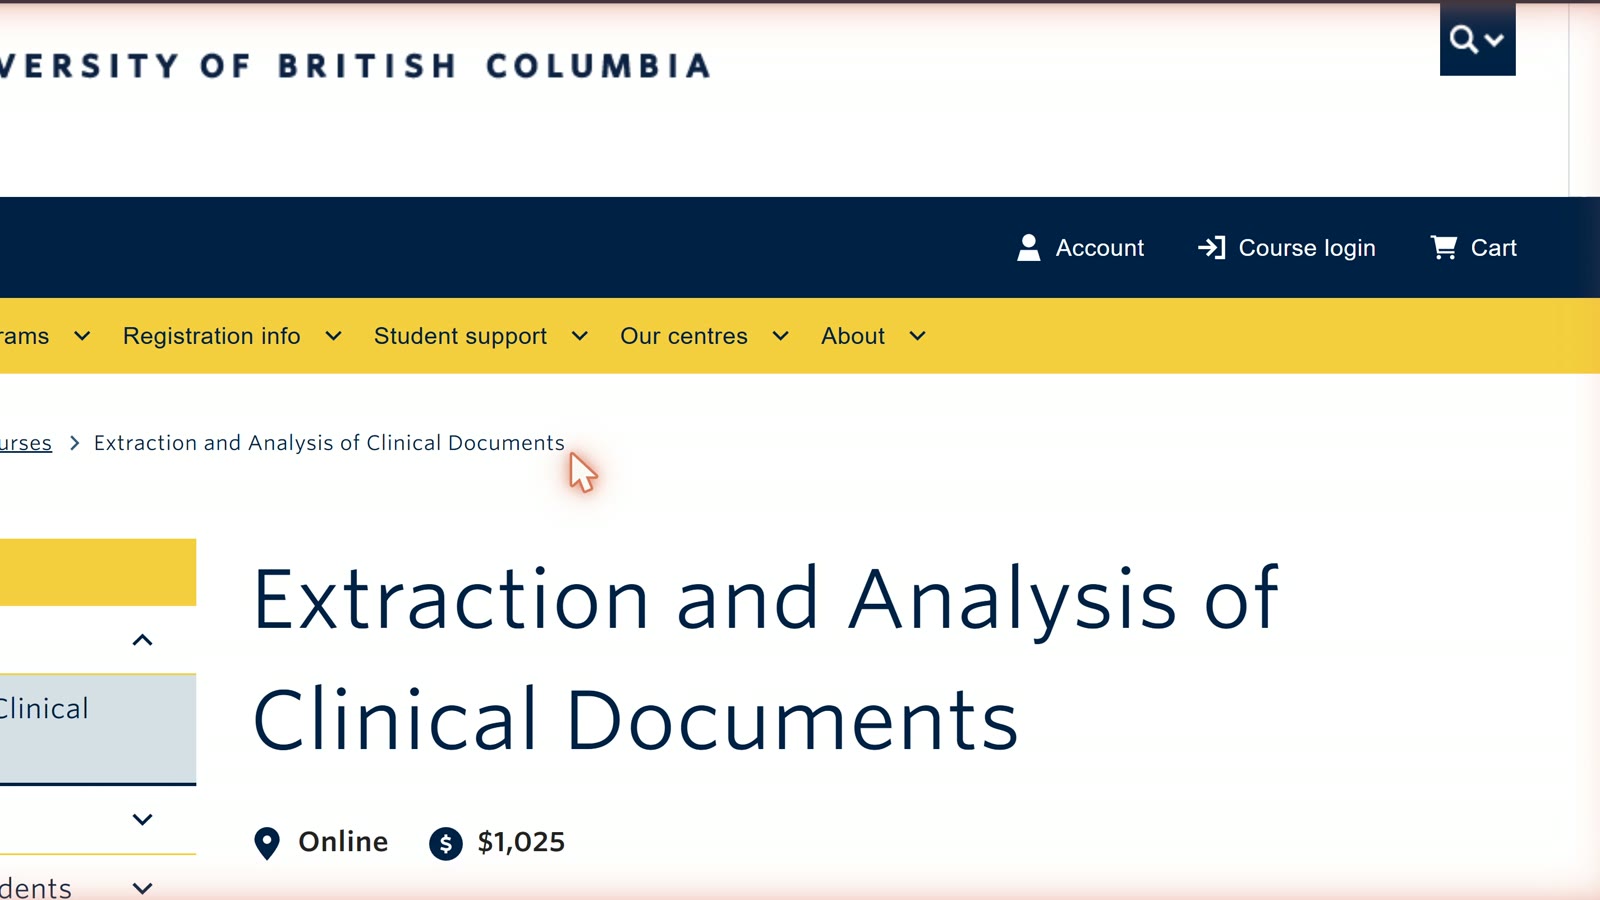
三门课可以单独学,顺序也不限,但 UBC 建议按顺序学;刚接触 NLP 的话,先从 Overview of NLP and Large Language Models 开始。
| 形式 | 完全线上,每周有可选的答疑时间 |
| 时长 | 五周;三门课的整个项目约 75 小时 |
| 费用 | 每门 1,025 加元,整个项目 3,075 加元 |
| 通过要求 | 成绩至少 70%;课程获 UBC CPD 认可 24 学分 |
课程怎么上
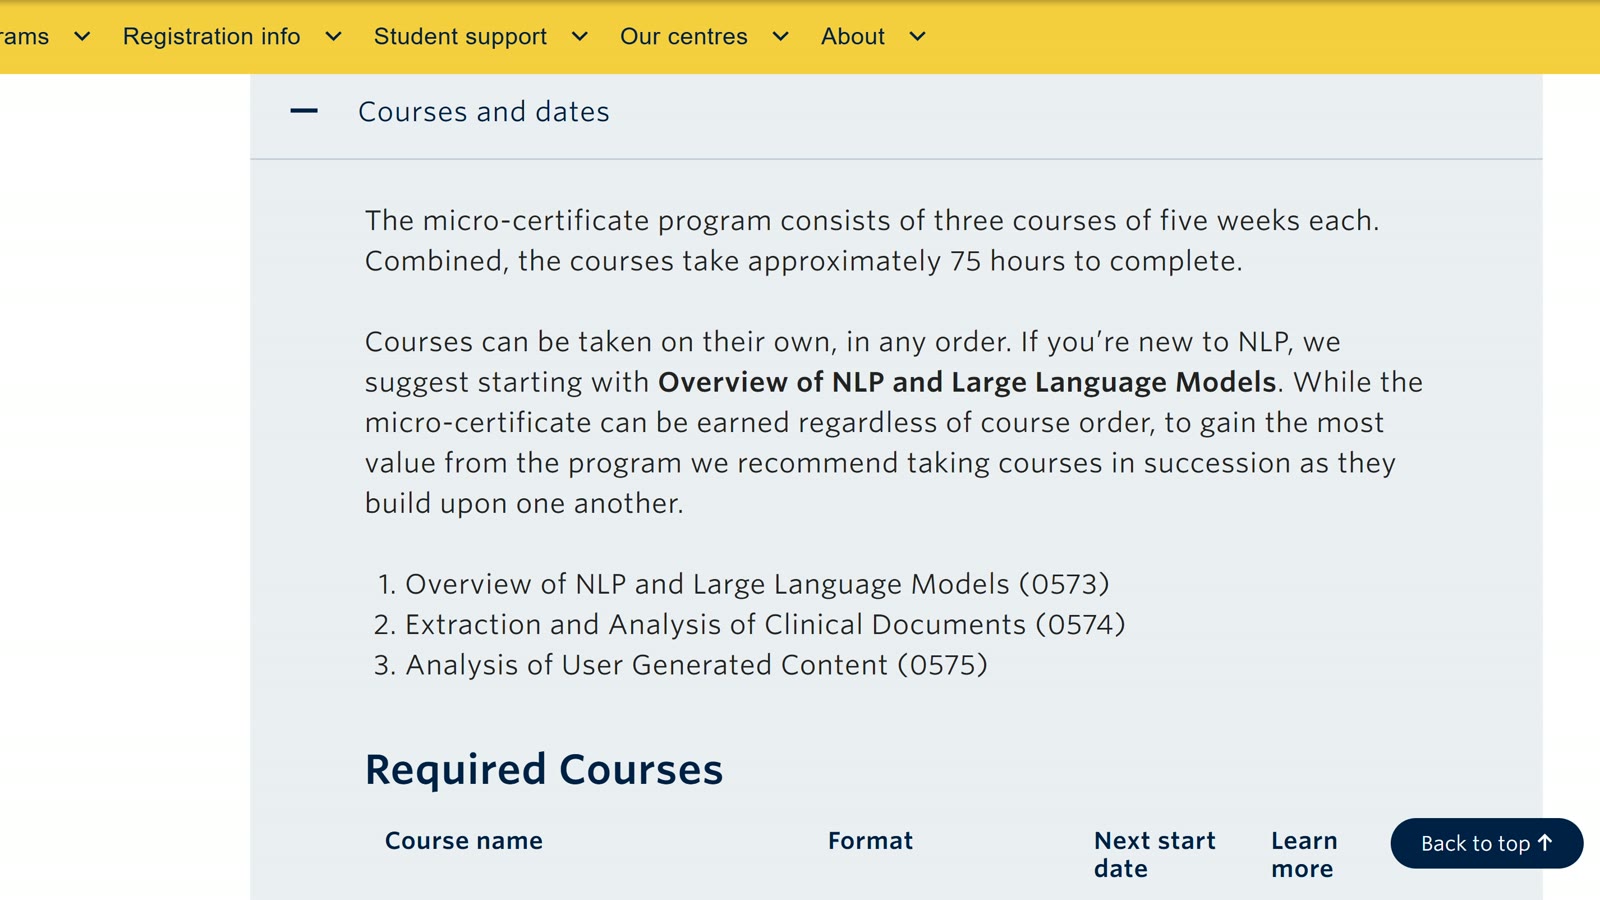
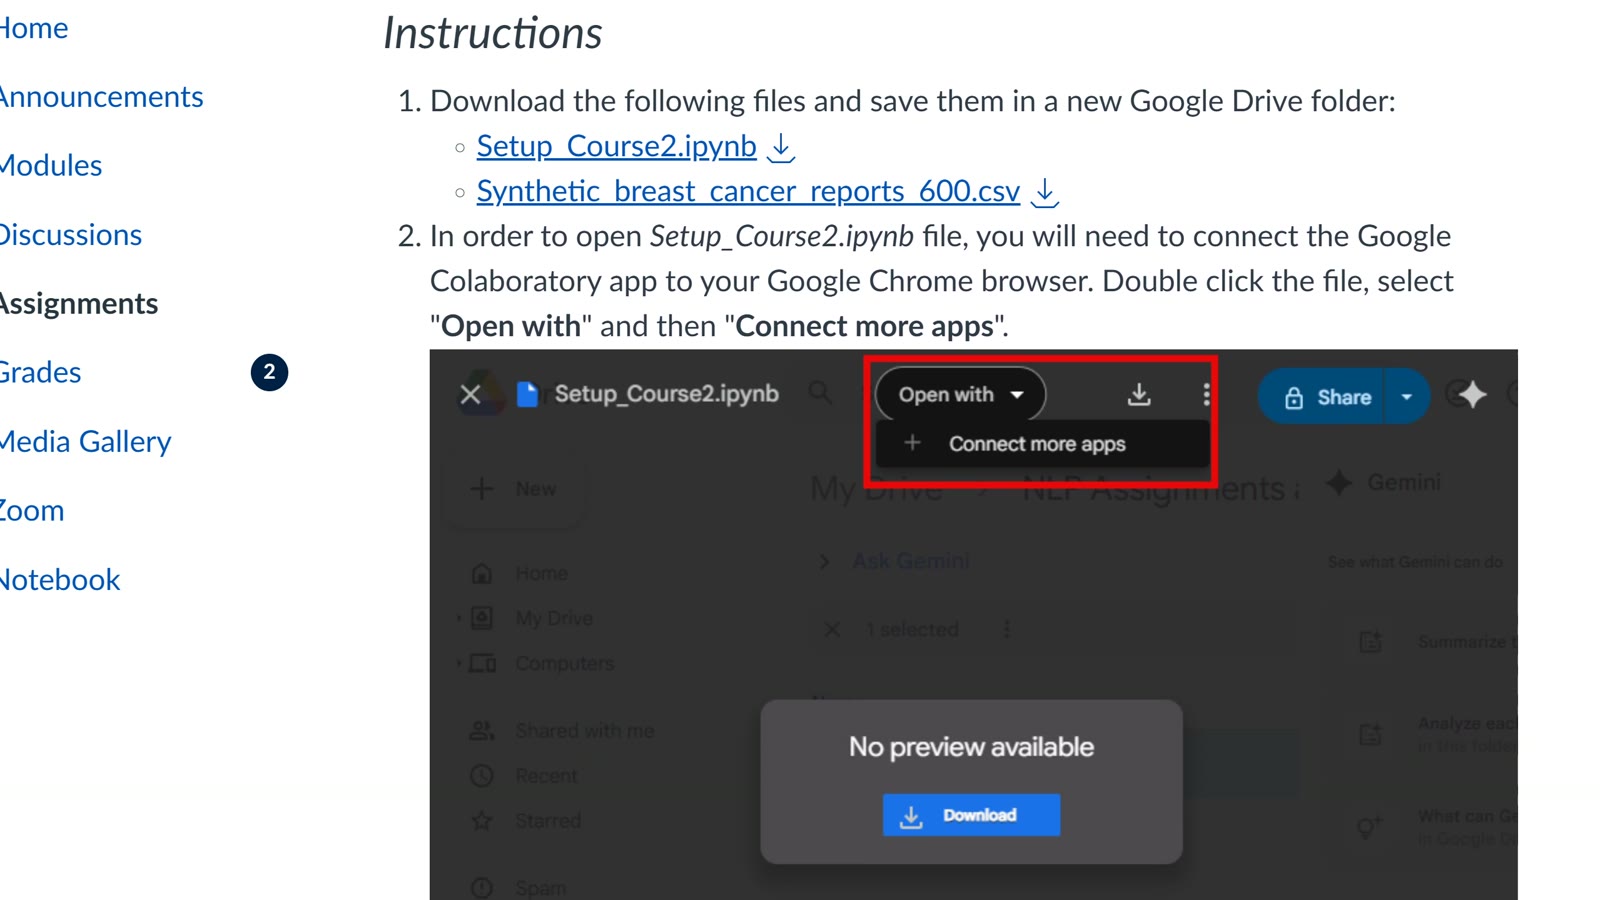
和第一门课一样,它完全在线。在每周截止日期之前按自己的节奏学习,每周大约五到七个小时。每个模块有简短的视频课、自测小测验(每个可以做两次)、动手实验和一次计分讨论。实验是在 Google Colab 里运行的 Python 笔记本,只需要一个 Google 账号和浏览器。
每周还有一次可选的一小时 Zoom 直播,由课程助教主持,可以提问,也有引导式的小组讨论。
谁来讲课
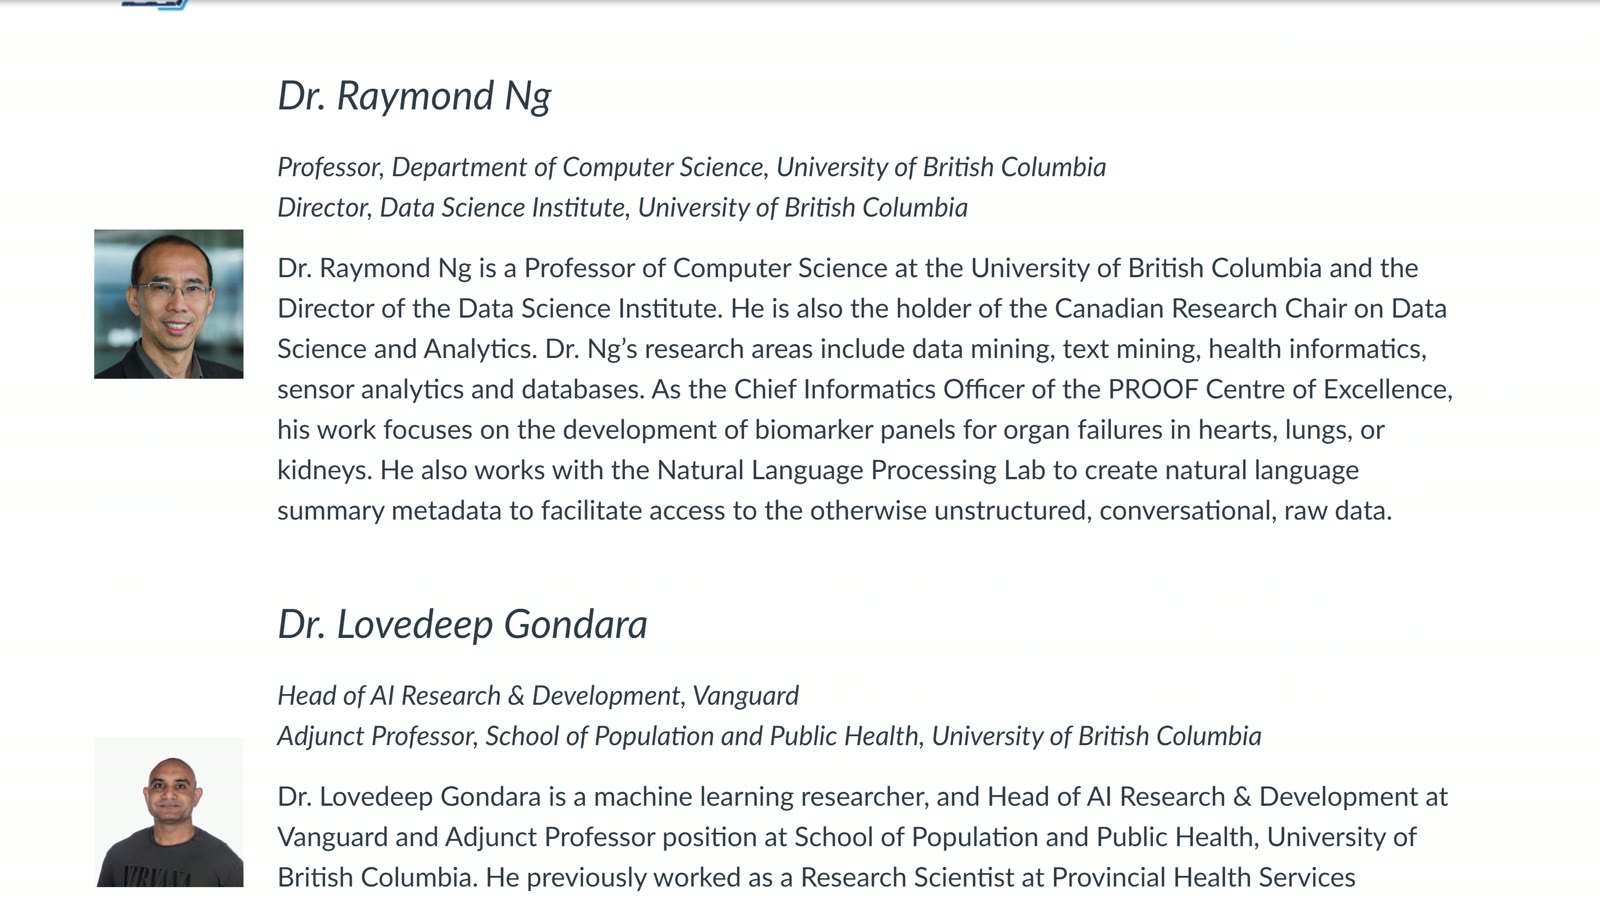
大部分课程由 Raymond Ng 讲授,他是计算机科学教授、UBC 数据科学研究所所长,研究方向包括数据挖掘、文本挖掘和健康信息学。模块一里,和他一起讲课的还有研究医疗中语言模型及其应用的 Lovedeep Gondara,以及温哥华沿海卫生局(Vancouver Coastal Health)的数据科学家 Saffrin Granby。所以这些案例来自在 BC 省医疗体系里真正做过这些工具的人。
四个模块
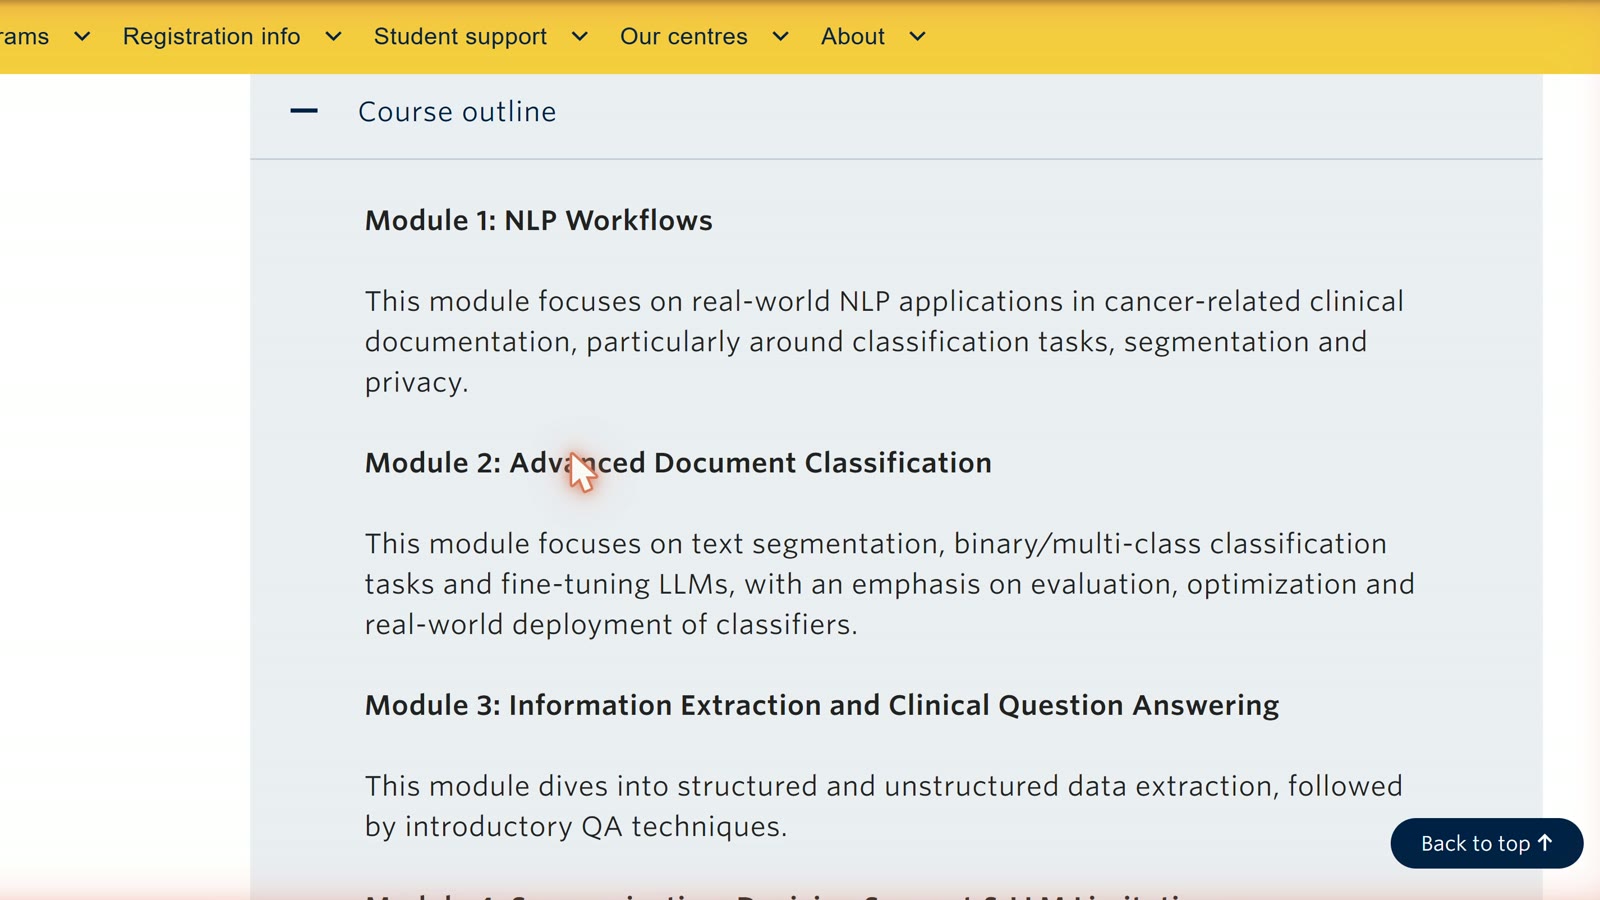
课程从真实项目开始,再逐个讲主要任务:
| 模块 | 内容 |
|---|---|
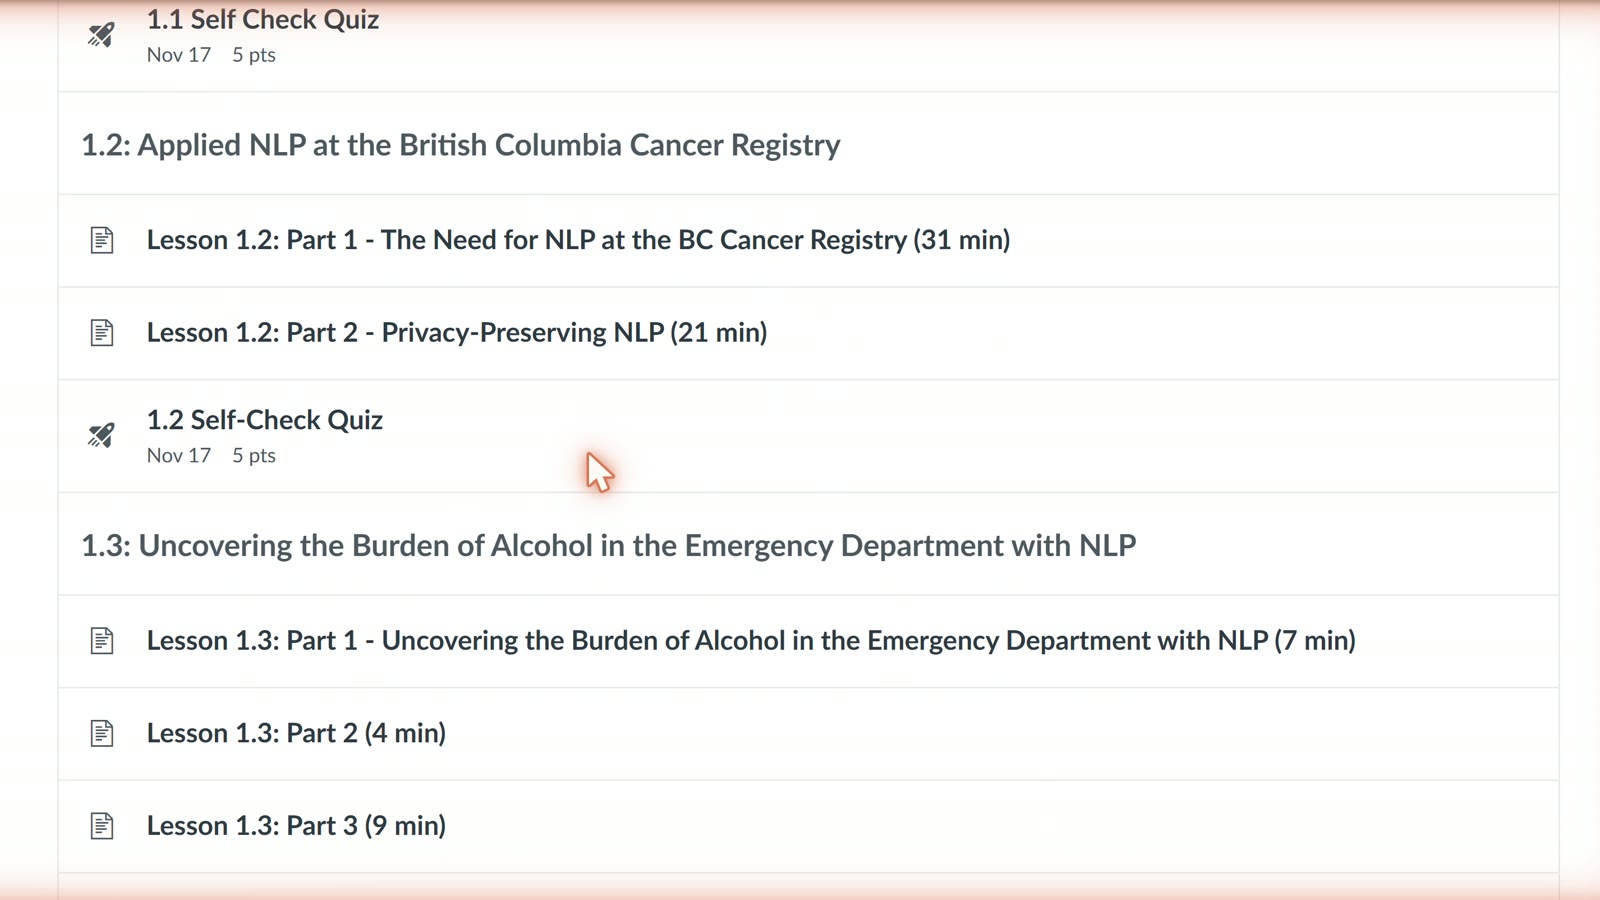
| 1. NLP 应用案例与工作流程 | BC 癌症登记处、保护隐私的 NLP、急诊科里的酒精负担、电动滑板车受伤、出院障碍,以及没有标注数据时怎样用 NLP |
| 2. 进阶文档分类 | 把报告切分成段落、筛选癌症登记处需要哪些病理报告、把它们分到诊断组、集成方法与大语言模型微调 |
| 3. 信息提取与临床问答 | 从报告中提取关注的字段,以及用大语言模型做问答 |
| 4. 摘要、决策支持与总结 | 临床文档摘要、AI 病历书写助手、患者的就医历程,以及这些模型在临床中的局限 |
我学到哪了,以及第一印象
我现在还在起步阶段:学完了模块一,在 Colab 里配好了实验环境,发了第一次讨论帖,现在正在学分类。
到目前为止,这门课分享的都是贴近实际的真实案例。实验做起来比较容易,但这些案例让我整体认识到 NLP 在医疗中是怎样应用的,而且更贴近现实。
接下来的笔记和视频
接下来在学这门课的过程中,我会把每个模块整理成网站上的笔记,每篇配一个视频,就像第一门课那样。
链接
- Extraction and Analysis of Clinical Documents:UBC Extended Learning 上的课程页面。
- Natural Language Processing to Improve Patient Care:微证书项目和它的三门课。
- YouTube 上这门课的视频。