
NLP 学习笔记 / NLP006
神经语言模型:从词向量到反向传播
上一期的简单语言模型靠数次数算概率。这一期换一种做法:不再存一张计数表,而是让一个神经网络去学习“下一个词是什么”。要看懂它,需要四个概念:神经网络、概率、词嵌入(embedding)和反向传播(backpropagation)。它们也是后面大语言模型(LLM)的基础,因为 LLM 本质上就是规模巨大的神经语言模型。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
词嵌入 embedding
把一个词写成一串数字,神经网络才能计算。语境相似的词,向量也相似;这些向量在训练中和权重一起学出来。
权重与偏置
每条连接带一个权重。神经元把每个输入乘以权重、加起来,再加上偏置:(0.2 × 10) + (−0.1 × 20) + 0 = 0。
激活函数
作用在加权和上的公式,决定传给下一层什么。ReLU 常用于隐藏层,Sigmoid 输出 0 到 1、适合二分类,Softmax 把最后一层变成下一个词的概率。
反向传播
猜错之后,把输出层的误差一层层往回传,算出每个权重对误差的责任,再逐个调整。误差越大,改得越多。
全景图:从词向量到反向传播
从左上角开始:三个绿色标题依次是语言模型的基本功能(根据前面的词,预测下一个词的概率分布)、词即向量,以及神经网络。紫色的部分是词嵌入的定义和这一期的四个核心概念,下面一行提醒:权重是核心,而且是从数据里学出来的。蓝色的小图和两个方框是神经元的结构:输入、加权求和加偏置、激活函数、输出,再叠加成输入层、隐藏层和输出层。中间红色的大框是训练循环:词嵌入经过一层层计算得到下一个词的概率,算出误差,再沿着弧形箭头反向传播回去,更新每一层的权重。左下角是三种激活函数,右下角是我的重点。
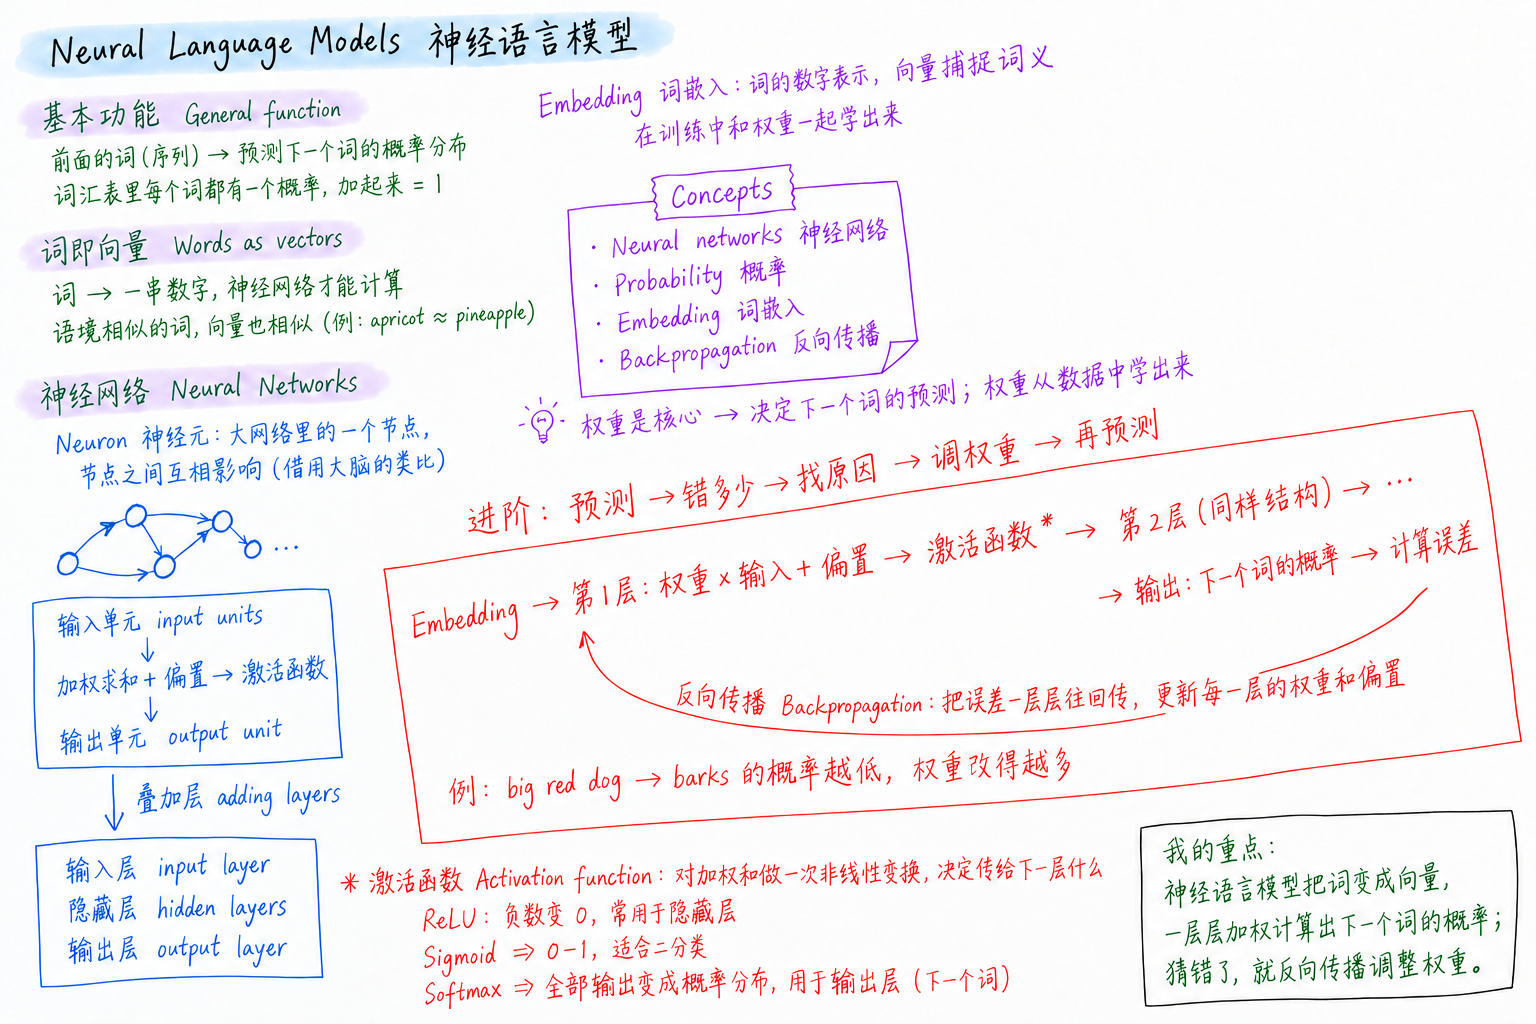
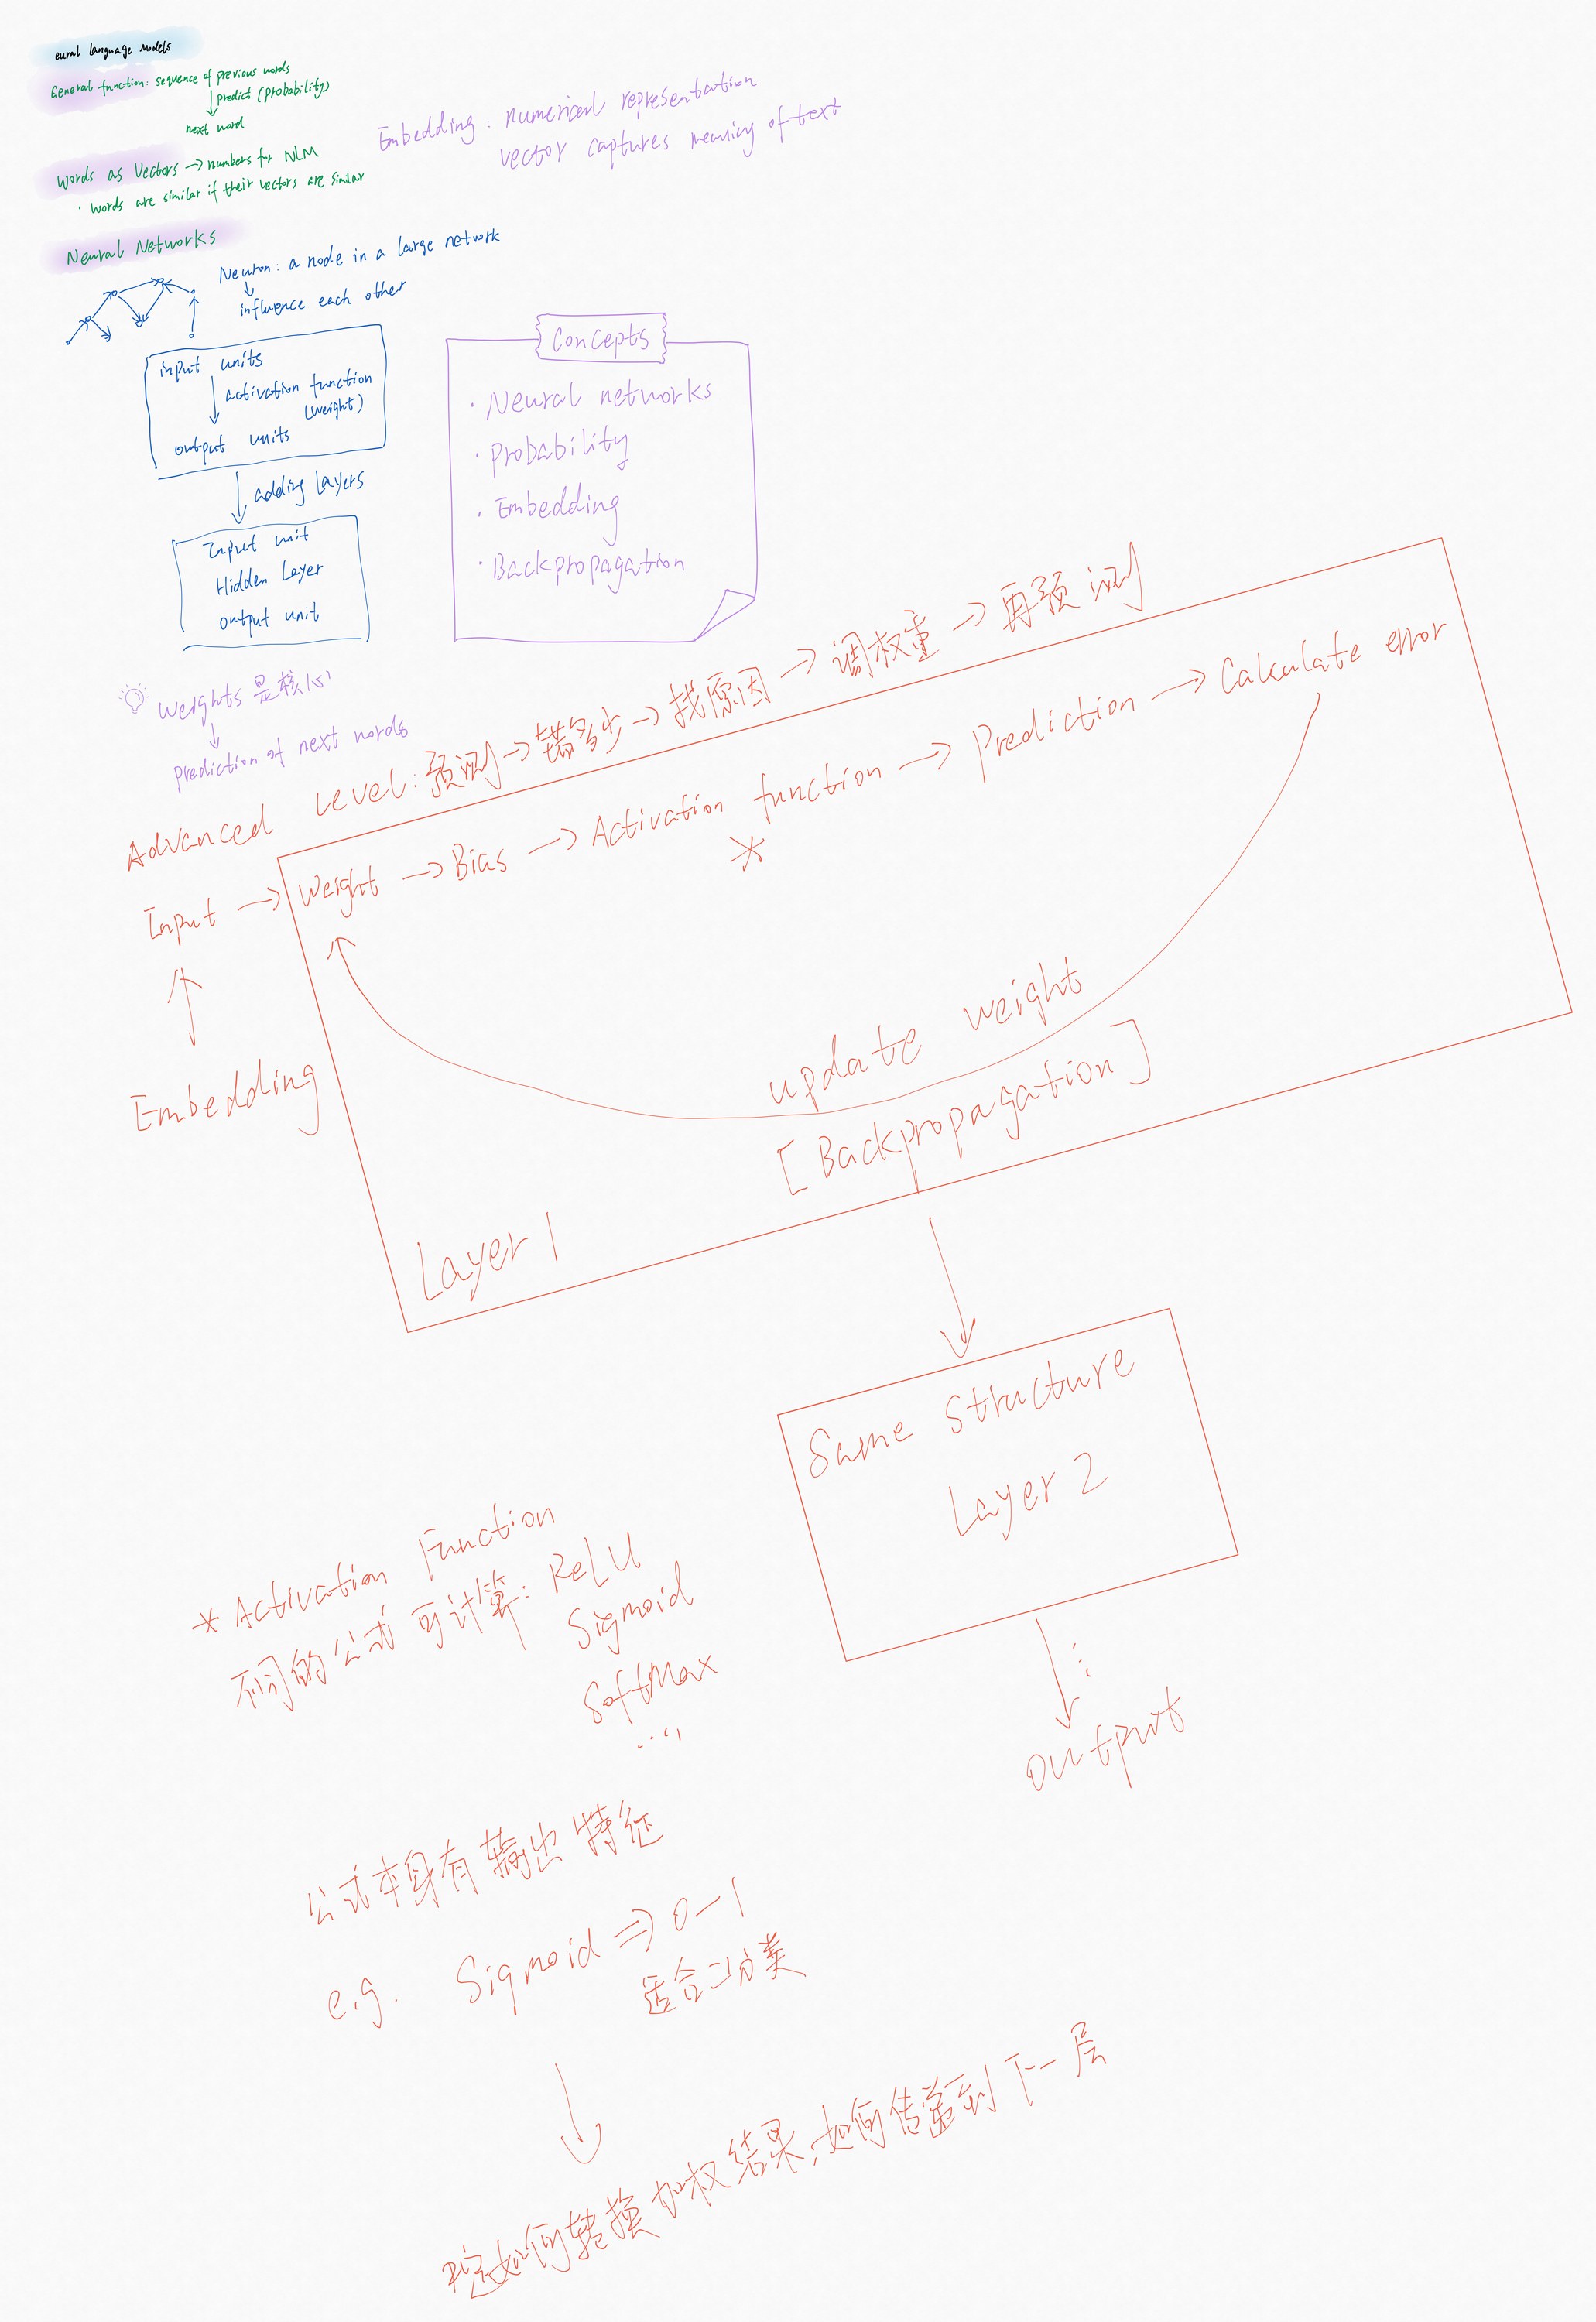
根据我的手写笔记整理,做了几处修正和补充。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
语言模型的基本功能
不管用什么方法实现,语言模型做的都是同一件事:给定前面的一串词,算出下一个词的概率分布。也就是说,词汇表里的每个词都会得到一个概率,所有概率加起来等于 1。
| 输入:“Next, we list some ___” | 下一个词的概率 |
|---|---|
| problems | 0.0014 |
| interesting | 0.0043 |
| the、cat | 接近 0 |
有了这个功能,语言模型就能完成两件事,和上一期的计数模型一样:
- 生成句子:给一个开头(在 LLM 里叫提示词,prompt),从概率分布里抽出一个词,接到句子后面,再算下一个词的分布,如此反复。
- 给句子打分:把每个词在前文条件下的概率相乘,就是整句话的概率。
区别在于概率从哪里来。计数模型查的是数出来的表;神经语言模型用一个神经网络把概率算出来。
词即向量:词嵌入
神经网络只会处理数字:输入是一串数字(向量),输出也是一串数字。所以要用神经网络做语言模型,先要把词变成向量。这些表示词的向量叫做词嵌入(embedding)。
用数字表示词,听上去很反直觉,其实在语言学里由来已久。维特根斯坦说过,一个词的意义在于它在语言中的用法。课程里的例子是 tesgüino:读到“一瓶 tesgüino 放在桌上”“喝 tesgüino 会醉”“tesgüino 是用玉米做的”,我们就能猜出它是一种像啤酒的酒。这就是分布式语义(distributional semantics)的直觉:一个词的向量,应该捕捉它通常出现在什么语境里。
| 方法 | 每个格子记什么 | 能比较什么 |
|---|---|---|
| 词–文档矩阵 | 某个词在某篇文档里出现几次,例如 battle 在《亨利五世》里出现 15 次 | 比较列,得到文档相似度;比较行,得到词的相似度 |
| 词–词共现矩阵 | 某个词出现在另一个词前后 ±7 个词以内的次数,例如 data 出现在 information 附近 6 次 | 比较行:apricot 和 pineapple 的向量相近,digital 和 information 的向量相近 |
核心结论是:语境相似的词,向量也相似。衡量两个向量有多像,最常用的是余弦相似度。神经语言模型同样用向量表示词,但做法不同:它的词嵌入是短而稠密的向量,不是数出来的,而是在训练中和网络权重一起学出来的。
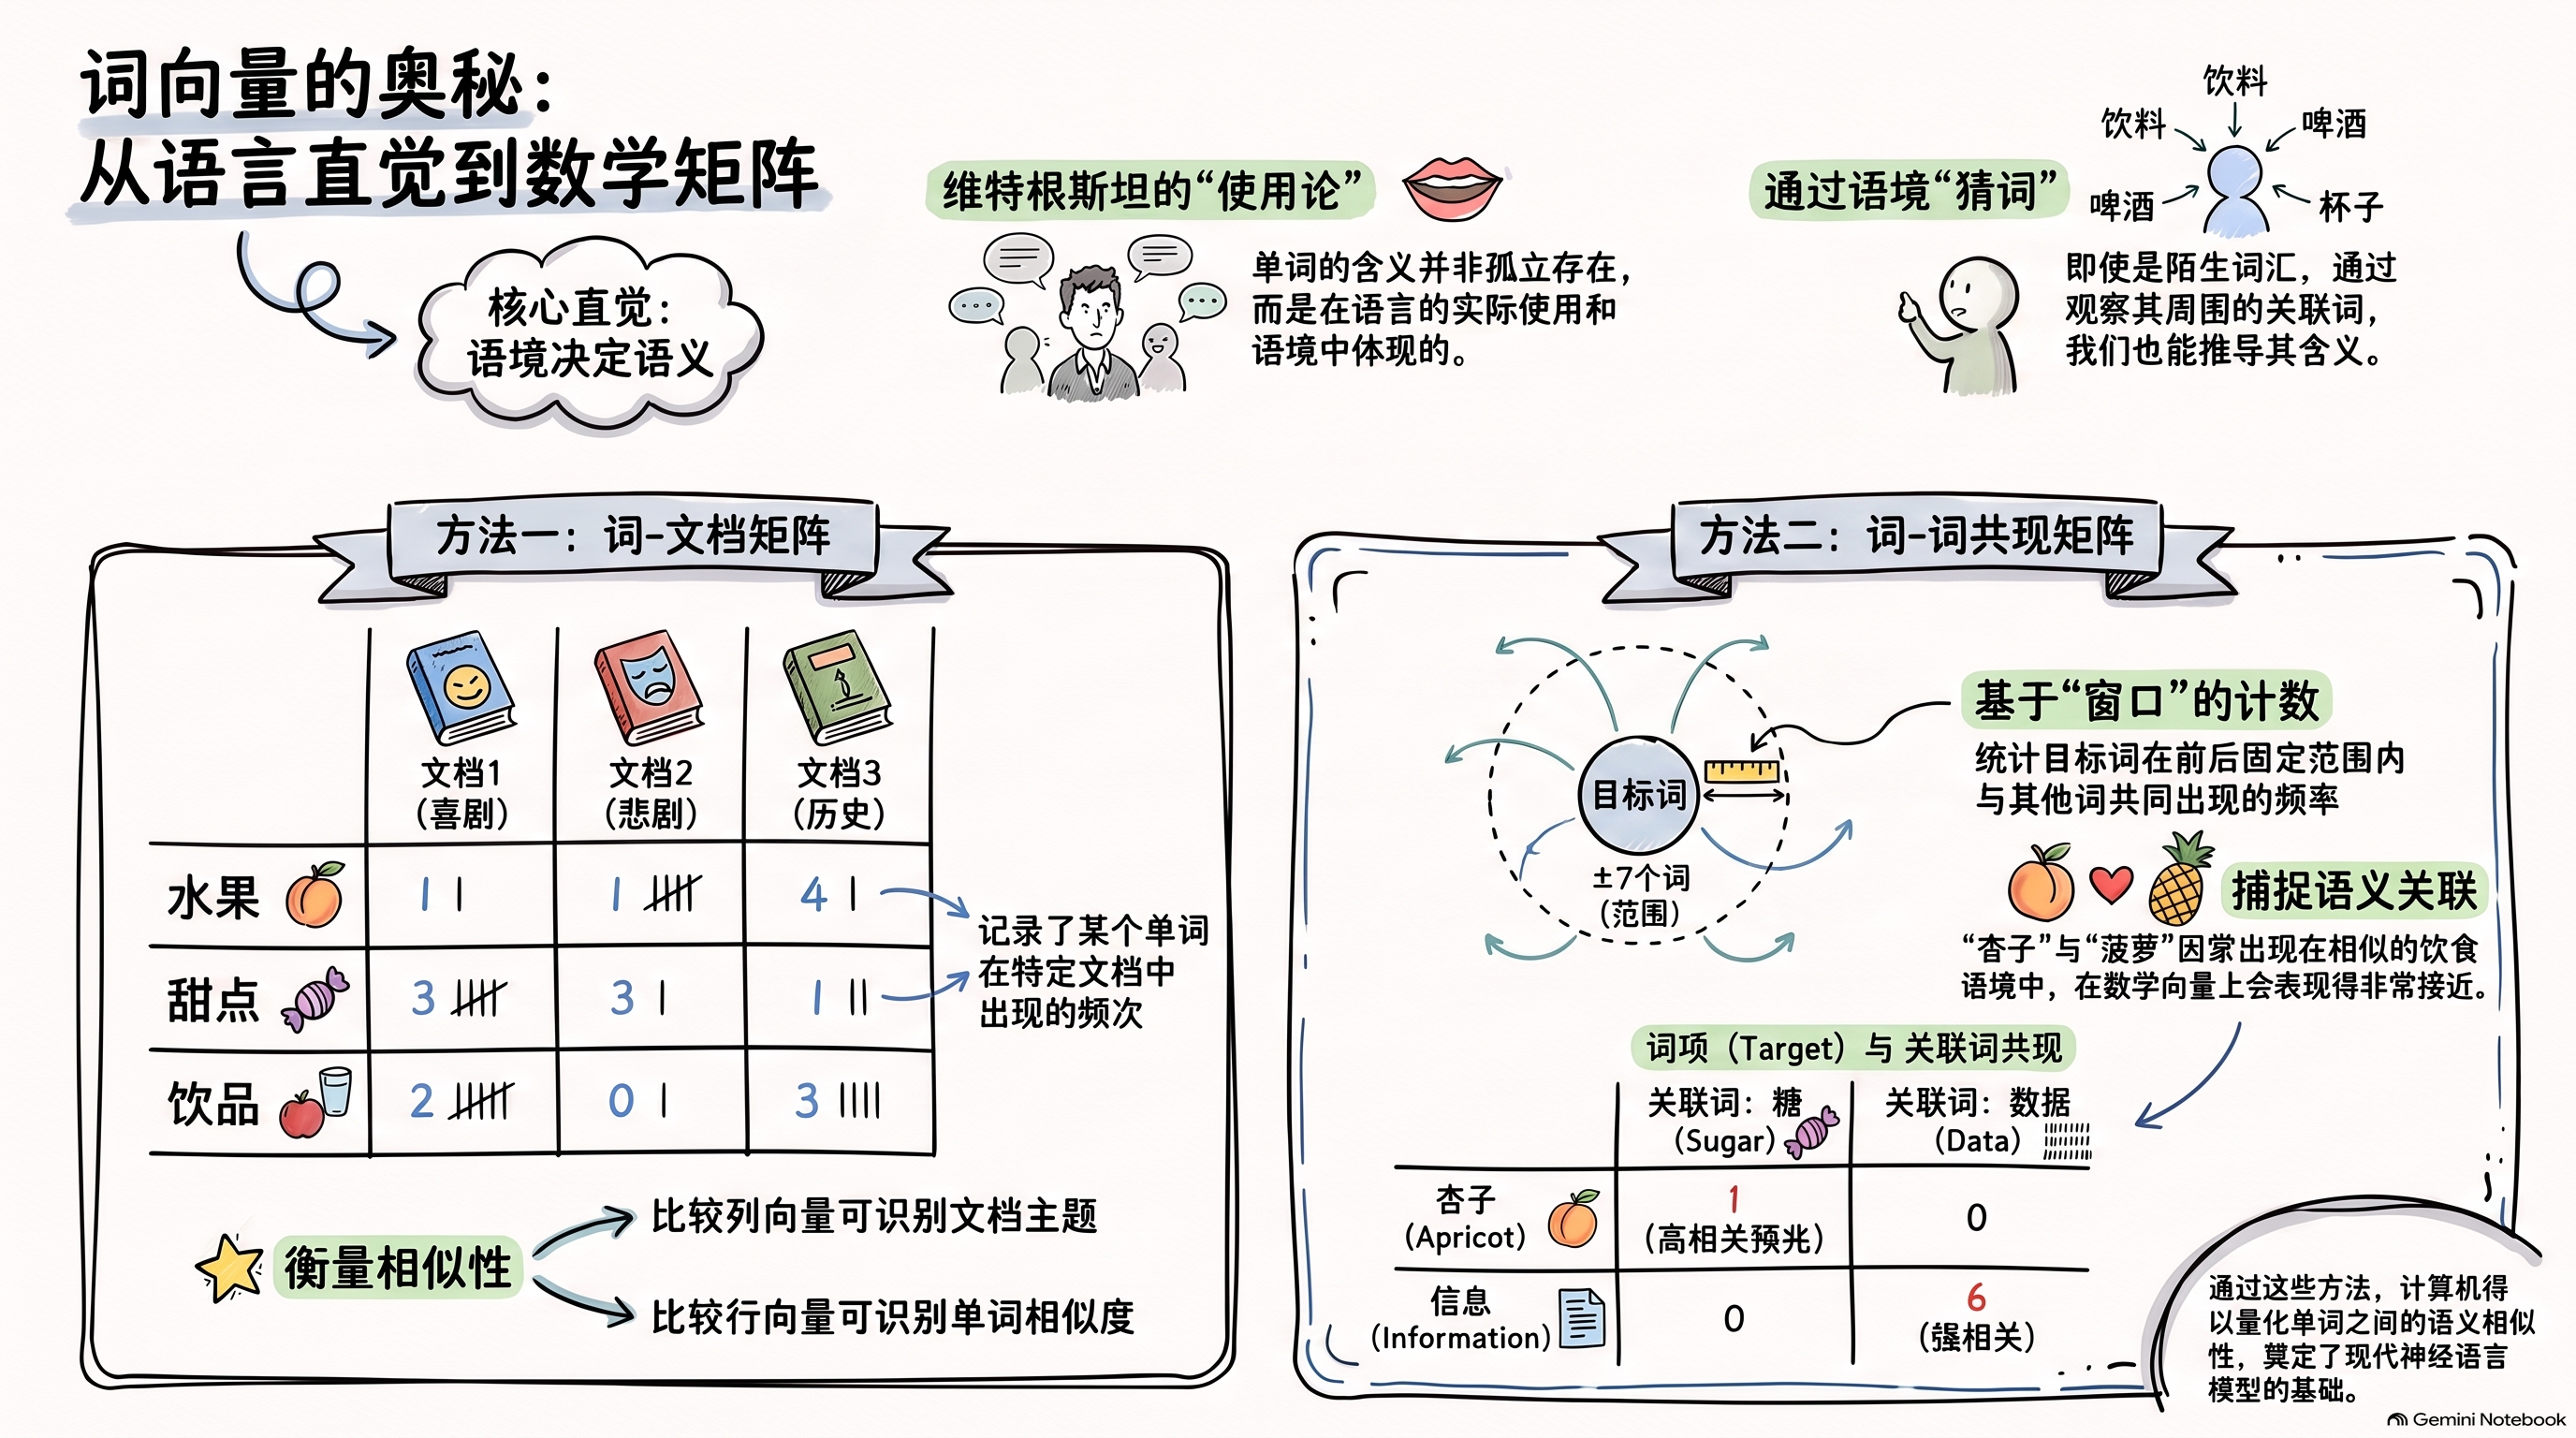
阅读提示:词–文档矩阵里阿拉伯数字和旁边的计数笔画对不上,只是示意。右下角“杏子 × 糖 = 1”并不代表“高相关”:1 只是 sugar 在 apricot 附近出现了一次。判断两个词是否相似,要比较整行向量,而不是看单个格子。
神经网络:神经元、权重与层
神经网络这个名字来自一个类比:大脑由神经元组成,每个神经元是大网络里的一个节点,神经元之间按照网络结构互相影响。人工神经网络借用了这个类比,并不是在模拟真实的大脑。
最基本的网络只有输入单元和输出单元,连接上带着权重。输出单元先算输入的加权和:
(0.2 × 10) + (−0.1 × 20) = 2 − 2 = 0
实际的神经元还会加上一个偏置(bias),再把结果交给激活函数:
输出 = 激活函数(权重 × 输入 之和 + 偏置)
课程里的垃圾邮件例子有五个输入单元,都是邮件的特征:发件人是否认识、标题里有没有 win、正文有没有 free、有没有个人称呼、正文多少个词。加权求和、经过激活函数后得到 0.8,可以理解为“这封邮件有 80% 的可能是垃圾邮件”。
要做更复杂的判断,就叠加层:在输入层和输出层之间加入隐藏层。这看起来复杂,其实只是同一个基本结构重复了很多次,每个节点都用上一层所有相连节点的加权和来计算。预测时一层一层往前算,直到输出层,这叫前向计算。
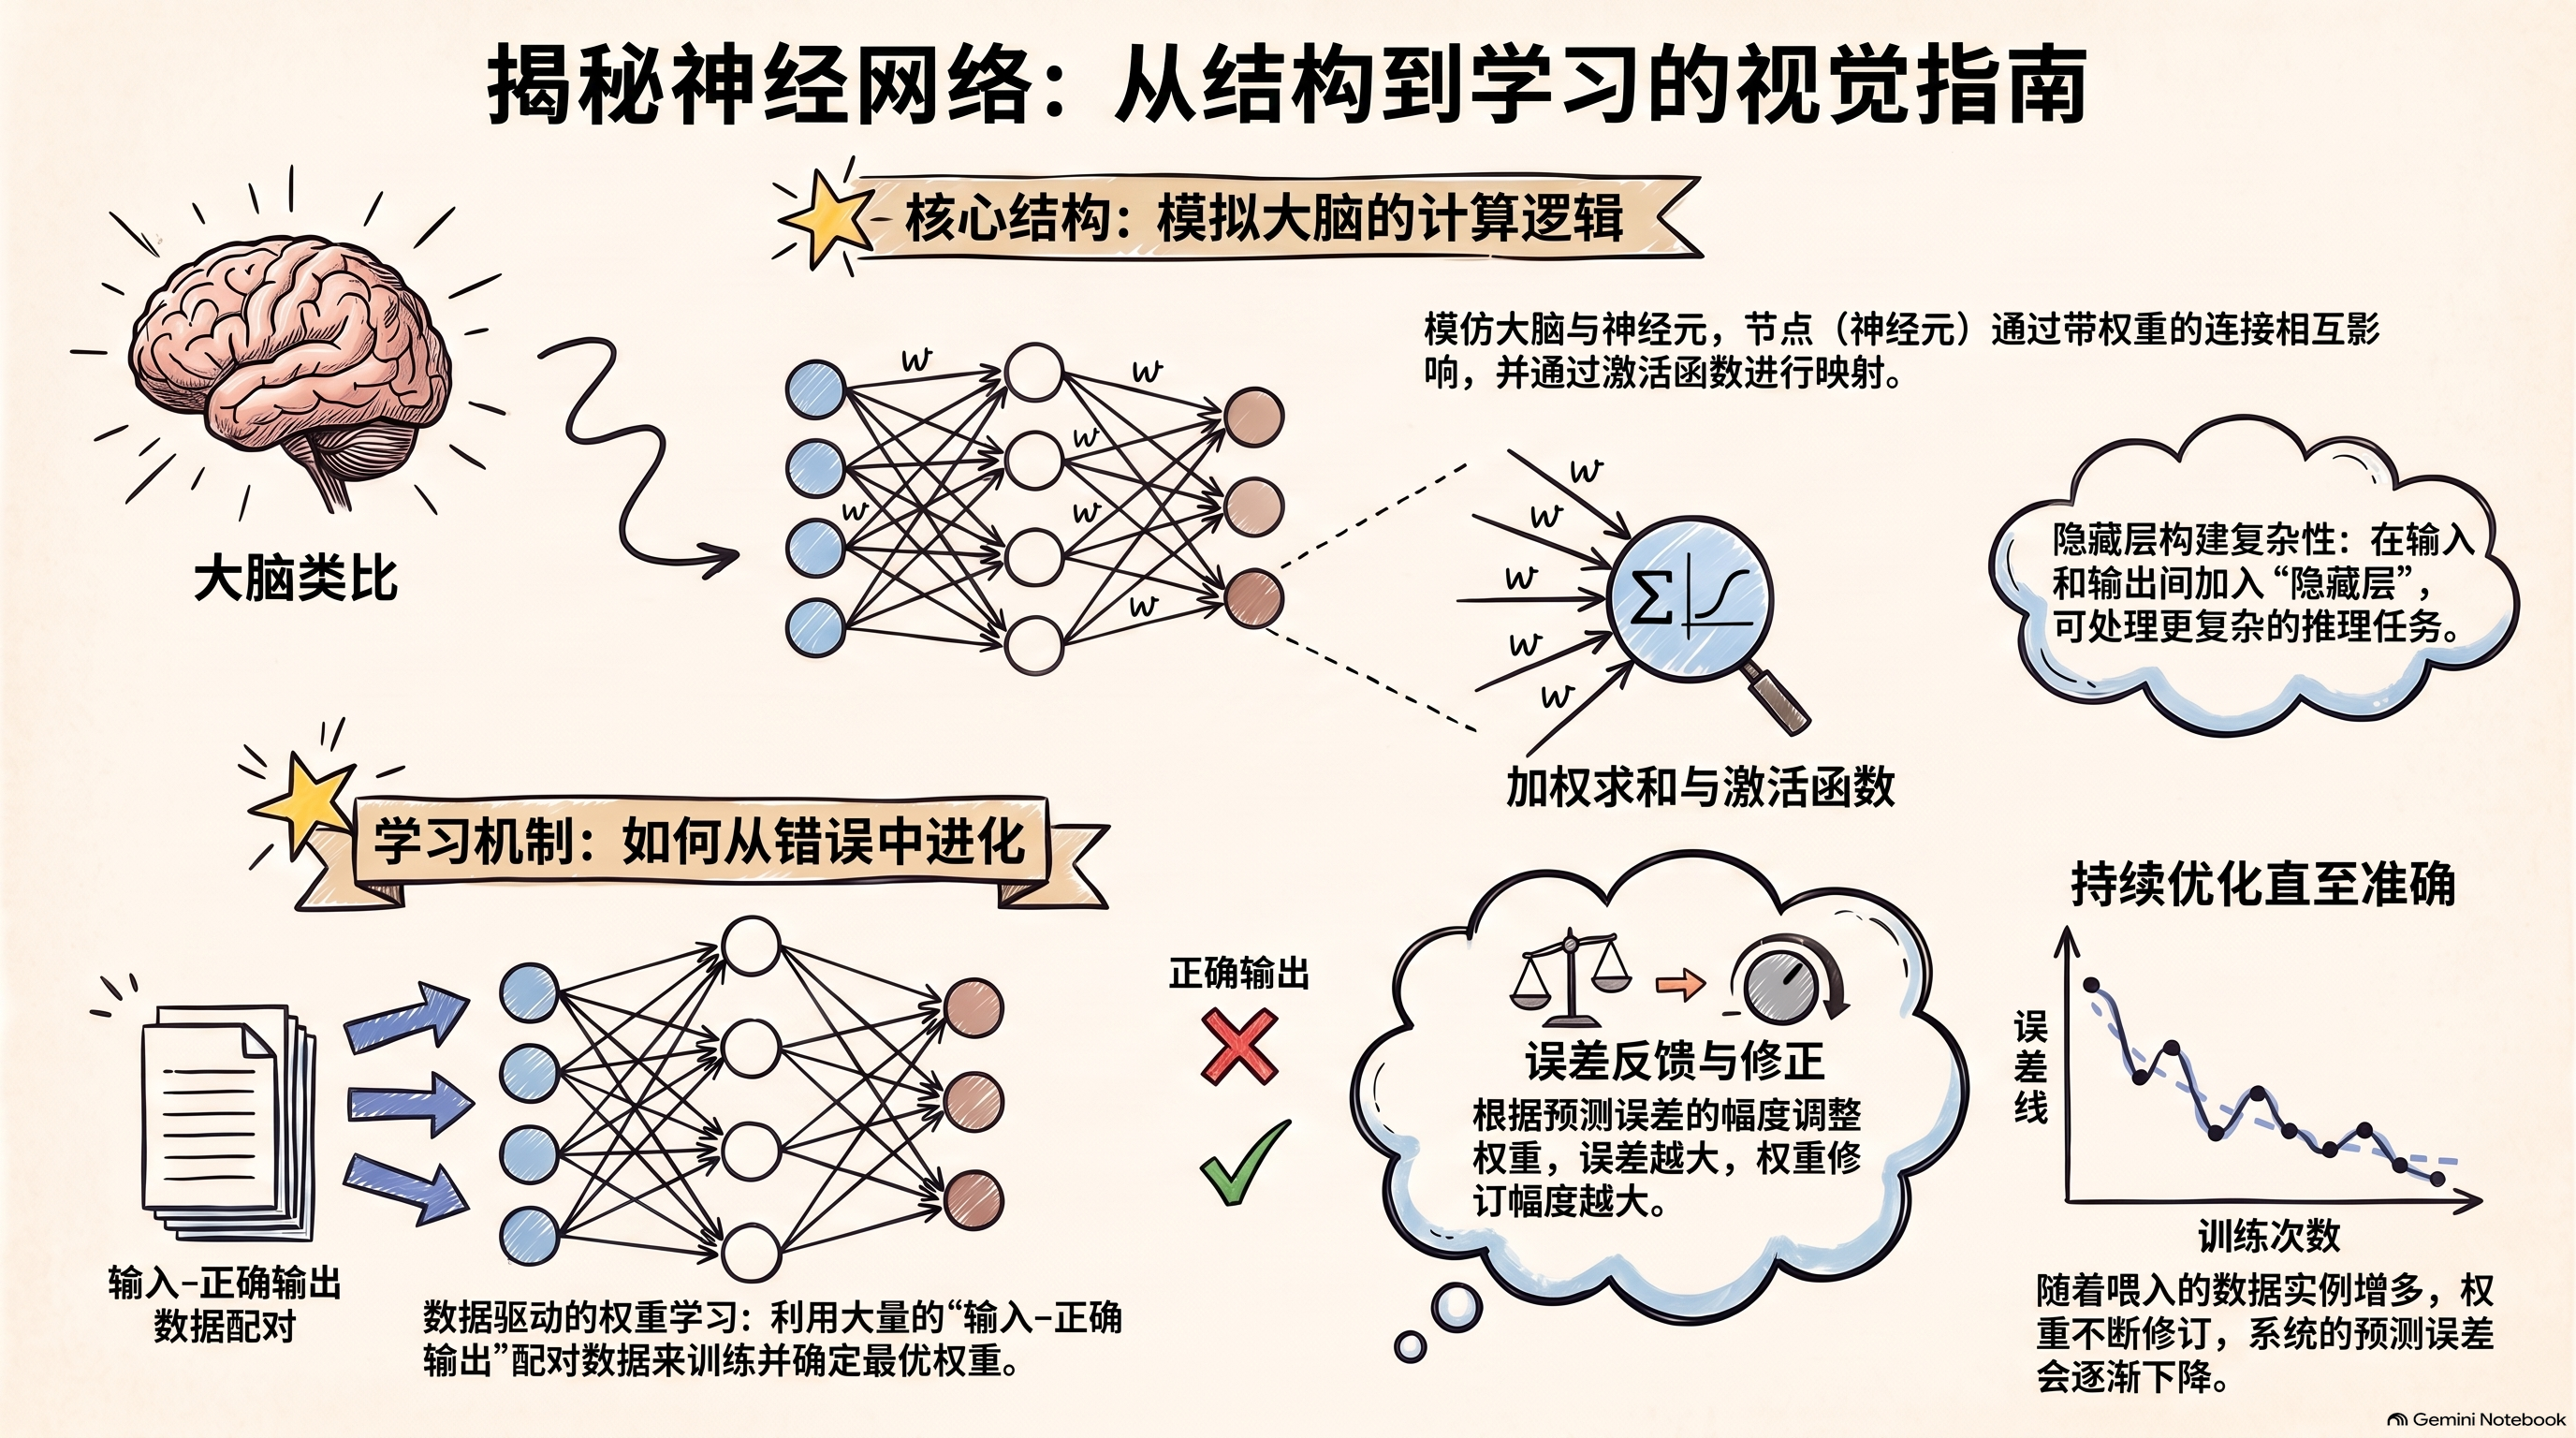
阅读提示:“模拟大脑的计算逻辑”应理解为借用大脑的类比,人工神经元只是一个简单的数学单元。右下角纵轴标为“误差线”,应为“误差”。
激活函数:决定传给下一层什么
激活函数是一个数学公式,作用在加权和上。它带来了非线性:如果没有它,叠加再多层,整个网络也只相当于一次加权求和。不同的公式输出范围不同,所以用在不同的位置:
| 激活函数 | 做什么 | 常见位置 |
|---|---|---|
| ReLU | 负数变成 0,正数保持不变:max(z, 0) | 隐藏层 |
| tanh | 压缩到 −1 到 1 之间 | 隐藏层 |
| Sigmoid | 压缩到 0 到 1 之间 | 二分类的输出,例如“是不是垃圾邮件” |
| Softmax | 把一整组分数变成加起来为 1 的概率分布 | 多分类的输出层,例如“下一个词是哪个” |
所以,激活函数决定了加权的结果怎样转换、怎样传递到下一层。神经语言模型的最后一层用 Softmax:词汇表里有几万个词,就输出几万个概率,这正是语言模型需要的“下一个词的概率分布”。SLP3,第 6 章
学习:猜错了,反向传播
权重不是人定的,而是从数据里学出来的。训练数据是大量“输入–正确输出”的配对,网络一次看一个例子:
- 预测:前向计算,得到输出。
- 计算误差:和正确答案比,差了多少。
- 找原因:反向传播把误差从输出层一层层往回传,算出每个权重和偏置对这个误差负多少责任。
- 调权重:按各自的责任修改权重,误差越大,改得越多(这一步叫梯度下降)。
- 再预测:换下一个例子,重复。
课程里的旅游目的地例子:如果正确答案是“不喜欢”,网络输出 0.001,几乎没错,权重基本不用改;如果输出 0.89,错得很多,权重就要大改。例子喂得越多,误差越低。
需要注意的是:误差只在输出层算一次,反向传播会经过所有层,每一层的权重都会更新,而不是每一层各自预测、各自纠错。SLP3,第 6 章
组装:神经语言模型
把以上几部分接起来,就是一个简单的神经语言模型:
- 输入:前三个词,各自换成词嵌入向量。
- 隐藏层:加权求和、加偏置、经过激活函数。
- 输出层:Softmax 给出词汇表里每个词作为下一个词的概率。
训练就是在大量文本上反复“预测下一个词”。以 “…the big red dog barks against the big pink dog…” 为例:输入 big red dog,正确的下一个词是 barks。barks 得到的概率越低,误差越大,反向传播改动的权重就越多。然后窗口往后挪一个词,用 red dog barks 去预测 against,以此类推。在整个网络规模的文本上这样训练,权重就会越来越可靠。词嵌入也是这样学出来的:它们和权重一起被更新。
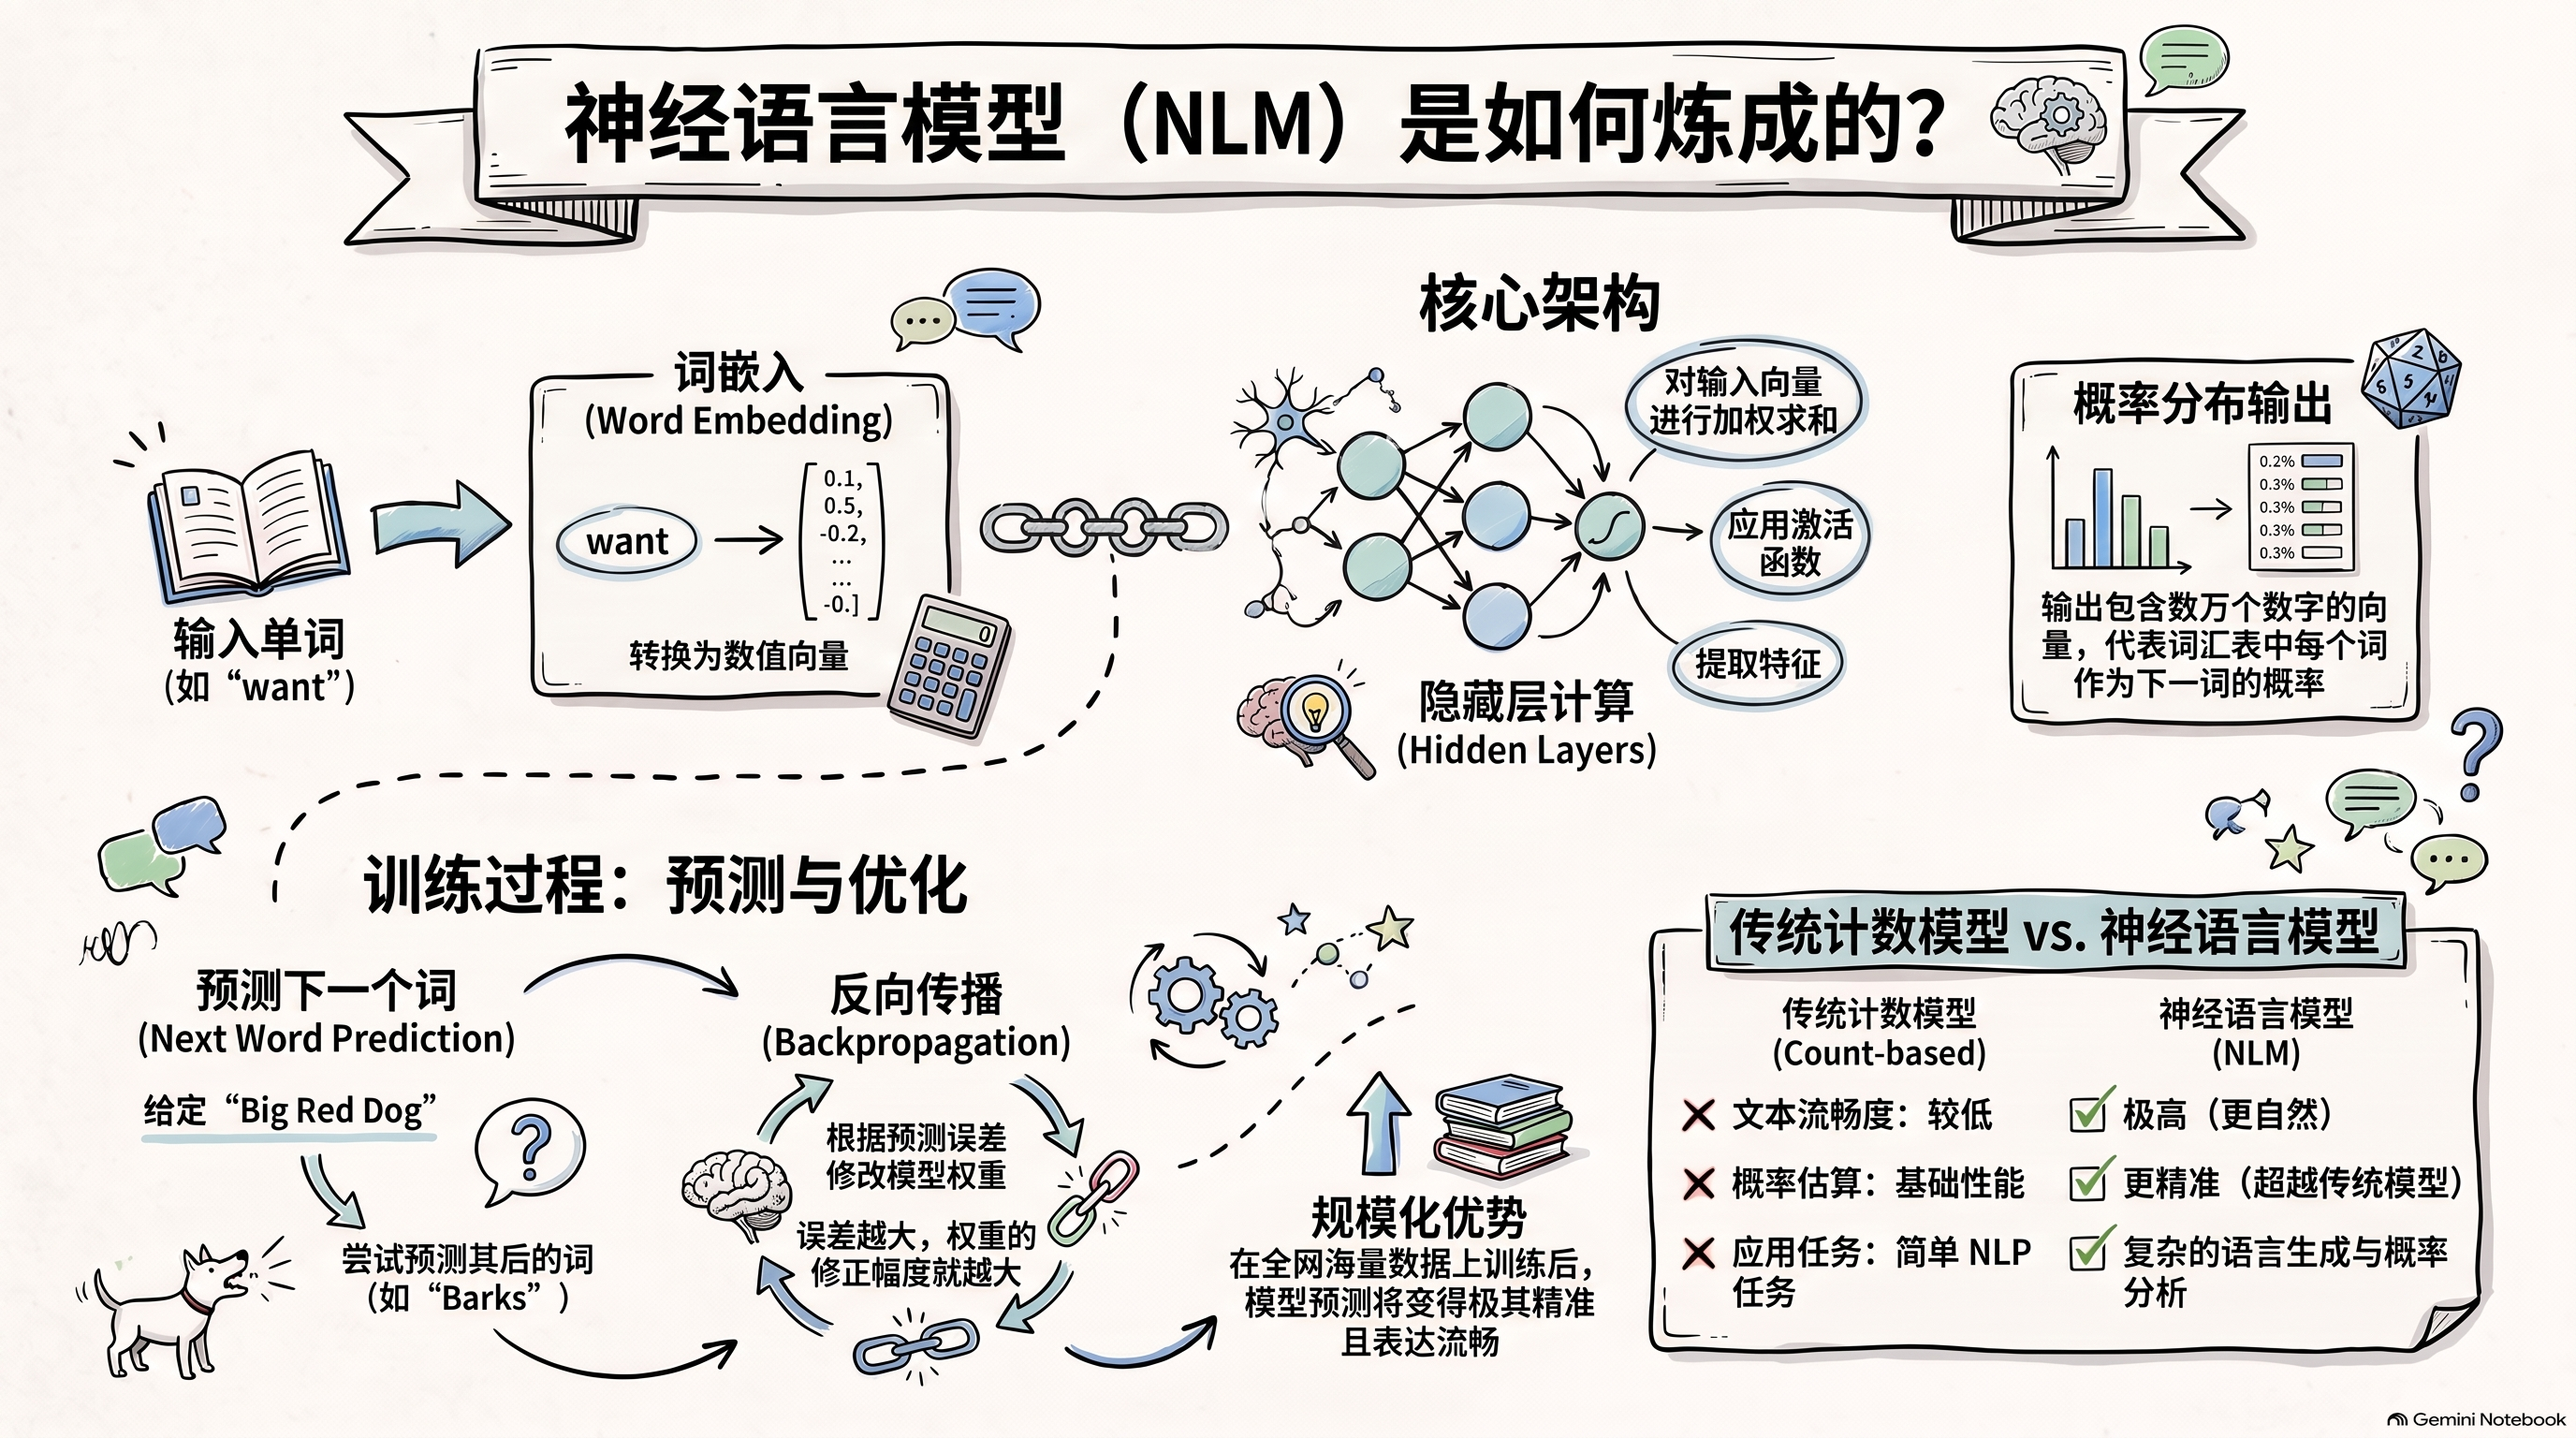
阅读提示:“在全网海量数据上训练后,模型预测将变得极其精准”指的是比计数模型更准,并不是不会出错。
| 计数模型(上一期) | 神经语言模型 | |
|---|---|---|
| 概率从哪里来 | 数次数再相除 | 神经网络算出来 |
| 词的表示 | 词本身(一个符号) | 学出来的词嵌入向量 |
| 没见过的词组 | 概率为零,需要平滑 | 相似的词向量相近,可以类推 |
| 生成和打分的表现 | 基础 | 即使结构简单,也更好 |
| 代价 | 快、透明、容易解释 | 训练更慢、更耗能,也更难解释 |
“可以类推”是什么意思?假设训练时见过 “make sure that the cat gets fed”,却从没见过 dog 后面接 gets fed。计数模型在 “the dog gets” 之后不会预测 fed;神经语言模型知道 cat 和 dog 的词嵌入相近,就能预测出 fed。SLP3,第 6 章
下一期的大语言模型,就是在这个基础上把模型和数据都放大很多倍。
我的思考
这期需要掌握四个概念:什么是神经网络;再次强调的概率;什么是词嵌入;什么是反向传播。神经语言模型想要完成的,是根据前面的一个或几个词,按照概率预测下一个词。
为了方便电脑计算,需要把单词转成向量。词嵌入就是这个过程:它是词的数字表示,向量捕捉了文本的含义。这也意味着,如果两个词相似,它们的向量也相似。
神经网络借用了大脑神经网络的类比。神经元是网络里的一个点,神经元之间会互相影响,也可以理解为它们之间可能有关系。构建这个网络,先有输入单元,然后通过激活函数(一个数学公式,不同的目的可以选不同的公式)得到下一个输出单元;这个步骤可以重复多层,最后得到结果。所以在这个网络里,每个神经元连接上的权重,会影响下一个词的预测结果。
在建立模型的过程中,会不断矫正:先预测,看看错了多少,找到原因,调整权重,再预测。这里就用到了反向传播。
学习来源与资源
本期内容来自我在英属哥伦比亚大学(UBC)微证书项目“Natural Language Processing to Improve Patient Care”中“Overview of NLP and Large Language Models”课程的学习笔记(Giuseppe Carenini 讲授的 Neural Language Models 一讲)。技术细节核对了 Jurafsky 和 Martin 的 Speech and Language Processing(第 3 版草稿,2026 年 8 月):第 5 章 Embeddings 和 第 6 章 Neural Networks。
自己动手试试
- TensorFlow Playground:在浏览器里搭一个小神经网络,增减隐藏层、切换 ReLU、tanh、Sigmoid,看训练时误差怎样一步步下降。
- GeeksforGeeks:Activation Functions in Neural Networks:上文只举了三个例子,这个页面列出了更多激活函数(线性、tanh、Leaky ReLU、ELU 等),每个都配有公式和曲线图。
- Embedding Projector:在三维空间里浏览真实的词向量,搜索一个词,看看离它最近的是哪些词。