
UBC · 临床文档的提取与分析 · 模块一第一课 / NLP009
医疗 NLP 能用在哪里?临床文档、患者的声音与癌症就医历程
医疗系统里有海量的非结构化文本,可是医疗领域的机器学习大多仍在用结构化数据,比如电子健康档案(EHR)和保险数据。UBC 课程“临床文档的提取与分析”(Extraction and Analysis of Clinical Documents)第一课讲的就是:为什么值得在医疗中用自然语言处理(NLP)——文本从哪里来、哪些 NLP 任务重要、其他语言和语音怎么办,以及一位癌症患者的报告在计算机眼里是什么样子。这篇笔记是我对这节概览课的整理。
- 章节
- 关键概念
- 阅读提示
 ELLE · 阅读向导
把概念连起来,再往下读
和 Elle 一起理清基础概念
点开概念理清区别,再试三道小题;选错后可以重新选择。
临床文档与 UGC
临床文档(病理、影像、手术报告)由医护人员撰写:正式、密集、满是术语。用户生成内容(博客、短信、论坛帖子)由患者和家属撰写:写法多样、往往主观,满是他们的经历和需求。
关注字段
一项任务需要从报告里拿到的信息,比如有没有癌、类型、分级、大小和位置。NLP 自动把它们抽取出来,填进结构化表格或 EHR。
否定
报告提到一个表现,可能是为了排除它:“无淋巴血管侵犯”。“无”可能紧挨在词前,也可能在几句之后(“没有证据表明”),所以找到这个词不等于患者有这个表现。
孤立的文档
每份报告都是为下一步的局部决策而写,很少和其他报告按时间串起来,所以患者跨越多年的完整病史从来没有被拼起来。
全景图:NLP 能拿医疗文本做什么
从左上角的 NLP 任务四大类开始,再往下看多语言问题:大多数工具是用英文文本做出来的,处理其他语言有两条路。左下是一段癌症就医历程:诊断、治疗、缓解后随访,疑似复发时由弯箭头回到诊断,每一步都会产生报告。右边红色部分是问题所在:这些文档各自孤立、满是术语、要等稀缺的专家来读;下面的绿色一行是 NLP 能提供的帮助。底部的红色长句是我在实际工作中的观察,右下角是我的重点。
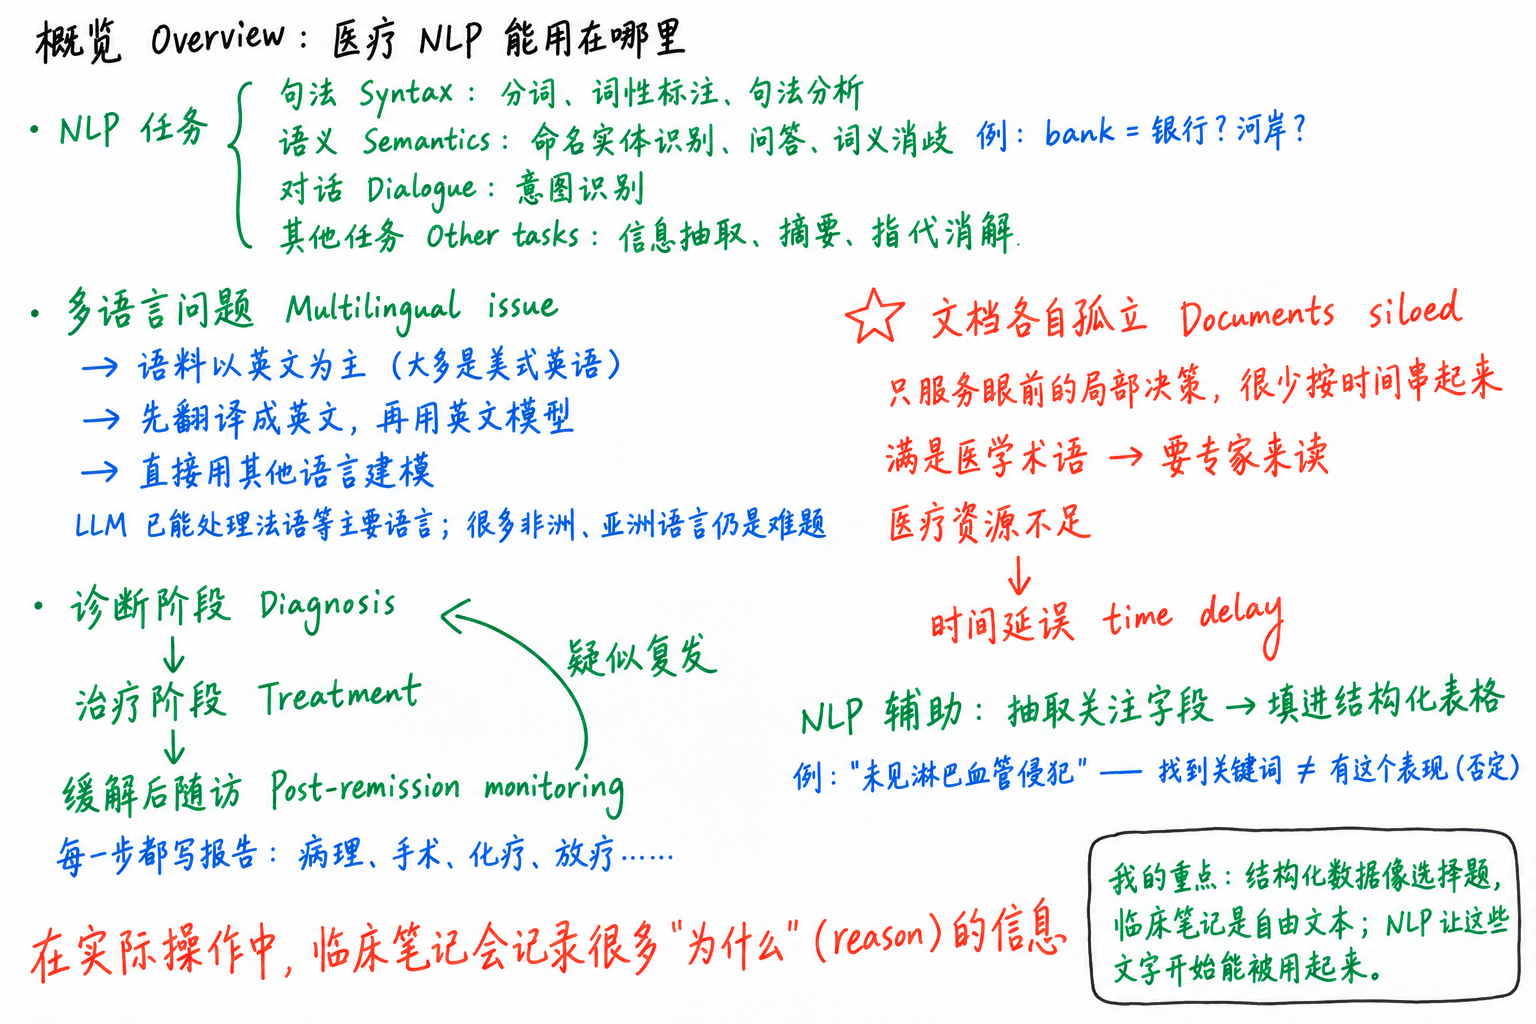
根据我的手写笔记整理,修正了几处表述,并补充了简短的例子。
点击图上的区域,跳到对应章节;点右上角的 ⤢ 放大 查看大图。
医疗文本的两种来源
课程把医疗中的非结构化文本分成两种来源,微证书项目各用一门课来讲:
| 临床文档 | 用户生成内容(UGC) | |
|---|---|---|
| 谁写的 | 医护人员 | 患者、家属等 |
| 例子 | 病理报告、影像报告、放射报告、手术报告 | 博客、论坛帖子、短信、邮件、聊天 |
| 特点 | 正式、密集、满是医学术语,很少有主观评论 | 作者背景多样、写法各异,常常不合语法,往往很主观 |
| 告诉我们什么 | 诊断、检查发现和治疗 | 看法、经历、需求、感受和情绪 |
| 在项目里 | 这门课(第二门) | 第三门课 |
主观不等于没有信息。课上的例子:到一个陌生城市旅行、想订餐厅时,大多数人会看网上的评价。我们都知道评价很主观,但一家 4.8 分、一家 3 分,还是能帮我们做选择。同样,患者怎样描述自己的经历,对照护患者也是有用的信息。
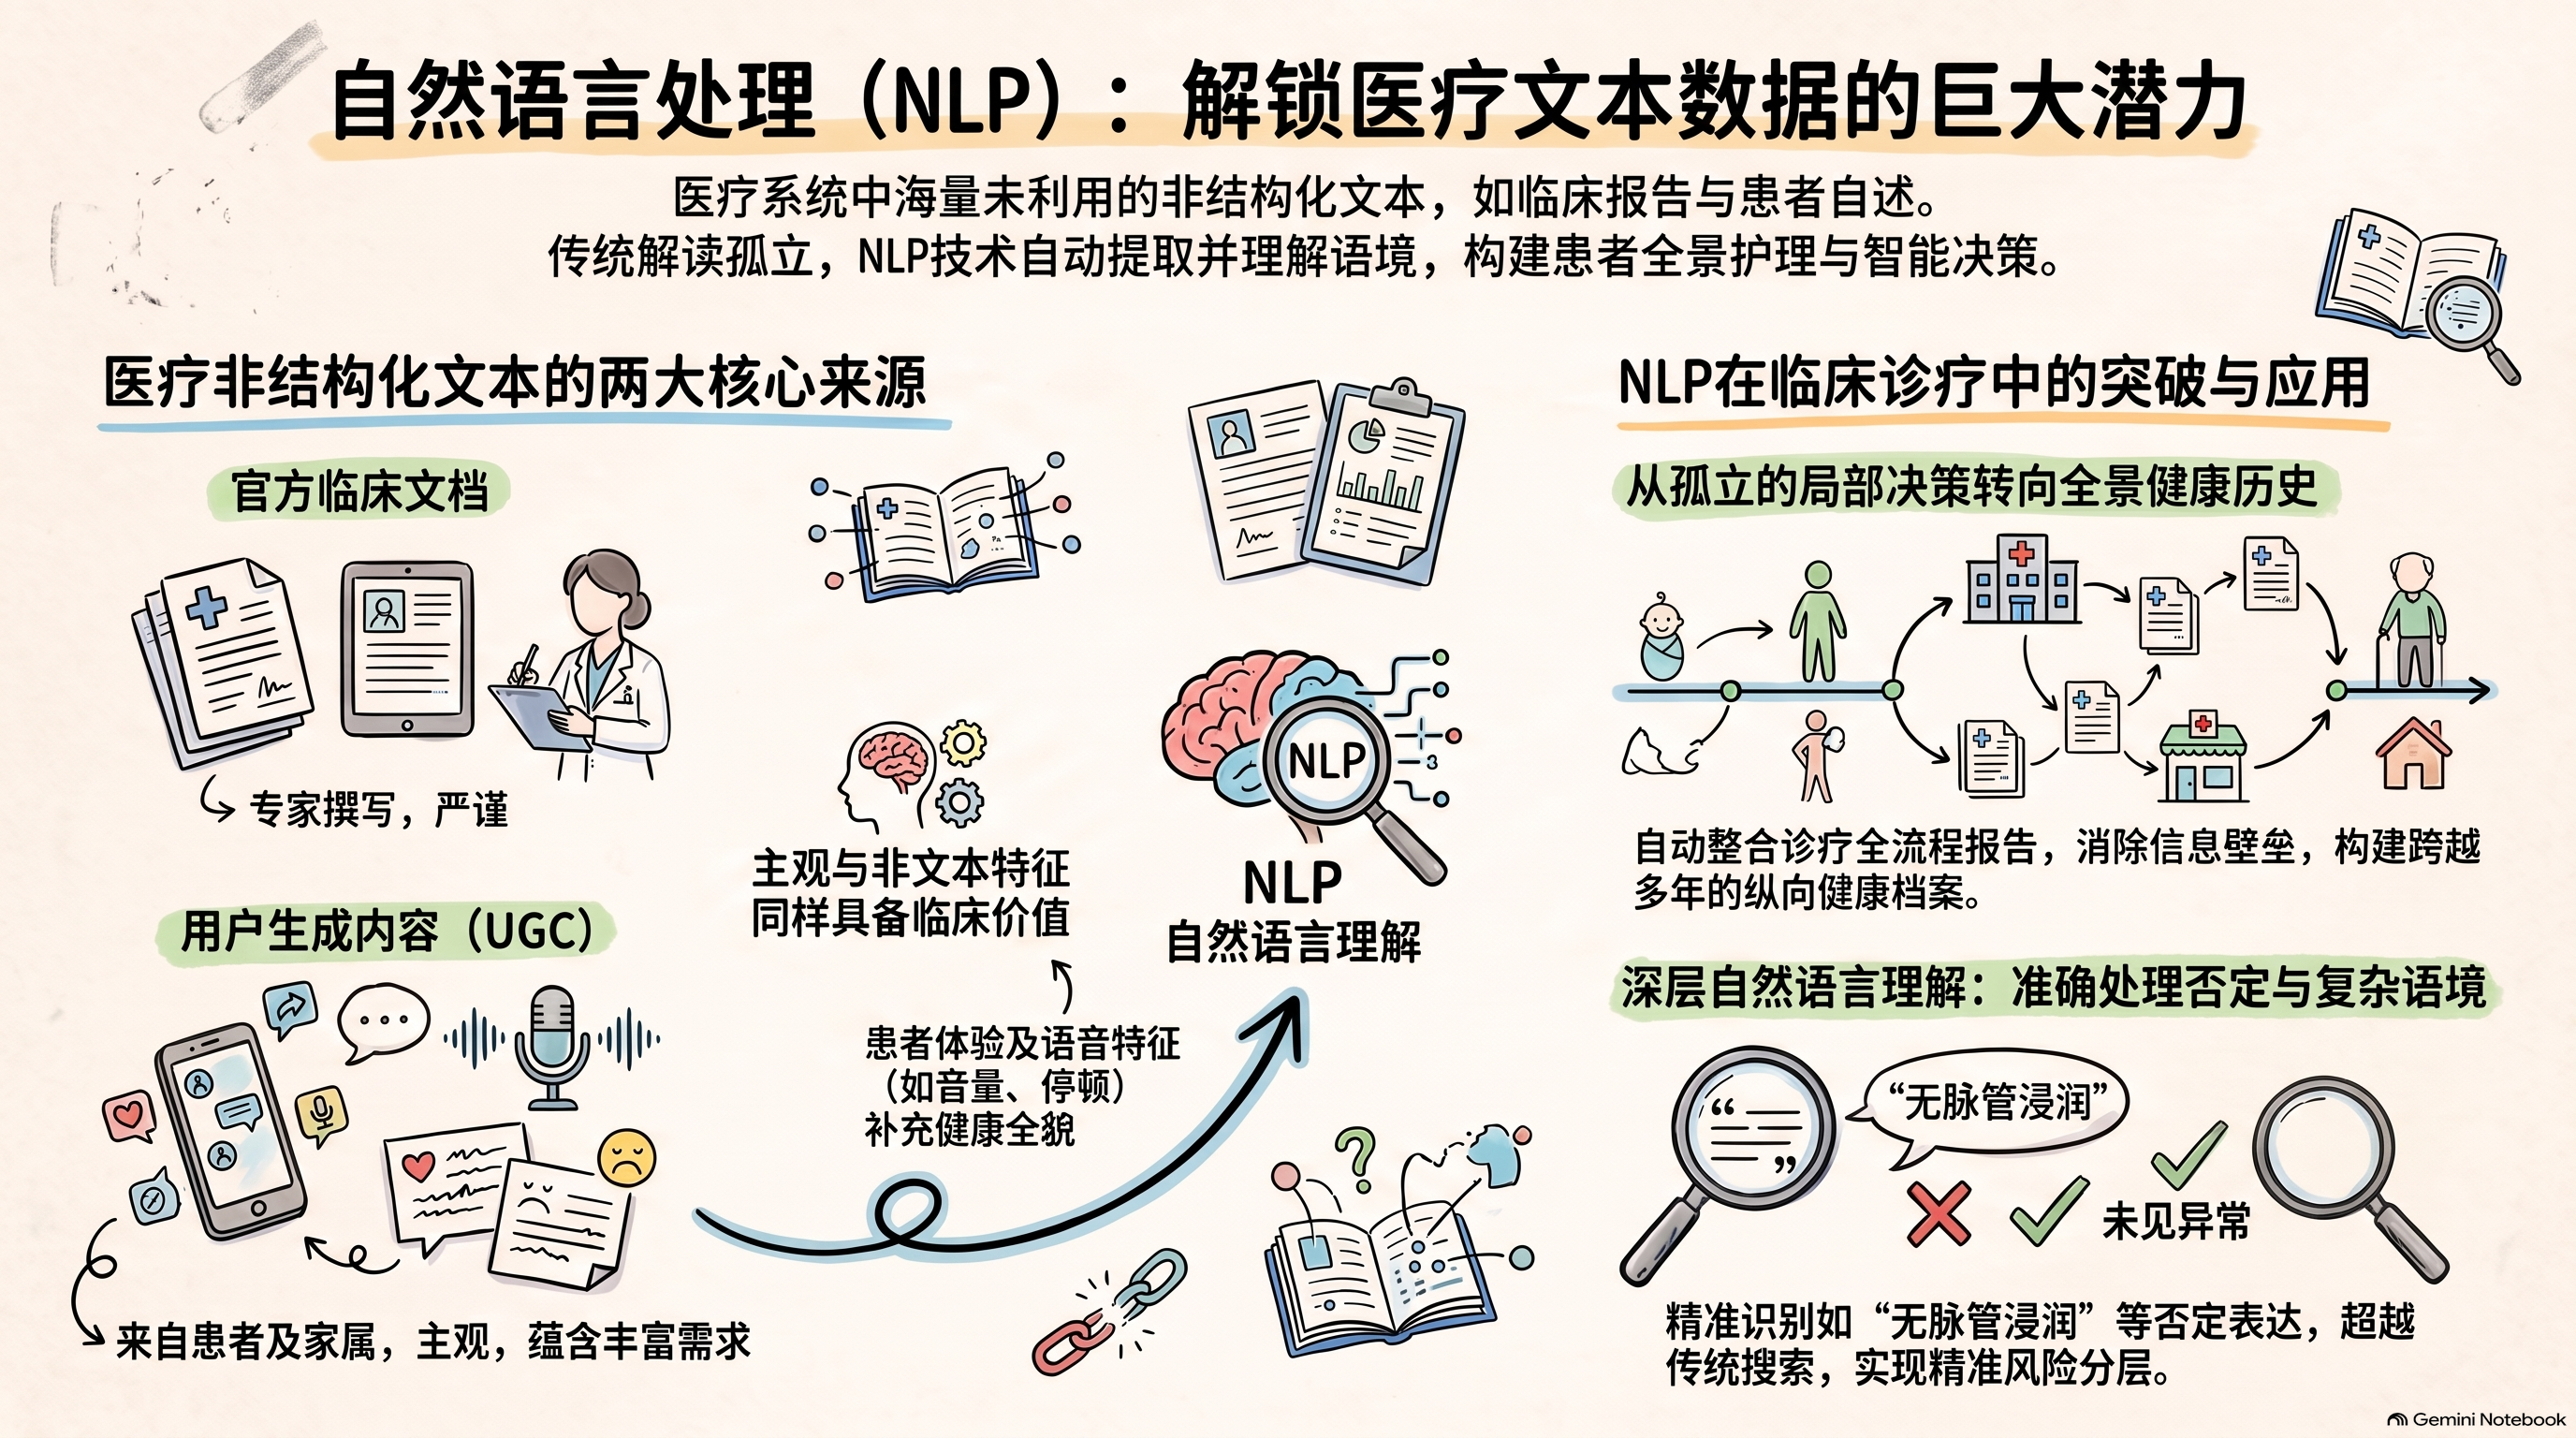
读图提示:图中把语音放在了 UGC 下面,但课上语音是单独讨论的,也包括给医生用的 AI 病历书写助手;另外,能识别否定只是做风险分层的前提之一,并不等于“实现精准风险分层”。
NLP 任务的四大类
NLP 里的“处理”(processing)包含很多事情。课上把任务分成四列:
| 类别 | 关注什么 | 例子 |
|---|---|---|
| 句法 Syntax | 与语法相关:怎样组成词、短语和句子 | 分词、词形还原与词干提取、词性标注、句法分析、词语切分、断句 |
| 语义 Semantics | 与语法无关:作者想表达什么意思、有什么意图 | 自然语言理解与生成、问答、机器翻译、命名实体识别(NER)、情感分析、话题切分、词义消歧 |
| 对话 Dialogue | 对话,以及写的人想要什么 | 开放领域对话与任务型对话、意图识别、分类 |
| 其他任务 Other tasks | 建立在前三类之上的更大任务 | 语言模型、摘要、信息检索与信息抽取、情绪识别、指代消解、语音 |
课上的两个例子。词义消歧:bank 可以是存钱的银行,也可以是河岸,要靠上下文判断。意图识别:患者发来一条消息,是在找信息,还是在表达害怕或沮丧?
这门课的重点任务是自然语言理解、问答、信息抽取和摘要;第三门课还会讲情感分析、话题切分、意图识别和情绪识别。句法类的几项任务在第一门课已经学过,见基础文本处理和分词、句子切分与贴标签。
其他语言和语音
NLP 大多以英文为主。 大部分 NLP 研究依靠的是英文文档集(语料库),而且主要是美式英语,很多由开发大语言模型的科技巨头挑选。但即使在加拿大,医疗系统里也有法语。处理另一种语言有两条路:
- 先翻译,再建模:机器翻译已经很好,可以把法语文档翻译成英文,再用现有的英文工具处理。
- 直接用这种语言建模:直接在法语文档上建模型。今天的大语言模型处理法语已经不成问题。
对法语、西班牙语、德语这样的主要西方语言,这个问题基本解决了;但对很多非洲、亚洲和中东的语言,多语言依然是难题。
语音是越来越多的数据来源:Siri、Alexa 这样的语音助手,以及现在给医生用的 AI 病历书写助手(AI scribe,这门课后面会讲)。最简单的做法是先把语音转写成文字,再用 NLP 分析。但语音里有文字丢掉的特征:音量和语速与情绪、心境有关——兴奋时说得快,累了说得慢,抑郁时可能变得很安静,连沉默本身都在传递信息。直接分析这些特征,能比只看转写稿了解得更深。不过这门课和第三门课处理的都是英文文本。
一段癌症就医历程:报告很多,连接很少
临床文档伴随患者走过整个就医过程。以癌症为例:
- 诊断阶段:出现症状后做各种检查,可能是活检,也可能是手术。每一项操作都会产生报告,比如手术报告、病理报告。
- 治疗阶段:几轮化疗、手术或放疗,每一轮都有报告。
- 缓解后随访:定期复查,比如看家庭医生,每次又产生报告。
- 如果疑似复发,又回到诊断阶段。
5 年、10 年、50 年下来,这些文档本可以拼出患者完整的健康史。
各自孤立、满是术语、专家不够
实际上,一段癌症就医历程里的文档很少能拼成这样的健康史:
- 各自孤立:每份报告只是为了做眼前下一步的局部决策,很少按时间串联起来。
- 满是术语:只有专家才能解读。
- 专家不够:医疗资源有限,等专家一份份读报告,可能耽误对时间敏感的治疗。
课程给出的方向是 NLP 辅助技术:用 NLP 和机器学习自动从临床文档中抽取关注字段(fields of interest)。这些字段能支持一系列下游任务:发现癌症、判断诊断分组(乳腺癌、结肠癌、白血病等)、根据既往病史预测治疗反应,以及做风险分层,让高风险病例优先、尽快得到治疗。
一份报告,三个难点:字段、专家与否定
课上的例子是一份乳腺癌手术病理报告。报告不长,但信息很密,有好几个部分,病理医生在最终诊断里列了好几条。计算机应该找到的关注字段包括:
| 问题 | 报告里怎么写 |
|---|---|
| 有没有癌? | 浸润性导管癌 |
| 有多严重? | Nottingham 评分 9 分中的 8 分,即 3 级 |
| 多大,在哪里? | 肿瘤大小,以及位于标本的上半部分 |
| 有没有侵入血管? | 无淋巴血管侵犯 |
这份报告同时展示了三个难点:
- 字段分散。 每个字段出现在哪里,取决于写报告的医生怎么写。
- 解读要靠专家。 NLP 可以自动回答这些问题,这就是自然语言理解和问答。
- 否定。 淋巴血管侵犯是癌症严重程度的标志性表现,而这份报告明确写的是没有。关键词搜索能找到这个词,意思却正好弄反。这里的“无”就在词的前面,但否定的写法可以有很多种:报告可能先说检查了淋巴血管侵犯,五句话之后才写“没有证据表明”。把这句话和前面的词联系起来(指代消解),也是理解文本的一部分。
抽取出来的字段会被填进结构化的表格,比如 Excel 表或 EHR,用来支持上面那些下游分析。下一课会讲这些抽取出来的字段怎样帮助改善患者照护。
我的思考
其实这一期,也是我为什么会开始对 NLP 在医疗中的实际应用很感兴趣的原因。作为一个多年在学术研究环境里工作的人,我经常会想:这些研究真正的意义是什么?怎样才能真的帮助到大众?我不觉得大众会看发表的论文,这不是大众获取信息的传统渠道;这些论文更多是“圈子里”的人的语言。而在工作中我慢慢发现,在真实世界里,研究也可以和大众联系在一起。比如我们的临床试验会问参与者:如果有了研究成果,是否愿意让我们跟进告知。这让我对“学术研究”本身有了进一步的认识。
参与了各种各样的研究后,我也发现临床里记录信息的方法有很多种。EHR 里典型的记录是结构化数据,就像选择题;而临床笔记由各种医护人员(医生、护士、社工)记录,基本都是开放式的自由文本,在实际操作中会记录很多“原因”(reason)方面的信息。以前分析这些信息比较难,但随着 NLP 的发展,这类信息开始可以被利用起来了。
学习来源与资源
这篇笔记基于我在英属哥伦比亚大学(UBC)微证书项目“用自然语言处理改善患者照护”(Natural Language Processing to Improve Patient Care)中学习课程 Extraction and Analysis of Clinical Documents 的笔记(模块一,Raymond Ng 主讲的“Overview and Motivations”一课)。技术细节核对了:
- Christopher W. Elston 与 Ian O. Ellis(1991),Pathological prognostic factors in breast cancer. I. The value of histological grade in breast cancer,Histopathology(Nottingham 分级系统:8–9 分为 3 级)。
- Wendy W. Chapman 等(2001),A simple algorithm for identifying negated findings and diseases in discharge summaries,Journal of Biomedical Informatics(NegEx,处理临床否定表达的经典规则方法)。
动手试试
- medspaCy:开源的临床 NLP Python 库。它的 ConText 组件会把抽取出的发现标成否定、不确定或既往,可以用自己的句子看看“无淋巴血管侵犯”这类问题。